FastH3 Trim : un MiniMax H3 élagué en 8 étapes pour les GPU 8 Go
FastVideo publie FastH3 Trim, un MiniMax H3 élagué à 42 blocs qui génère de la vidéo en 8 étapes avec audio dès 8 Go de mémoire GPU, avec des fichiers repackagés pour ComfyUI.
Ce que Trim change
Le H3 de base est constitué de trois réseaux : un encodeur de texte Qwen3-VL, un transformer de diffusion de 50 blocs qui débruitte ensemble les latents vidéo et audio, et deux VAE. En BF16, cela représente 137,7 GiB, ce qui ne tient pas sur une carte de 32 Go. FastH3 V2 l'a réduit par quantification ; Trim retire en plus des blocs.
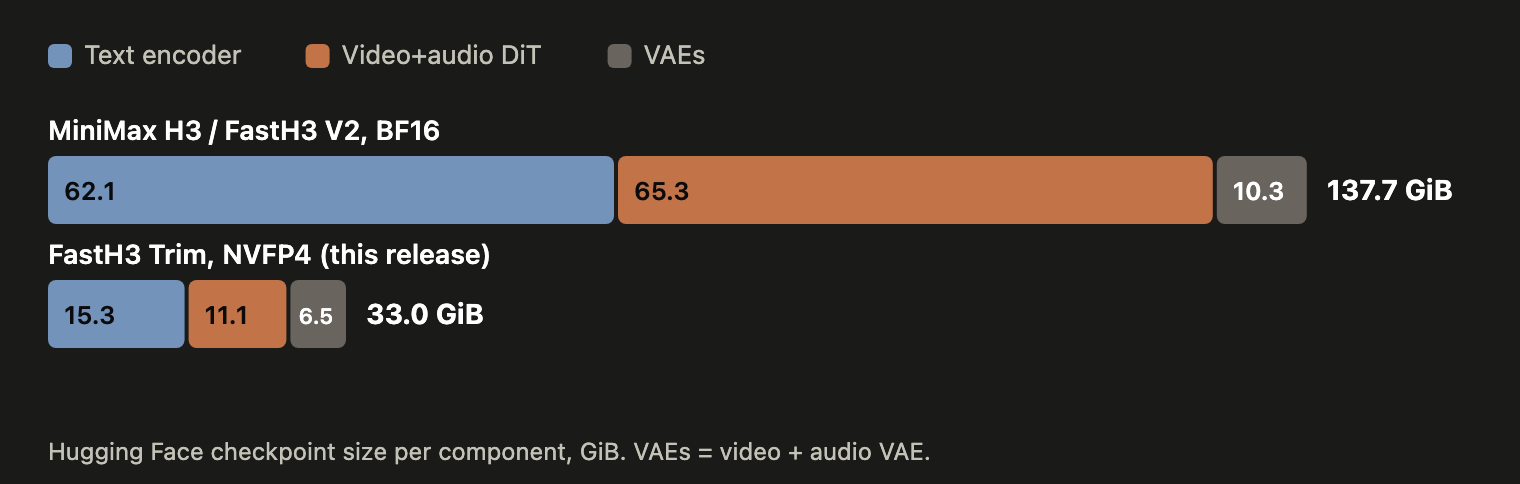
Taille du checkpoint par composant. Le H3 en BF16 fait 137,7 GiB ; la version NVFP4 de FastH3 Trim fait 33,0 GiB, avec le transformer à 11,1 GiB.
- Élagage des blocs : l'équipe a retiré un bloc à la fois du H3 de base et a enregistré l'ampleur de la variation des prédictions vidéo et audio, sur quatre types d'exemples (mouvement, parole, musique, événements sonores) à trois niveaux de bruit, soit 600 mesures. Chaque bloc a été classé selon le plus grand changement qu'il provoquait dans n'importe quelle condition, afin qu'un bloc important pour la vidéo comme pour l'audio soit conservé. Les huit blocs retirés se trouvent tous dans la première moitié du réseau ; les premiers et derniers blocs modifiaient le plus la sortie.
- Conditionnement du pas de temps : H3 conditionne chaque bloc sur le pas de diffusion via une projection AdaLN qui mappe un embedding temporel de 2 688 dimensions vers six vecteurs de modulation, et ces projections occupent 24 GiB en BF16 sur 50 blocs. Trim les remplace par une base partagée de 2 688 vers 16 plus une petite projection par bloc, stockée en FP16 car le BF16 produit une erreur de reconstruction environ 1,7 fois plus grande.
- Entraînement : le nouveau modèle à 42 blocs a été entraîné directement avec DMD2 en huit étapes en utilisant l'objectif de FastH3 V2. Le H3 de base initialise à la fois le teacher gelé et le critic entraînable, l'attention est éparse à 80 %, et le sampler progresse par pas de 999, 874, 749, 624, 500, 375, 250 et 125.
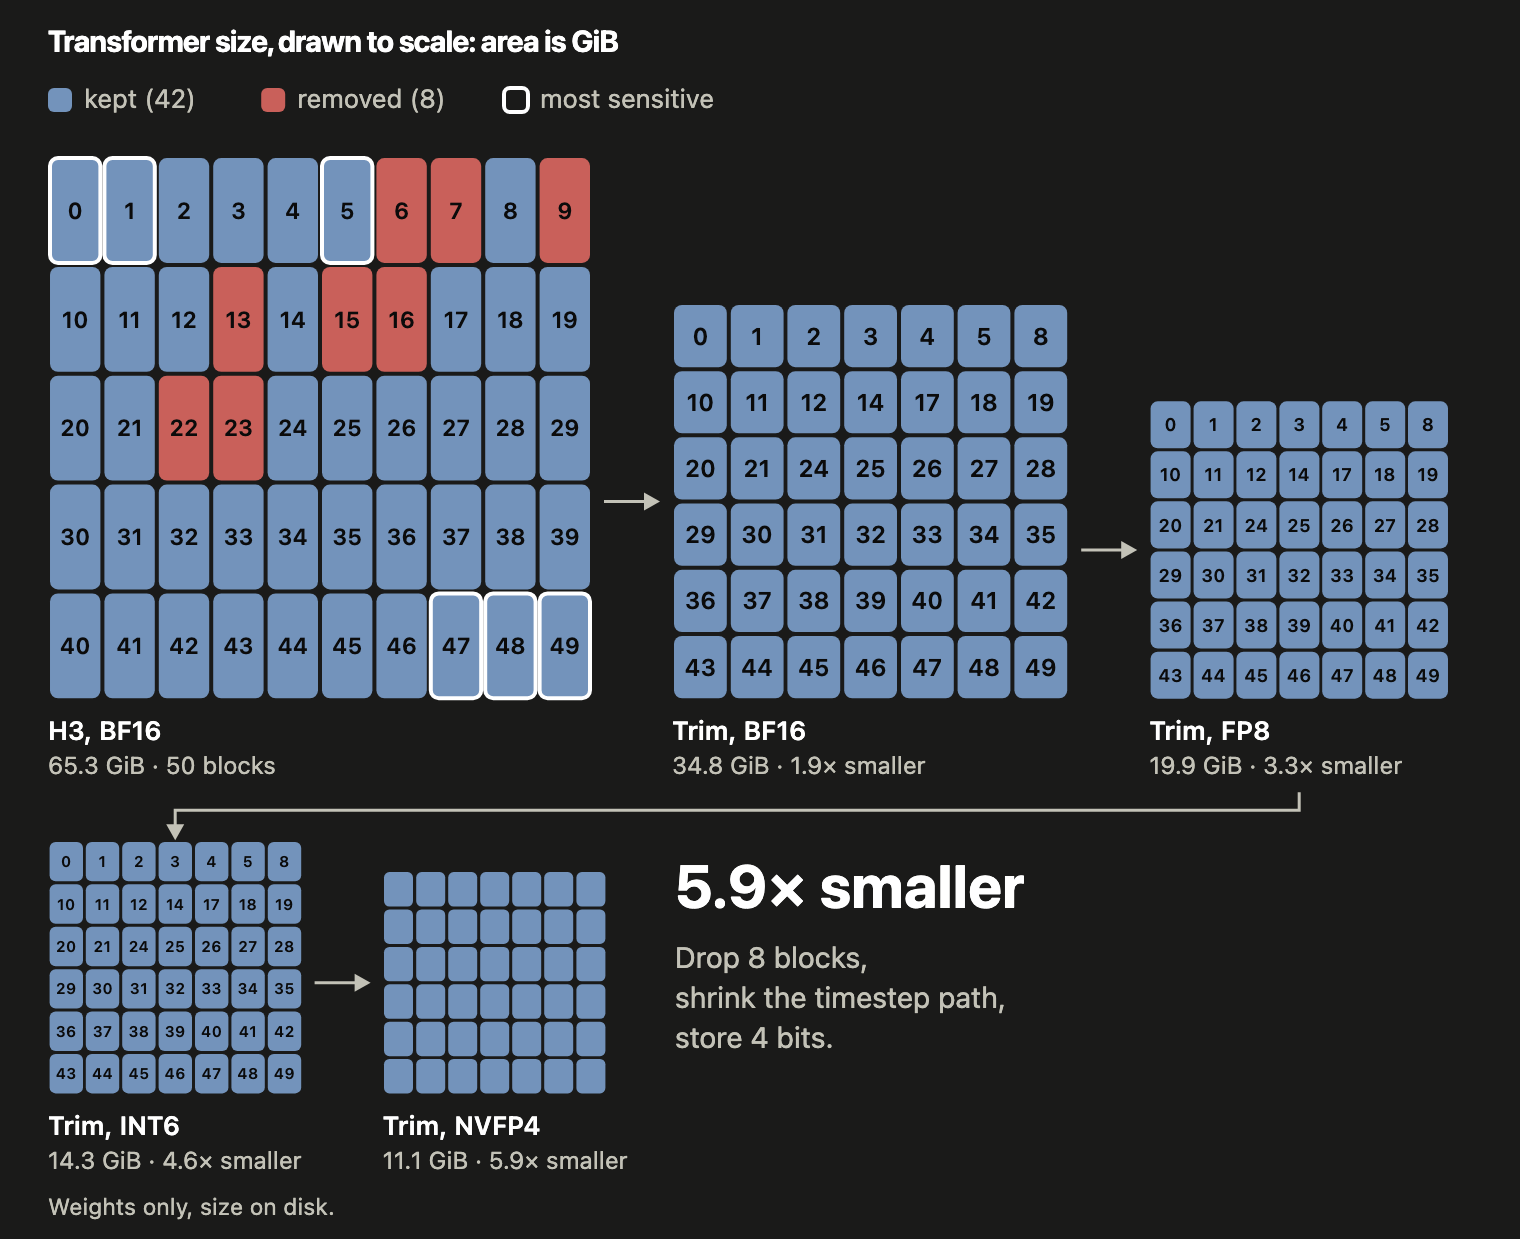
Le transformer FastH3 Trim dans chaque format distribué, à l'échelle : la surface représente la taille du checkpoint.
Contenu du repack ComfyUI
La version est reconditionnée pour ComfyUI dans FastVideo/FastVideo-FastH3-Trim-Comfy. Choisissez un fichier de modèle de diffusion plus un encodeur de texte correspondant :
| Modèle de diffusion | Taille | À utiliser sur |
|---|---|---|
fastvideo_fasth3_trim_8step_nvfp4.safetensors | 11,9 Go | NVIDIA Blackwell : série RTX 50, RTX PRO 6000, DGX Spark |
fastvideo_fasth3_trim_8step_fp8.safetensors | 19,7 Go | NVIDIA Ada et plus récents : série RTX 40 |
fastvideo_fasth3_trim_8step_int8_convrot.safetensors | 18,9 Go | Tout GPU NVIDIA récent ; correspond à la valeur par défaut du modèle |
fastvideo_fasth3_trim_8step_bf16.safetensors | 37,5 Go | Qualité de référence, ou pour convertir vers d'autres formats |
Le dépôt contient aussi les encodeurs de texte Qwen3-VL (BF16, INT8 ConvRot, NVFP4 AWQ) et les VAE vidéo et audio de MiniMax H3. Chaque couche NVFP4 utilise des échelles d'activation calibrées sur 1 000 prompts, et Trim compte 294 couches calibrées.
L'exécuter dans ComfyUI
Utilisez le modèle FastVideo FastH3: Text to Video fourni avec ComfyUI (0.36.0 ou ultérieur) et choisissez l'un des modèles de diffusion Trim dans son UNETLoader. Conservez les paramètres du sampler du modèle : 8 étapes, res_multistep, simple, et le nœud MiniMaxH3SigmaShift à 10 pour la vidéo et 3 pour l'audio.
Vitesse d'exécution
Temps de bout en bout en secondes pour un clip de 5 secondes avec audio, médiane de deux exécutions sur chacun de deux prompts, d'après l'article du blog :
| Machine | V2, 480p | Trim, 480p | V2, 768p | Trim, 768p |
|---|---|---|---|---|
| RTX PRO 6000 96 Go | 13,5 | 12,0 | 36,5 | 32,5 |
| RTX 5090 32 Go | 14,8 | 13,4 | 38,6 | 35,4 |
| RTX 4090 24 Go | 54,6 | 43,9 | 154,6 | 132,8 |
| RTX 4090, limite 16 Go | 79,9 | 72,1 | 153,7 | 139,9 |
| RTX 4090, limite 12 Go | 91,2 | 74,1 | 170,7 | 147,1 |
| RTX 4090, limite 8 Go | - | 82,0 | - | - |
| DGX Spark 128 Go unifié | 141,4 | 125,8 | 340,1 | |
| 2x DGX Spark | 87,2 | 78,3 | ||
| Mac, M4 Max 36 Go unifié | 925,2 |
Les lignes 8 Go, 12 Go et 16 Go correspondent à la même RTX 4090 avec la mémoire GPU plafonnée ; une vraie carte dotée de moins de mémoire sera plus lente. Le blog note que sur la 4090, le chemin FP8 n'a pas de tensor cores FP4 à exploiter ; il contourne donc le matmul FP8 par token et par canal, plus lent, avec un kernel fusionné par tenseur plus une mise à l'échelle de la sortie, et quantifie les queries et les keys en INT8 pour le calcul des scores.
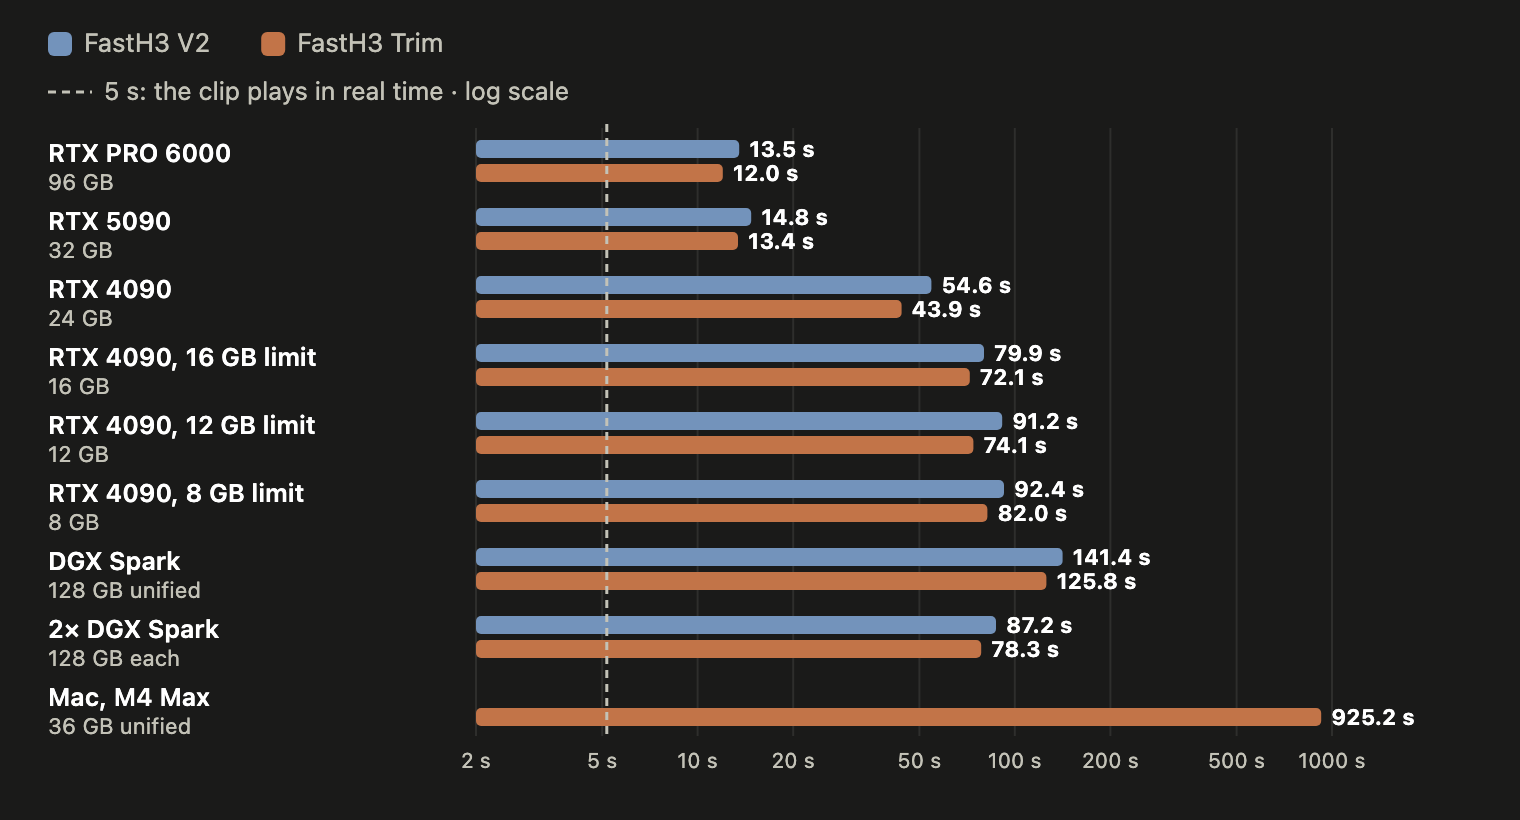
Temps de bout en bout pour un clip de 5 secondes en 832x480 avec audio, par machine.
Même prompt et même graine sur la RTX 5090, d'abord FastH3 V2 puis FastH3 Trim :
FastH3 V2 sur une RTX 5090.
FastH3 Trim sur la même RTX 5090, même prompt et même graine.
Limites
- Trim est étiqueté comme une expérience, et non comme le leader en qualité : le blog indique que retirer des blocs rend le modèle plus rapide et plus petit mais coûte un peu de qualité, et recommande FastH3 V2 lorsque la qualité est primordiale.
- Le chiffre de 8 Go est propre à Trim, en NVFP4, sur une carte à mémoire plafonnée. V2 ne tient pas dans 12 Go sur la configuration testée.
- Trim n'existe que pour la gamme FastH3 en huit étapes. Il ne modifie pas le modèle MiniMax H3 de base, qui nécessite toujours le transformer complet à 50 blocs.
- Le parcours ComfyUI dépend du modèle FastH3 fourni avec ComfyUI 0.36.0 ou ultérieur.
Disponibilité
Repack ComfyUI : FastVideo/FastVideo-FastH3-Trim-Comfy
Poids sources : FastVideo/FastVideo-FastH3-Trim-8-Step
Article de blog : FastH3 on Consumer Hardware
Code : hao-ai-lab/FastVideo
Équivalent qualité : FastVideo/FastVideo-FastH3-8-Step-V2
Modèle de base : MiniMaxAI/MiniMax-H3
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.