AcademiaSD LoRAlab : neuf entraîneurs LoRA derrière un seul lanceur
AcademiaSD LoRAlab Trainer Studio regroupe les entraîneurs LoRA pour Qwen-Image 2.1, FLUX.2 Klein, Krea 2, Z-Image, MiniMax-H3 derrière un seul lanceur, à partir de 4 Go de VRAM.
models/loras de ComfyUI.
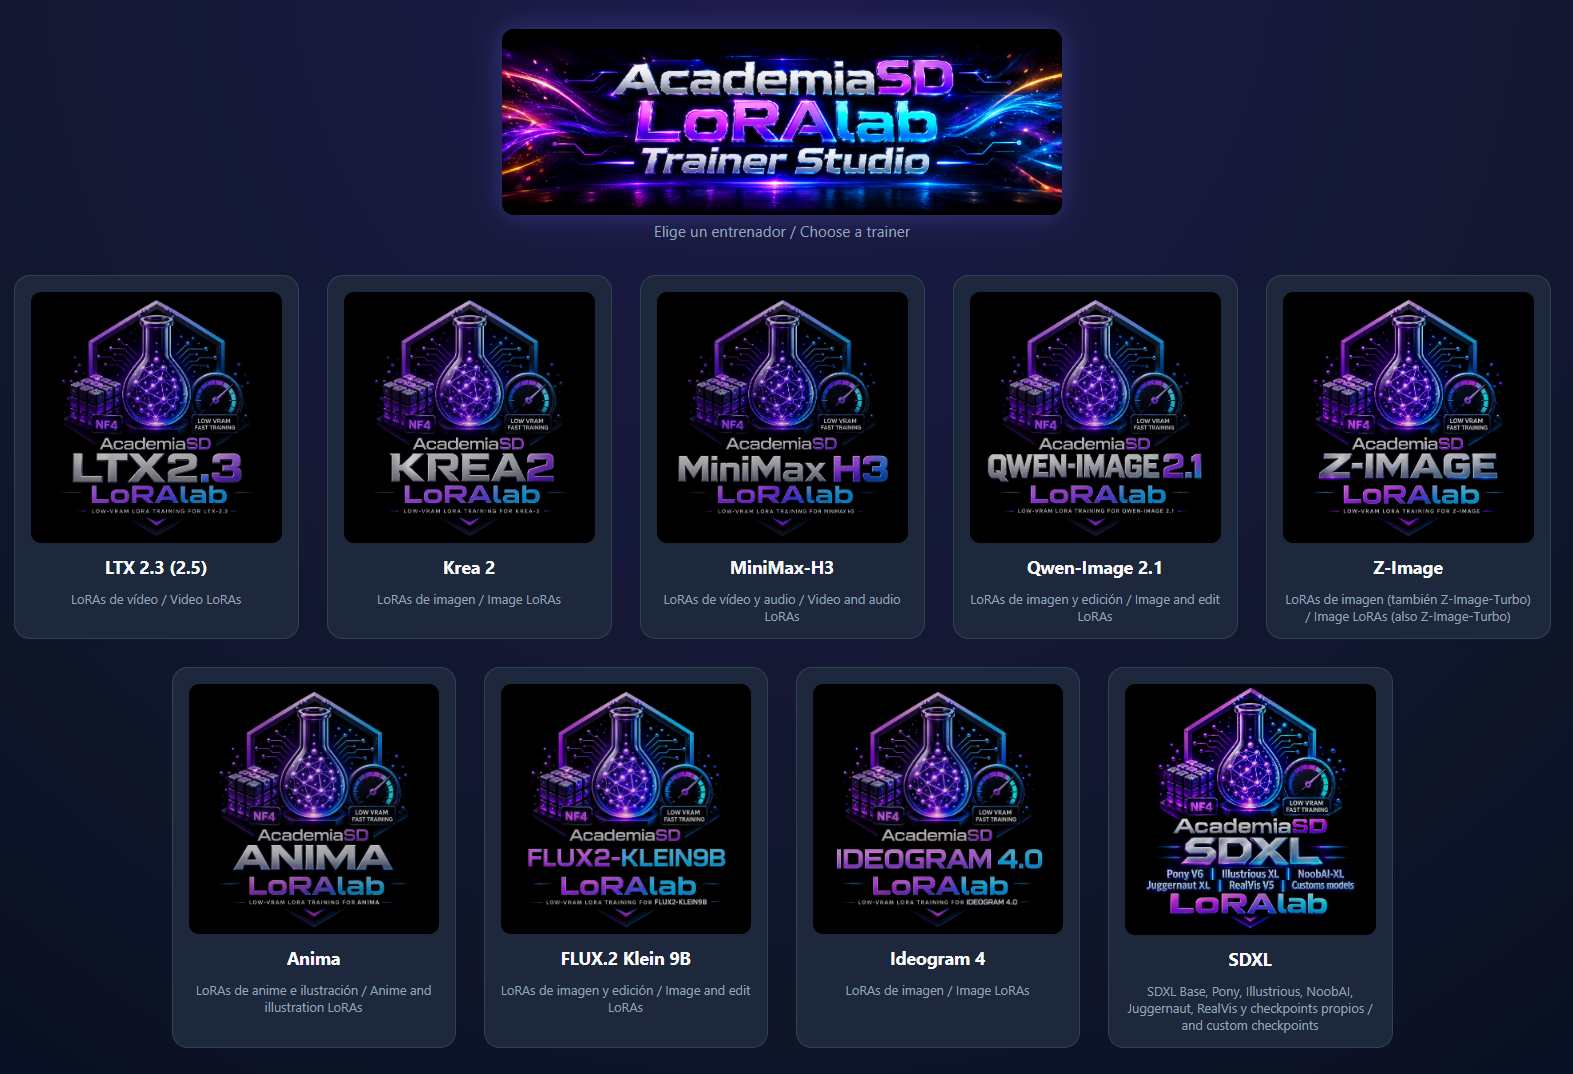
Le lanceur : choisissez un entraîneur et il s'ouvre dans le navigateur, tandis que les modèles, les projets et les paramètres restent partagés.
Ce qu'il entraîne, et avec combien de VRAM
| Entraîneur | Entraîne | VRAM minimale |
|---|---|---|
| Qwen-Image 2.1 | LoRAs de personnage, d'objet et de style, plus les LoRAs d'édition (avant → après) | 8 Go |
| Krea 2 | LoRAs de personnage, d'objet et de style pour Krea 2 Raw et Turbo | 8 Go |
| Z-Image | LoRAs de personnage, d'objet et de style pour Z-Image et Z-Image-Turbo | 8 Go |
| Anima | LoRAs de personnage et de style pour l'anime et l'illustration | 4 Go (NF4) / 6 Go (BF16) |
| FLUX.2 Klein 9B | LoRAs de personnage, d'objet et de style, plus les LoRAs d'édition | 12 Go |
| Ideogram 4 | LoRAs de personnage, d'objet et de style, avec des légendes JSON | 12 Go |
| SDXL | LoRAs pour SDXL Base, Pony, Illustrious, NoobAI et d'autres checkpoints SDXL | 4 Go (NF4) / 12 Go (BF16) |
| LTX-2.3 (et LTX-2.5) | LoRAs de personnage et de style pour le modèle vidéo LTX, entraînés à partir d'images | 12 Go |
| MiniMax-H3 | LoRAs vidéo à partir d'images, de clips et d'audio, plus des RefMods sans entraînement | 8 Go |
Le minimum requis est un GPU NVIDIA doté d'une capacité de calcul 7.5 ou supérieure (RTX 20xx / GTX 16xx et plus), un pilote de la série 580 ou plus récent pour CUDA 13, et 16 Go de RAM système. Les clips vidéo MiniMax-H3 nécessitent en plus ffmpeg dans le PATH. Les cartes GTX 10xx sont exclues : PyTorch pour CUDA 13 démarre à la génération RTX 20xx.
Une interface par entraîneur
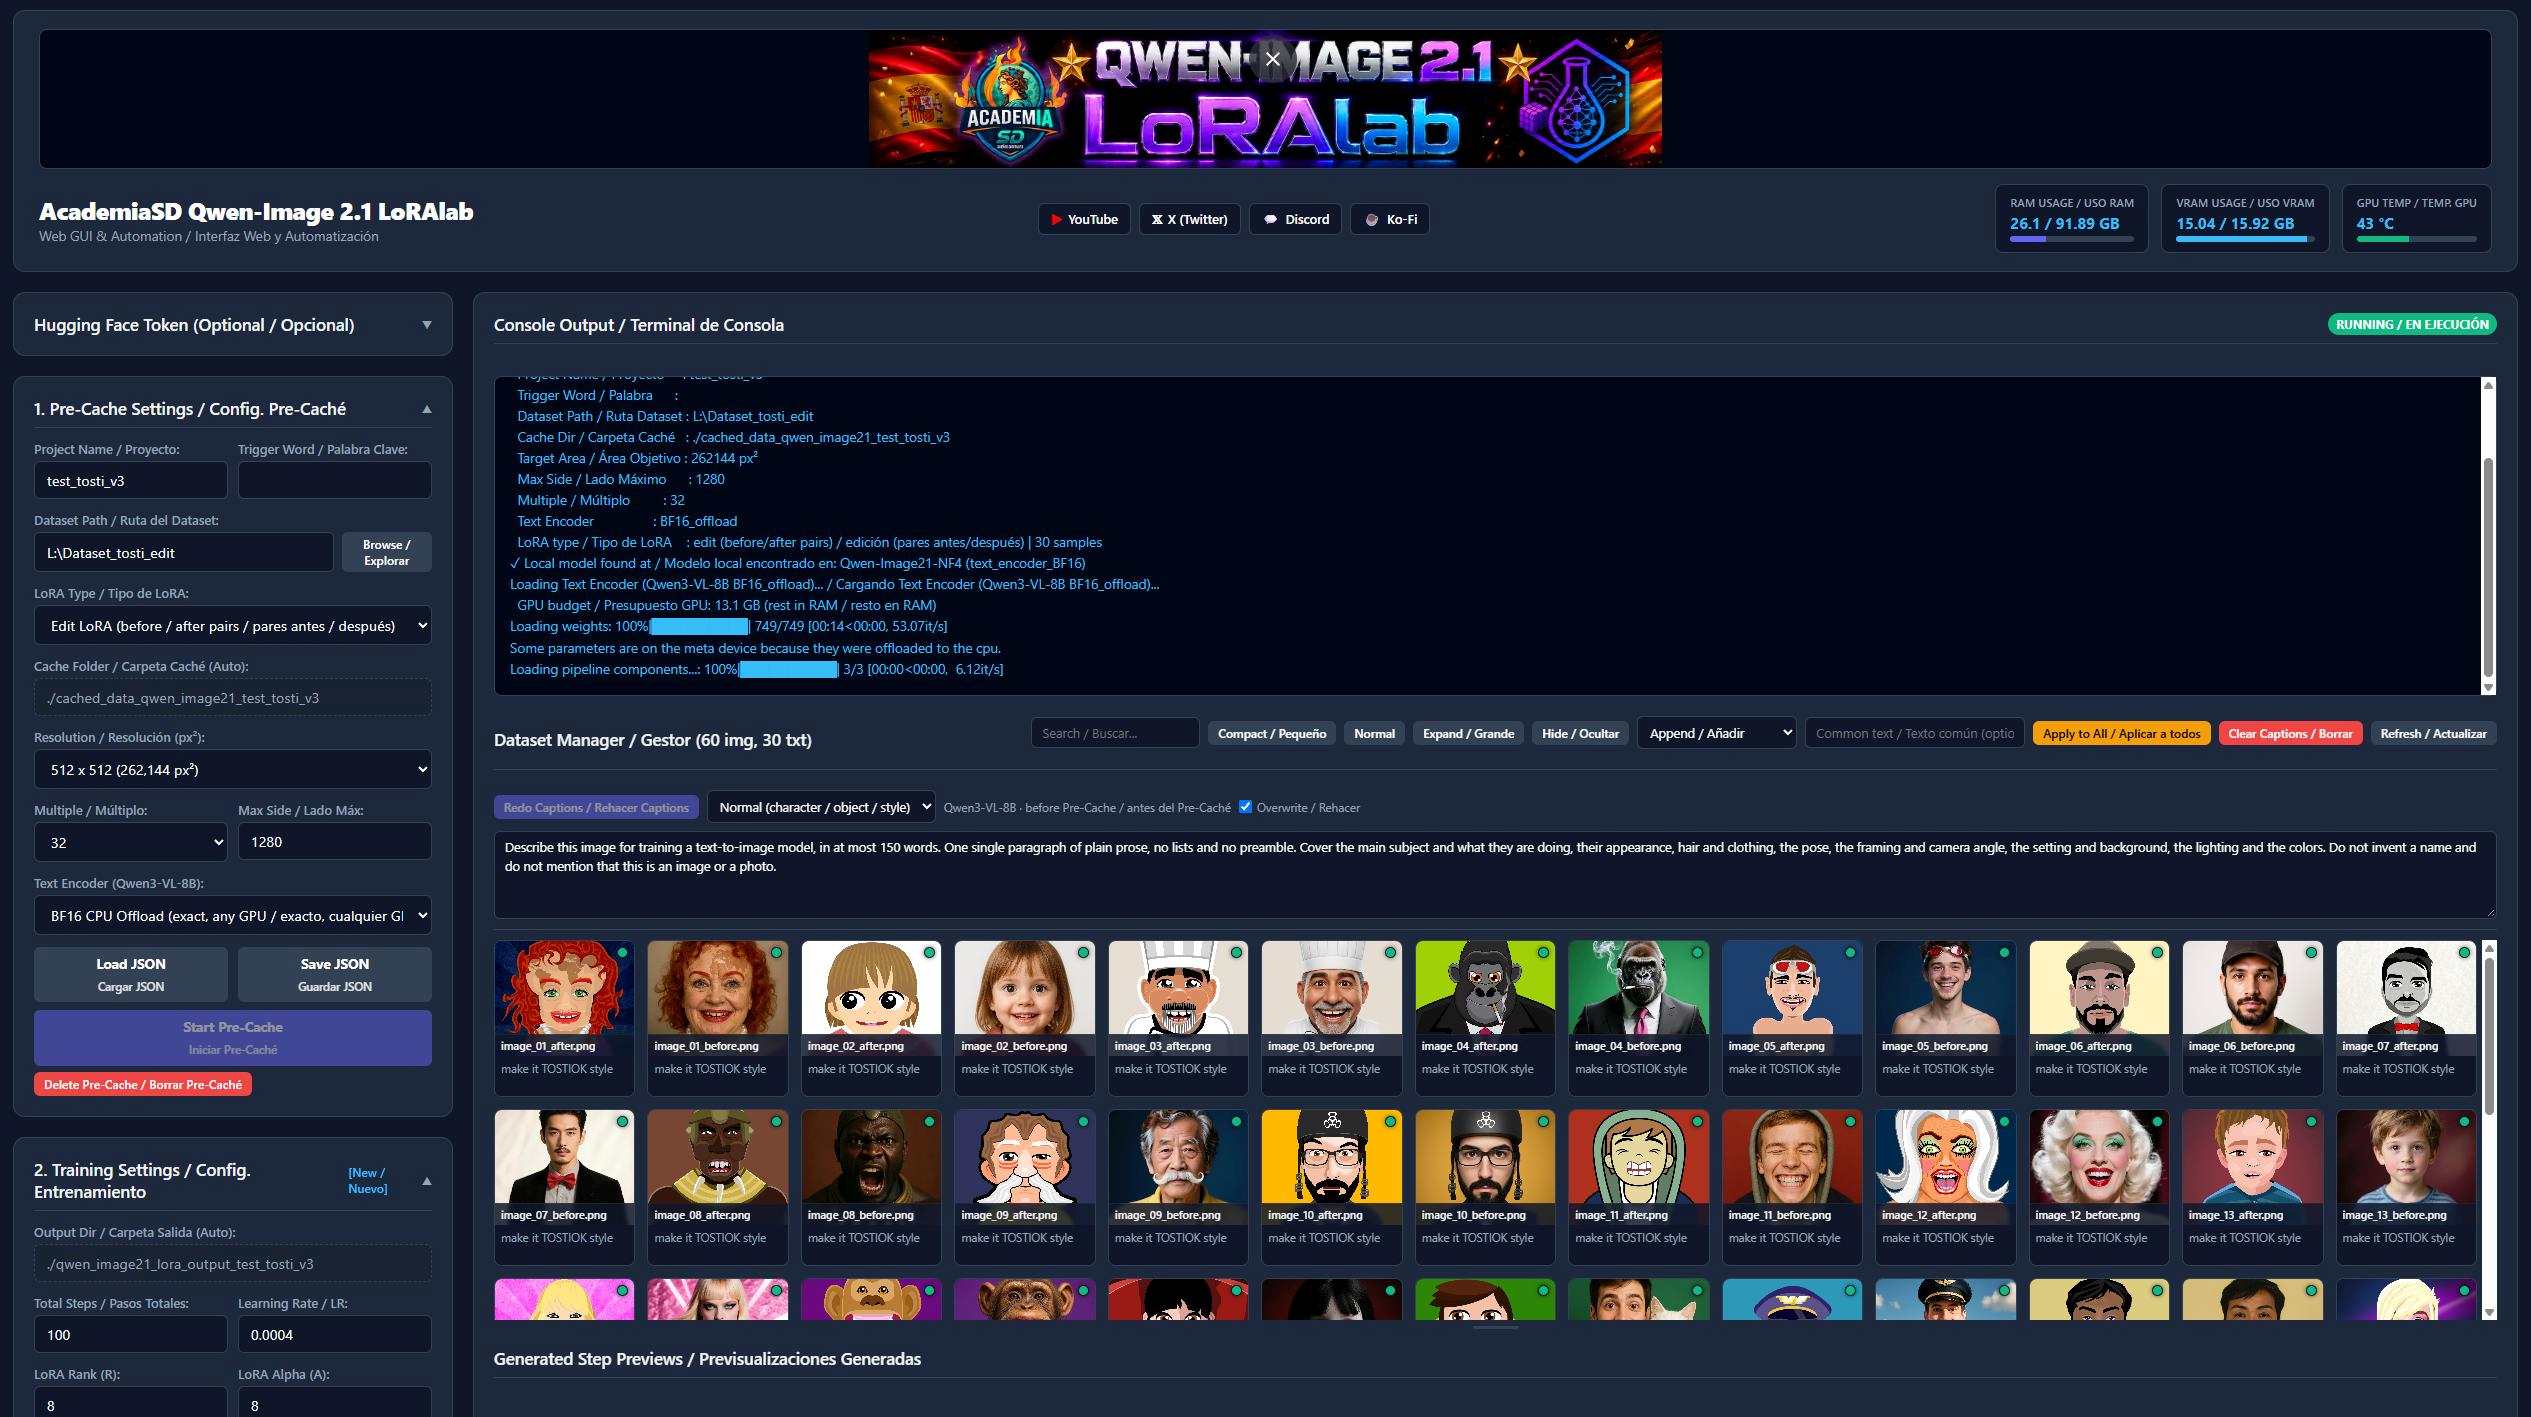
L'entraîneur Qwen-Image 2.1. Les neuf entraîneurs partagent les mêmes panneaux.
Chaque entraîneur suit les mêmes cinq étapes :
- Projet et jeu de données. Nommez le projet, ajoutez un mot déclencheur facultatif, indiquez un dossier de jeu de données. Chaque image a besoin d'une légende
.txtportant le même nom, et les images peuvent être glissées-déposées sous forme de dossier ou de.zip. - Légendes (facultatif). Un modèle vision-langage rédige une légende pour chaque image, avec le mot déclencheur en premier ; le prompt est modifiable et les légendes existantes sont conservées, sauf si vous les écrasez.
- Pré-cache. Le text encoder et le VAE s'exécutent une fois à la résolution de votre choix et leurs sorties sont stockées sur le disque. Une nouvelle exécution ignore les images qui n'ont pas changé, et ensuite 100 % du GPU est consacré à l'entraînement.
- Entraînement. Définissez les étapes, le taux d'apprentissage, le rang et l'alpha, puis lancez. Les paramètres peuvent être modifiés en cours d'exécution et s'appliquent à l'étape suivante, et Stop Training enregistre l'étape exacte, de sorte qu'un entraînement reprend des jours plus tard sans perdre une seule étape.
- Exportation.
Send to Modelscopie le LoRA dans un dossiermodels/lorasde ComfyUI (ou Forge / A1111) que le studio mémorise d'un entraîneur à l'autre. Les checkpoints intermédiaires peuvent aussi être téléchargés depuis le navigateur, et les LoRAs exportés portent des métadonnées de type kohya que Civitai et les gestionnaires de LoRA lisent.
Le studio fonctionne aussi depuis une autre machine sur le même réseau : le lanceur dispose d'un mode d'accès à distance avec un nom d'utilisateur et un mot de passe, de sorte qu'un jeu de données peut être téléversé depuis un ordinateur portable et le LoRA entraîné retéléchargé, sans toucher au PC d'entraînement.
Des aperçus nets pendant l'entraînement
Certains de ces modèles sont assez lents pour qu'il faille surveiller l'échantillonnage, et l'aperçu Latent2RGB par défaut de ComfyUI pour Qwen-Image 2.1, Krea 2 et FLUX.2 se présente sous forme de blocs de couleur. La paire recommandée dans le README est le KJNodes de kijai accompagné des minuscules autoencodeurs d'AcademiaSD dans ComfyUI/models/vae_approx/ : TAE-Qwen-Image-2.1, TAE-Krea-2 et TAE_Flux2_AcademiaSD, déposés dans le nœud Model Preview Override entre le modèle et l'échantillonneur.
Installer
Un installateur par plateforme, et un venv partagé pour tous les entraîneurs (PyTorch 2.14 sur CUDA 13.0, Diffusers depuis GitHub, Transformers, PEFT, bitsandbytes et Flask) :
git clone https://github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio.gitSous Windows, double-cliquez sur Install_LoRAlab-TrainerStudio.bat ; sous Linux, chaque .bat possède un équivalent .sh, et le lanceur choisit le bon. Install_Triton&SageAtten220.bat ajoute Triton et SageAttention 2.2 si vous le souhaitez. La mise à jour se fait avec un seul Update_LoRAlab-TrainerStudio.bat, qui conserve les modèles, les jeux de données, les projets et les paramètres. Le projet fournit également un modèle RunPod et une image Docker pour l'entraînement dans le cloud.
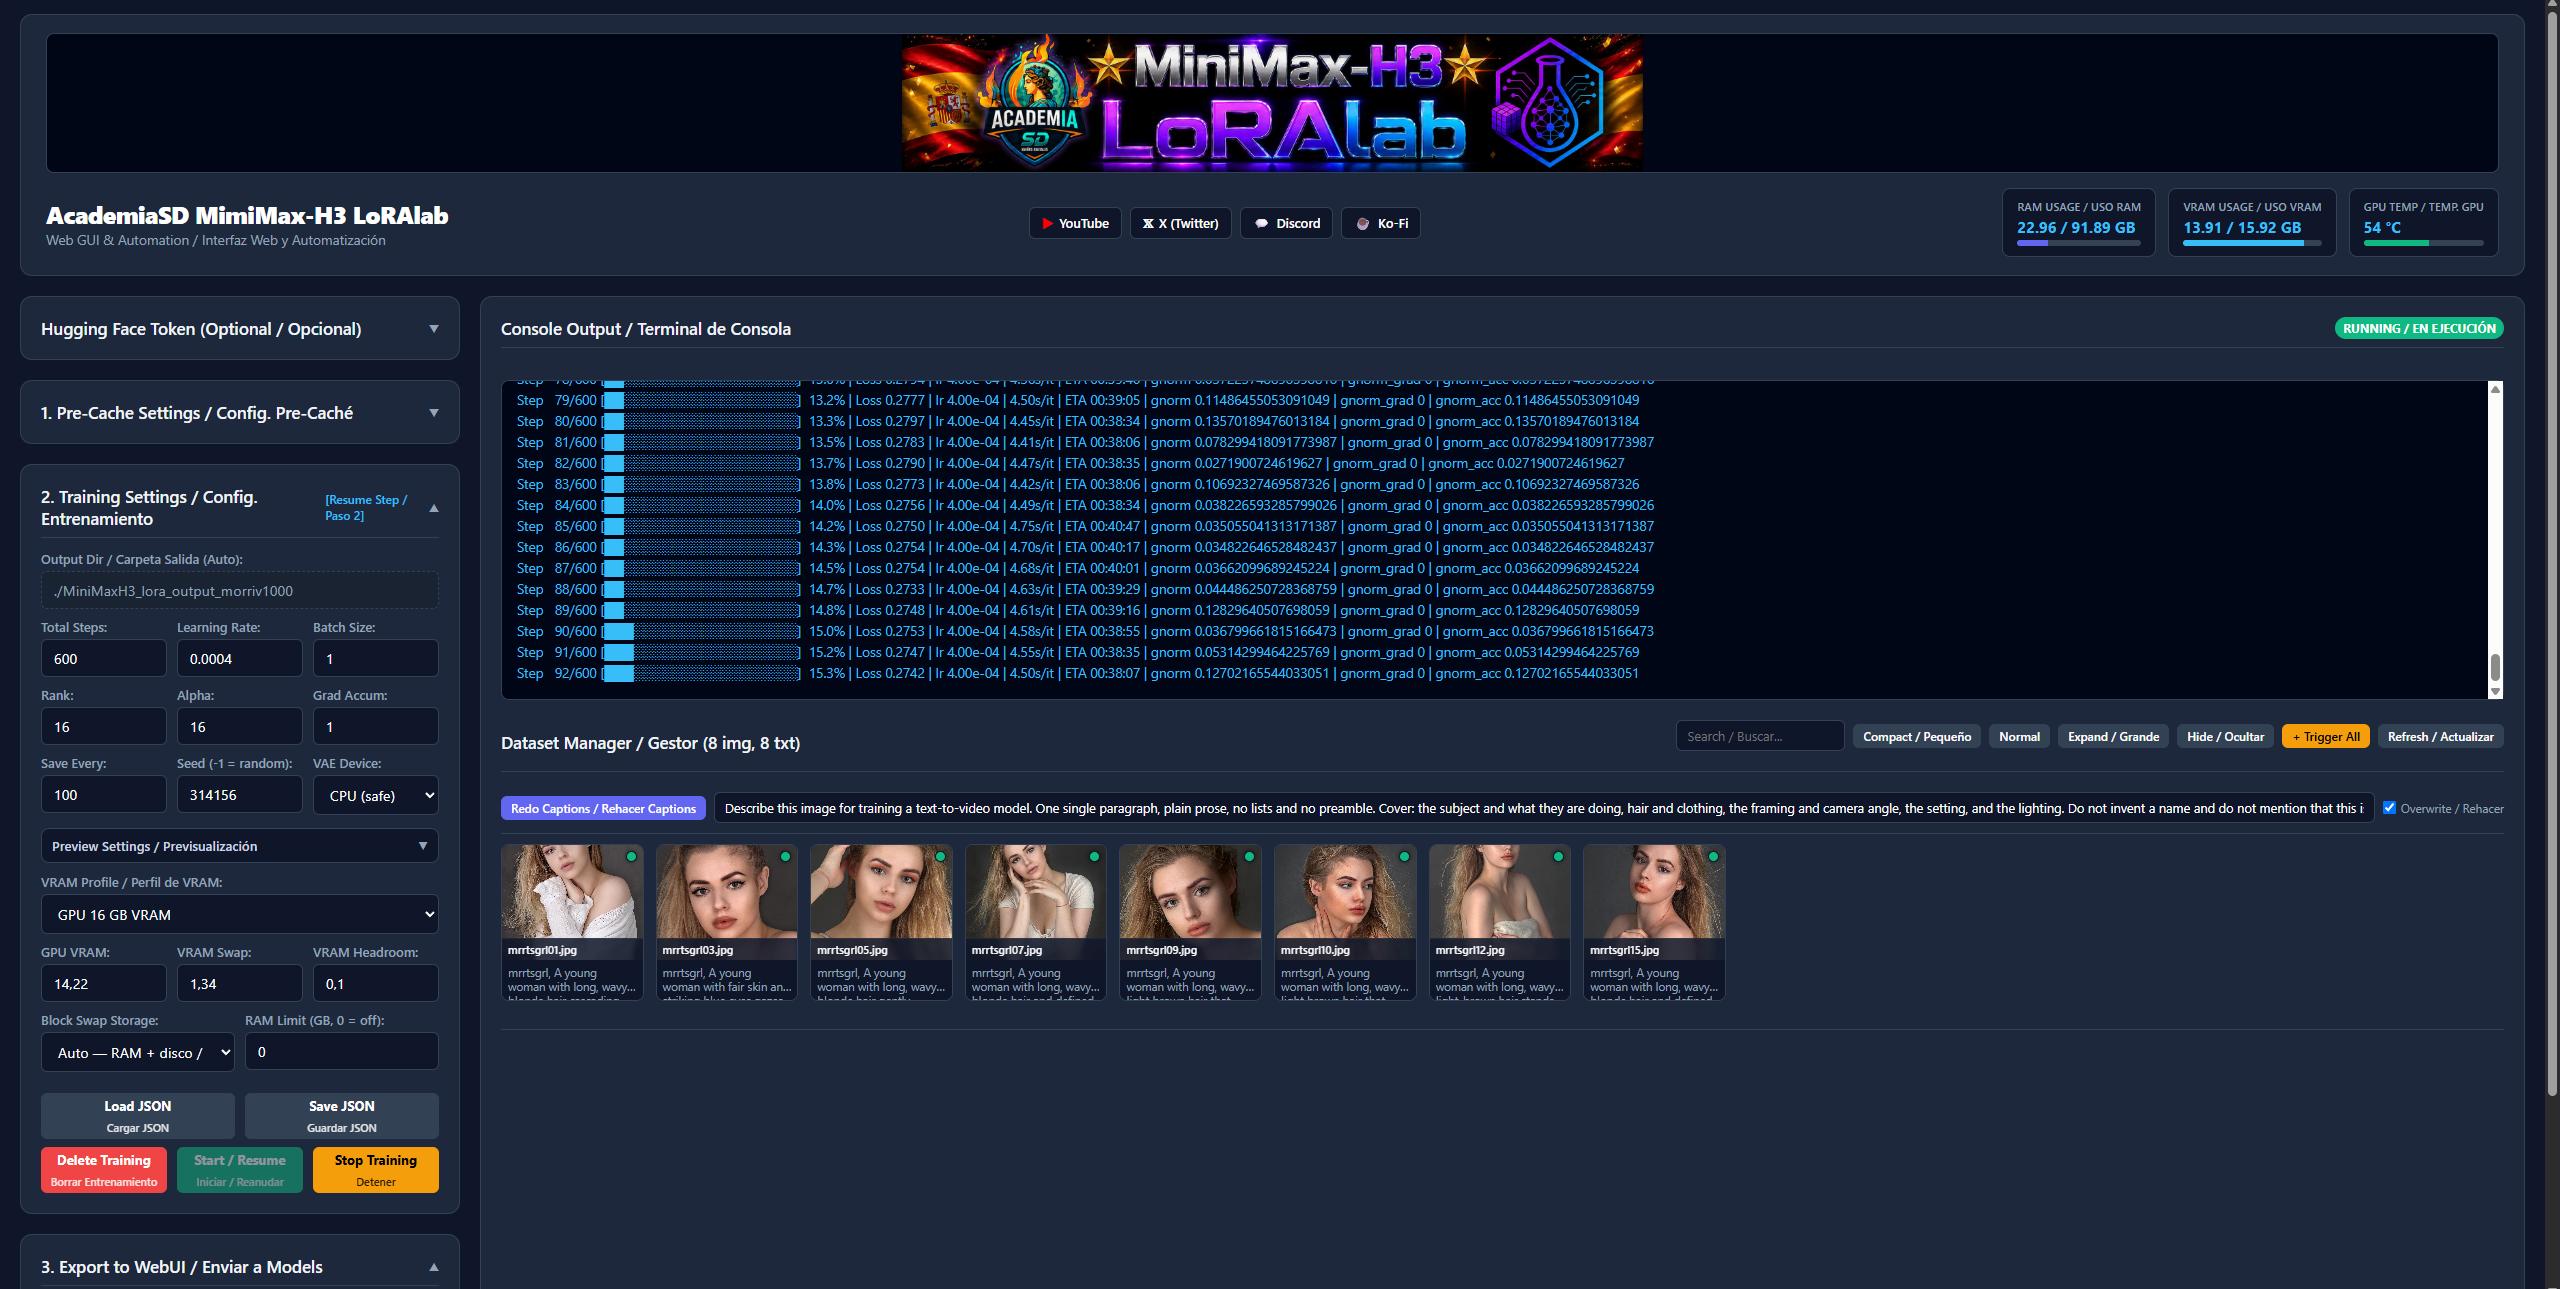
L'entraîneur MiniMax-H3, l'un des deux entraîneurs vidéo du studio.
L'auteur signale que le studio en est à ses débuts : les entraîneurs ont été ajoutés les uns après les autres très rapidement, de sorte que les paramètres d'entraînement et d'aperçu par défaut peuvent ne pas convenir à tous les modèles, et les problèmes sont le moyen prévu pour signaler ce qui ne fonctionne pas.
Disponibilité
AcademiaSD LoRAlab Trainer Studio est disponible à l'adresse github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio, avec des paquets d'entraînement pré-quantifiés tels que AcademiaSD/Qwen-Image-2.1-NF4-for-LoRA-Training sur Hugging Face.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.