FreeVideo : exécutez MiniMax H3 avec seulement 8 Go de VRAM
FreeVideo de FlashML exécute MiniMax H3 avec seulement 8 Go de VRAM, via un plugin ComfyUI et un lanceur Windows basé sur le modèle VDN-H3 en 8 étapes avec exécution FP8.
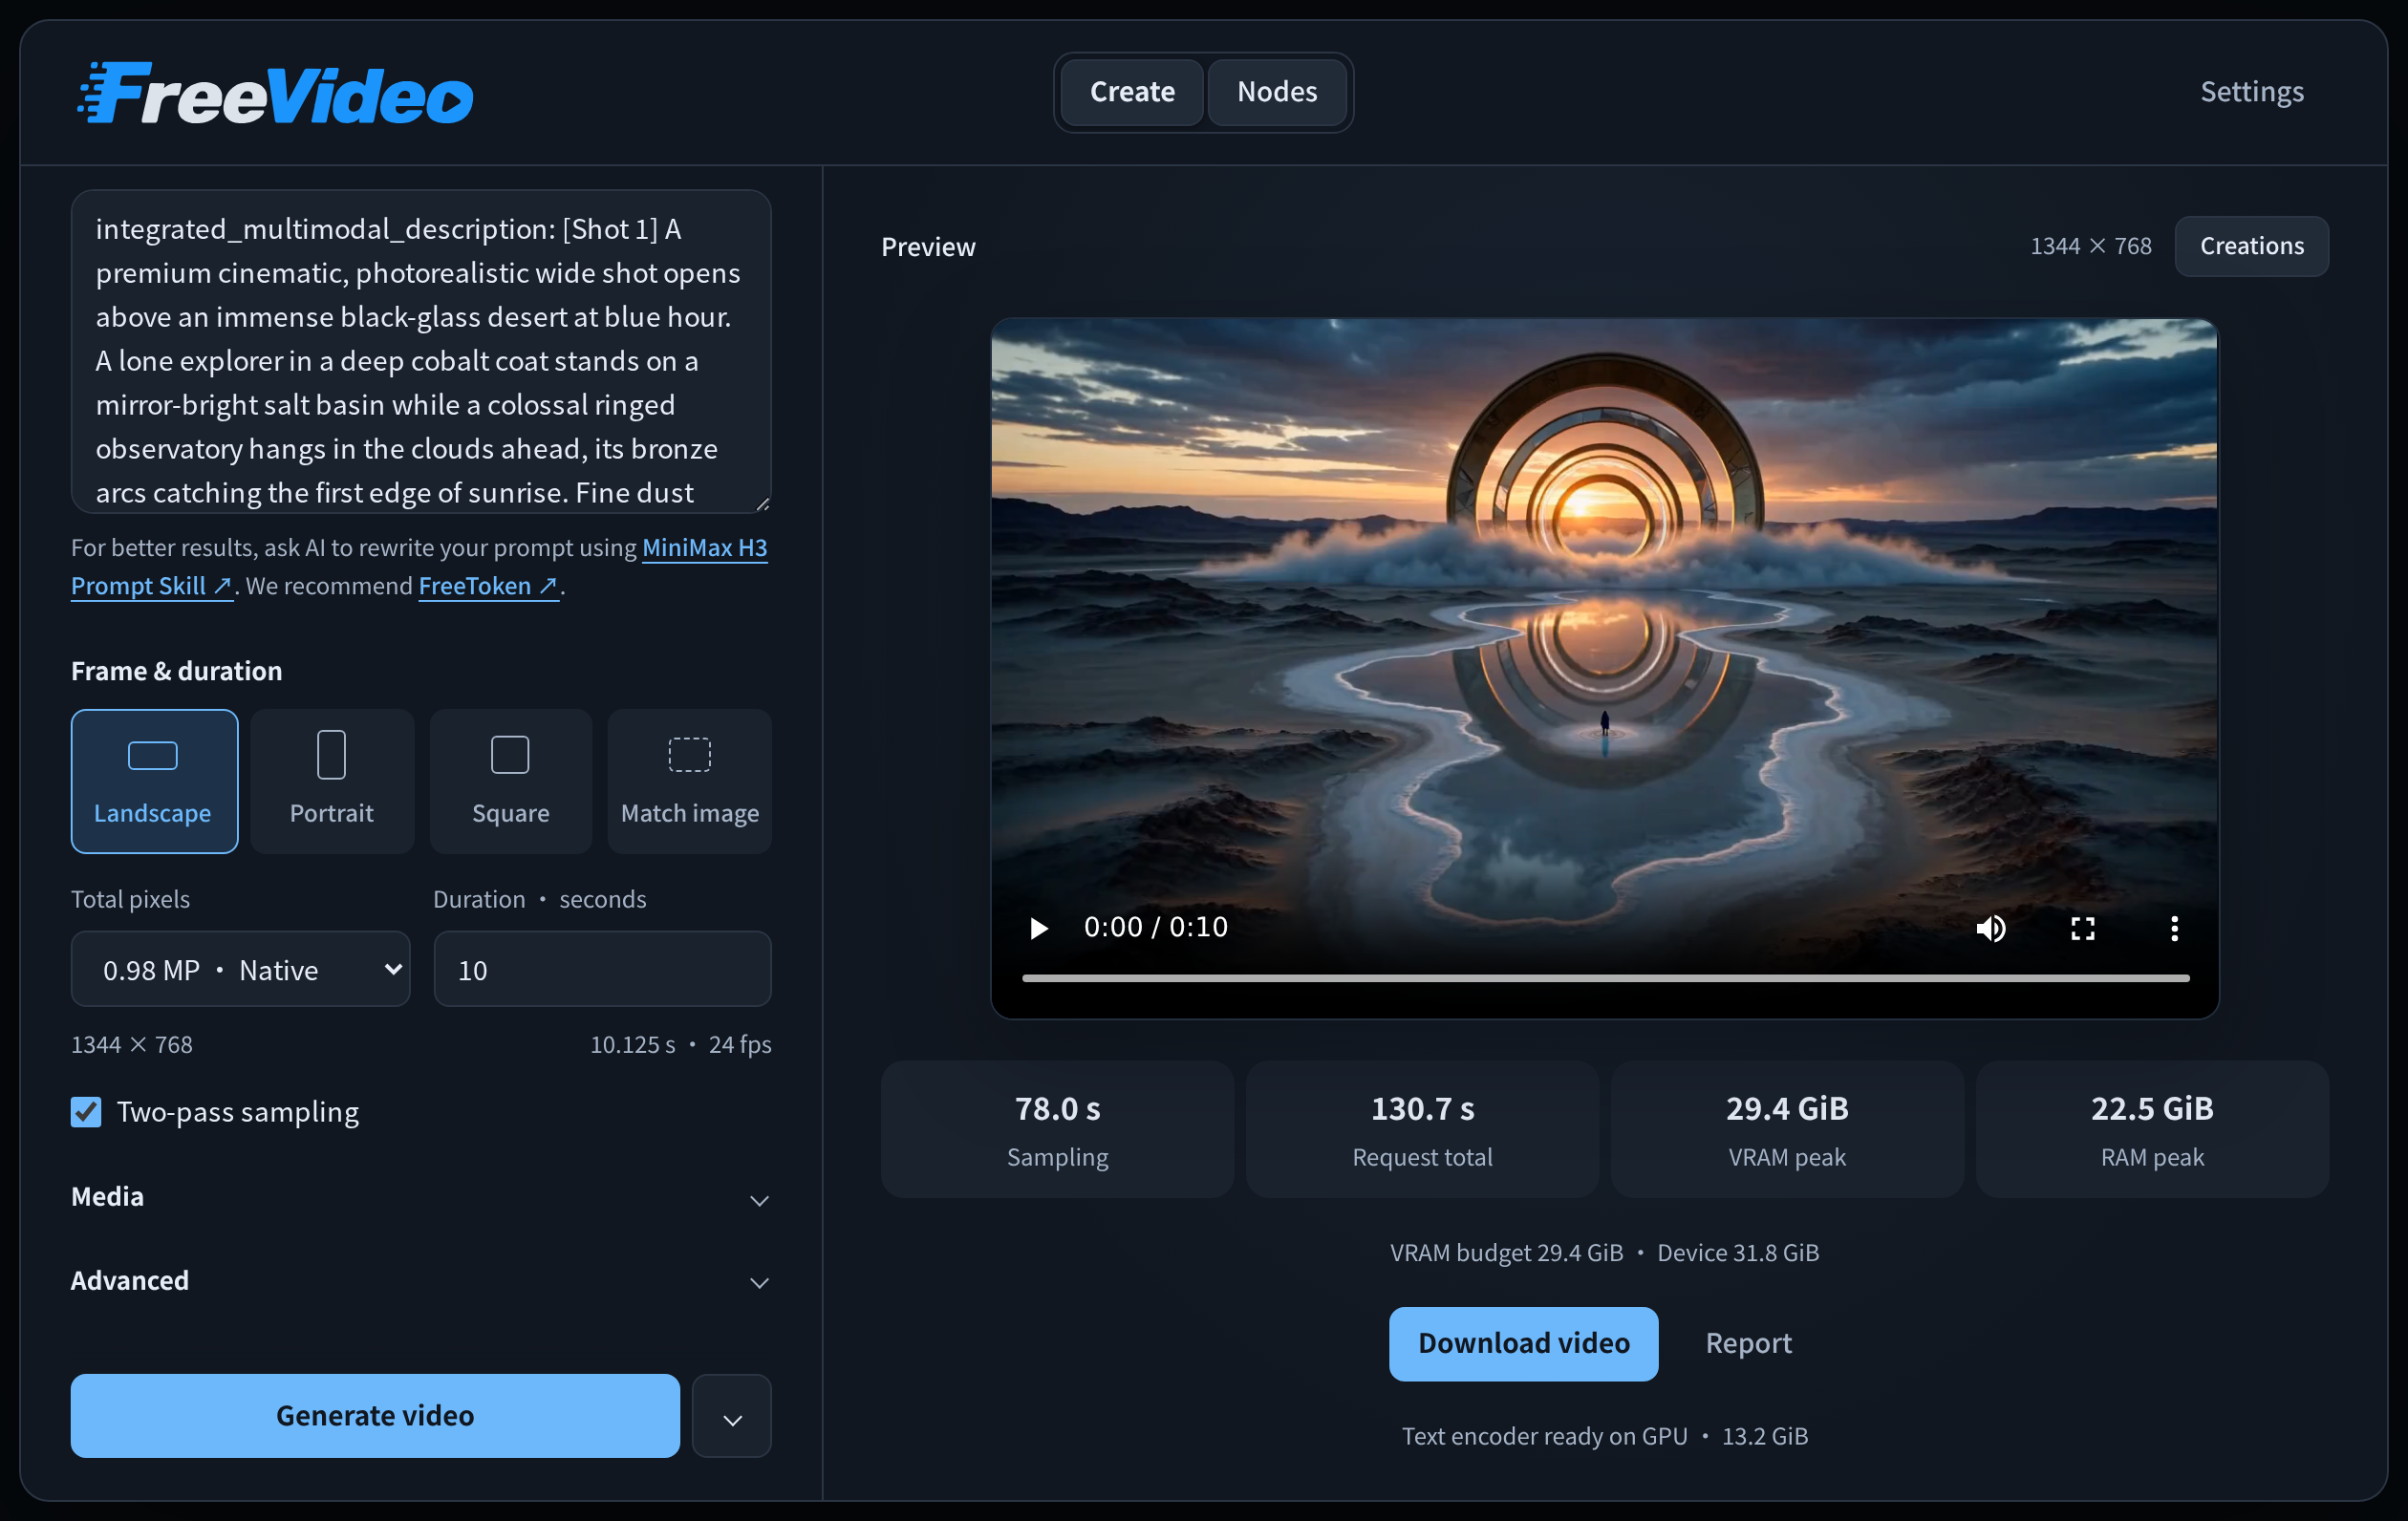
L'espace de travail FreeVideo dans ComfyUI. Une vue Nœuds est disponible pour les LoRAs et les modifications de flux de travail.
Basé sur VDN-H3
FreeVideo n'exécute pas le transformeur H3 dense. Il exécute le checkpoint VDN-H3 en 8 étapes d'OpenVDN, la refonte à attention hybride Video DeltaNet qui remplace l'attention longue portée quadratique de H3 par une branche linéaire (voir notre présentation de VDN-H3). FreeVideo empaquette ce modèle sous la forme de la version FP8 préparée vdn-minimax-h3-edge, environ 22,9 Go par format, et ajoute par-dessus un planificateur qui décide où réside chacun des 50 blocs du transformeur H3 au moment de l'exécution.
Exécution adaptative au matériel
Pour chaque requête, l'Adaptive Execution Planner mesure la VRAM libre, la mémoire hôte disponible et les résultats des sondes des noyaux d'attention, puis fixe :
- Résidence des blocs : combien des 50 blocs du transformeur restent en VRAM, combien résident dans la mémoire hôte épinglée (jusqu'à 22 Go) et combien sont lus depuis le disque à chaque étape.
- Chemin GEMM FP8 : échelles par tenseur sur Blackwell (SM120), échelles par canal sur Ada et Hopper, et poids FP8 avec calcul BF16 sur Ampere.
- Backend d'attention : le premier de SageAttention 2, PyTorch flash attention, cuDNN, FlashAttention 2 et FlashAttention 4 qui réussit sa sonde sur l'appareil.
- Placement du décodeur VAE : en dessous d'un budget de 20 Go, une partie des 36 blocs du décodeur reste résidente et le reste est diffusé en flux, les clips étant décodés en séquence.
Les budgets sont remesurés avant chaque requête, et les exécutions terminées stockent leurs temps et leurs pics de mémoire dans resource-history.sqlite3, que le moteur utilise pour basculer vers un placement plus rapide lorsque celui-ci est estimé au moins 2 % plus rapide.
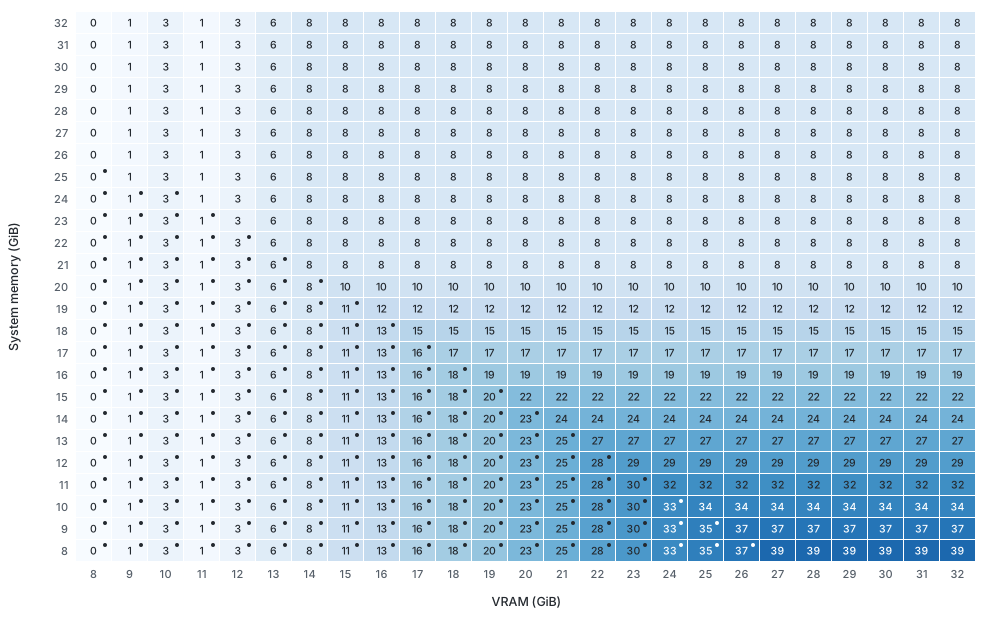 | 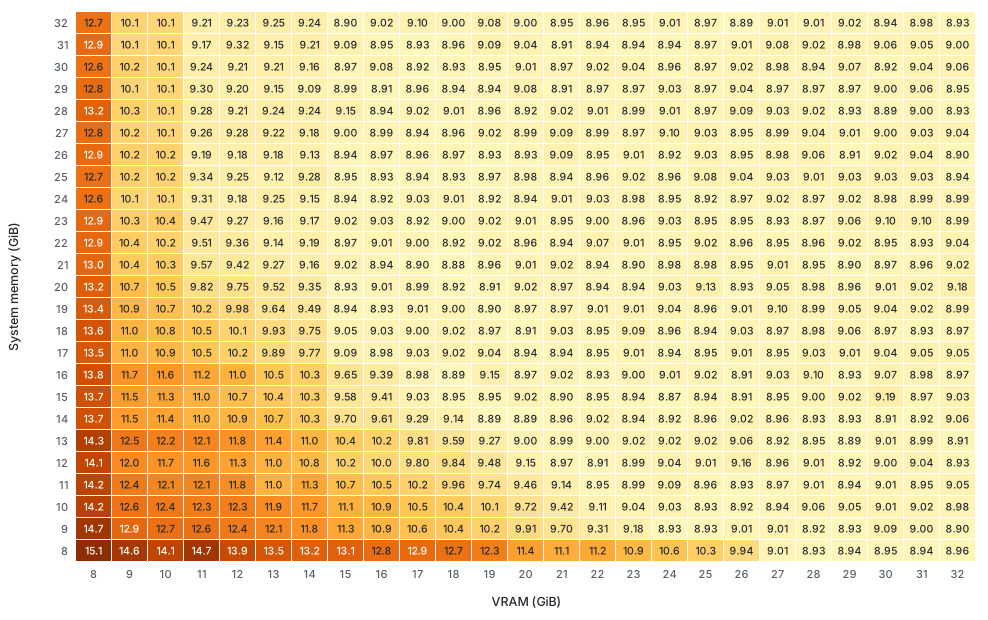 |
|---|---|
| Où résident les 50 blocs du transformeur à chaque budget de VRAM | Débit attendu par le planificateur à chaque budget de VRAM |
Ce qu'il exécute
- Invites textuelles vers vidéo avec audio
- Conditionnement par première et dernière image
- Références image, vidéo et audio
- LoRAs MiniMax H3 de la communauté dans le même flux de travail
- Échantillonnage en deux passes et génération par lot depuis l'espace de travail ComfyUI, avec un historique des créations passées
Commencer
Sous Windows, téléchargez FreeVideo.exe depuis la version windows-preview et exécutez-le. Le lanceur installe ComfyUI, le runtime et le pack de modèles correspondant à votre GPU, réutilise les dossiers de modèles existants et prend en charge l'installation hors ligne à partir de paquets téléchargés.
Pour ajouter FreeVideo à une installation ComfyUI existante :
cd ComfyUI/custom_nodes
git clone https://github.com/FlashML-org/FreeVideo.git
Redémarrez ComfyUI, ouvrez Flux de travail -> Parcourir les modèles -> FreeVideo -> FreeVideo-All-in-One, puis terminez la configuration dans les Paramètres de FreeVideo. Sous Linux, le référentiel propose également une CLI :
git clone https://github.com/FlashML-org/FreeVideo.git && cd FreeVideo
./setup.sh
./freevideo generate --prompt-file prompt.txt --out video.mp4
Le flux de travail d'exemple fourni est celui présenté dans le navigateur de modèles :
Disponibilité
FreeVideo se trouve sur github.com/FlashML-org/FreeVideo, et les poids FP8 préparés proviennent de OpenVDN/vdn-minimax-h3-edge, que le lanceur télécharge automatiquement pour l'architecture détectée.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.