DMAD : LoRA audio-vidéo MiniMax H3 en 4 étapes pour ComfyUI
ByteDance et Texas A&M publient DMAD, un LoRA de rang 128 qui réduit MiniMax H3 à quatre étapes pour la génération conjointe audio-vidéo, avec une conversion ComfyUI signée Kijai.
 |  |
|---|---|
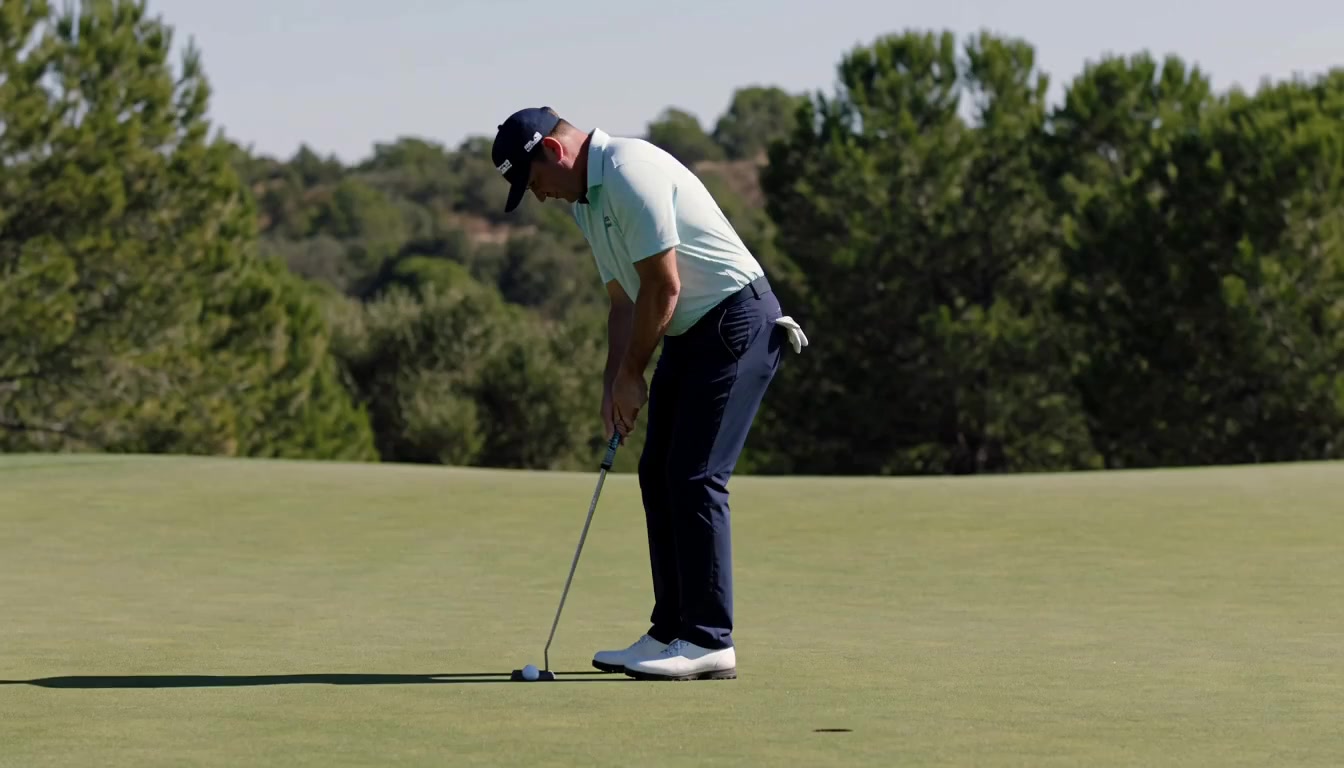
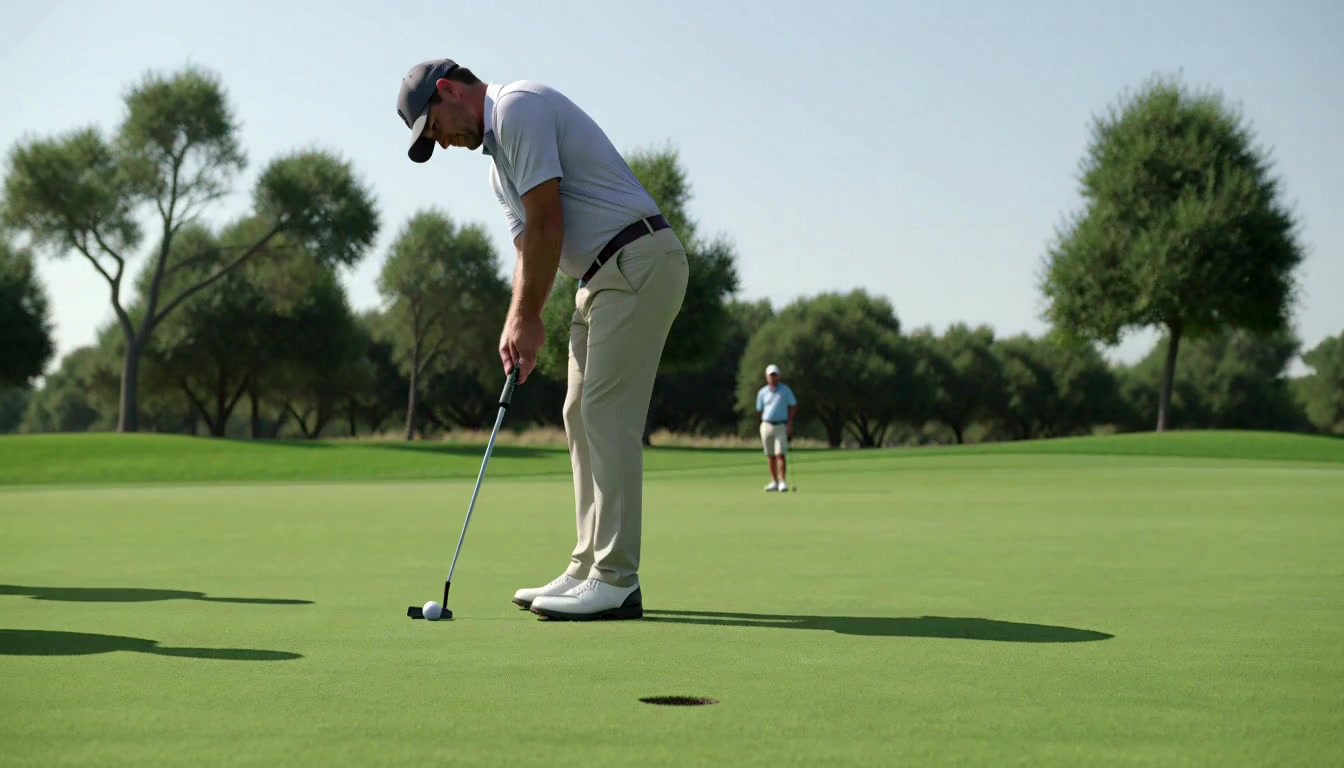
| Le teacher MiniMax H3 en 50 étapes | Le même prompt avec le student DMAD en 4 étapes |
Images correspondantes issues de la grille de comparaison MiniMax H3 de la page du projet. Le student conserve la composition et le sujet tout en fonctionnant en quatre évaluations du modèle au lieu de cinquante.
Ce que DMAD change
La distillation en quelques étapes pour la diffusion suit normalement DMD : on entraîne le student sur la différence entre les scores du teacher et ceux du student, ce qui implique de maintenir un second modèle de diffusion ajusté à la distribution évolutive du student, avec le coût en mémoire et en calcul que cela représente. DMAD supprime ce modèle auxiliaire.
La méthode reformule le distribution matching comme une classification. Deux têtes de discriminateur partagent un même backbone et sont entraînées à distinguer les échantillons réels et ceux du teacher de ceux du student. Des pertes linéaires sur les logits du discriminateur entraînent ensuite directement le student, sans ajustement de score. L'article montre qu'à l'optimum du discriminateur, ces pertes retrouvent le gradient de distribution matching sur lequel repose DMD, en s'appuyant sur l'identité qui relie les logits du discriminateur aux rapports de densité logarithmique.
Un second composant, la repondération basée sur l'écart (gap-based reweighting), fixe la force avec laquelle le teacher supervise chaque niveau de bruit. Il lit l'écart empirique de logits de la tête « données réelles » entre les échantillons réels et ceux du teacher, puis en adapte le poids, au lieu d'utiliser un programme fixe.
Ce qui a été publié
Cette publication se limite au volet MiniMax H3 de la méthode. Deux LoRA de rang 128 se greffent sur le transformer text-to-audio-video de H3, d'environ 1,4 Go chacun.
| Fichier | Description |
|---|---|
minimax_h3/dmad_minimax_h3_4step_lora_critic.safetensors | Le checkpoint de l'article : une EMA du student à l'itération 800 du run principal |
minimax_h3/dmad_minimax_h3_4step_full_critic.safetensors | Une variante dont le backbone du critique est entièrement entraîné plutôt que gelé sous un LoRA ; la carte annonce un score AVGen-Bench plus élevé |
Les deux adaptateurs portent un rang 128 et un alpha 128 sur les projections d'attention et les deux couches feed-forward des 50 blocs transformer et des 2 blocs token-refiner, soit 312 modules au total, dans la disposition de clés Diffusers (<module>.lora.down.weight, <module>.lora.up.weight). Les métadonnées safetensors enregistrent le rang, l'alpha et la règle de fusion.
L'inférence se fait en text-to-audio-video à quatre étapes, avec un time shift de 12 pour la vidéo et de 2 pour l'audio, sans classifier-free guidance, car MiniMax H3 est déjà distillé au niveau du guidance. La sortie par défaut est du 1344x768, 124 images (environ 5,2 s à 24 fps) avec un audio stéréo 32 kHz, la configuration sur laquelle les students ont été entraînés.
Résultats
L'article évalue la méthode sur trois backbones. Seuls les students MiniMax H3 sont publiés avec cette release ; les chiffres SDXL, EDM et Wan2.1 proviennent des propres runs de l'article.
| Backbone | Configuration | Score |
|---|---|---|
| SDXL | 4 étapes, COCO-10K | 14,47 FID |
| Wan2.1-T2V-14B | 4 étapes | 85,15 VBench total |
| MiniMax-H3-33B | 4 étapes, audio-vidéo conjoint | 79,1 % de préférence humaine globale par rapport à DMD2, 84,6 % par rapport à rCM (égalités exclues) |
Le résumé rapporte également un FID de 1,04 pour la génération en une seule étape sur ImageNet-64x64, avec un discriminateur projeté, et indique que les students en quelques étapes surpassent les méthodes few-step comparées et les teachers multi-étapes sur ces métriques.
L'exécuter dans ComfyUI
La release officielle cible Diffusers plutôt que les nœuds : inference.py échantillonne selon la règle de pas re-noise sous laquelle les students ont été entraînés, et run_diffusers_pipeline.py les intègre au MiniMaxH3ModularPipeline officiel. Le modèle de base est le transformer H3 de 33B plus son text encoder Qwen3-VL-32B, soit environ 170 Go de composants, et la référence recommande un GPU de 80 Go avec CPU offload au repos.
Pour ComfyUI, une fois convertis, les adaptateurs sont des LoRA ordinaires. Kijai a publié une conversion à rang réduit, minimax_h3_DMAD_4step_full_lora_avg_rank_39_bf16.safetensors sur Kijai/MiniMax-H3-experimental, qui se charge via le chemin LoRA H3 standard, sans nœud personnalisé. Des conversions communautaires du fichier diffusers d'origine circulent également, avec la réserve habituelle : les deux checkpoints et les paramètres de l'échantillonneur doivent correspondre à la carte.
Une loutre sur une planche de surf, générée par le student MiniMax H3 en 4 étapes. La vidéo et l'audio proviennent de la même passe en quatre étapes. Démo complète sur YouTube.
 |  |
|---|---|
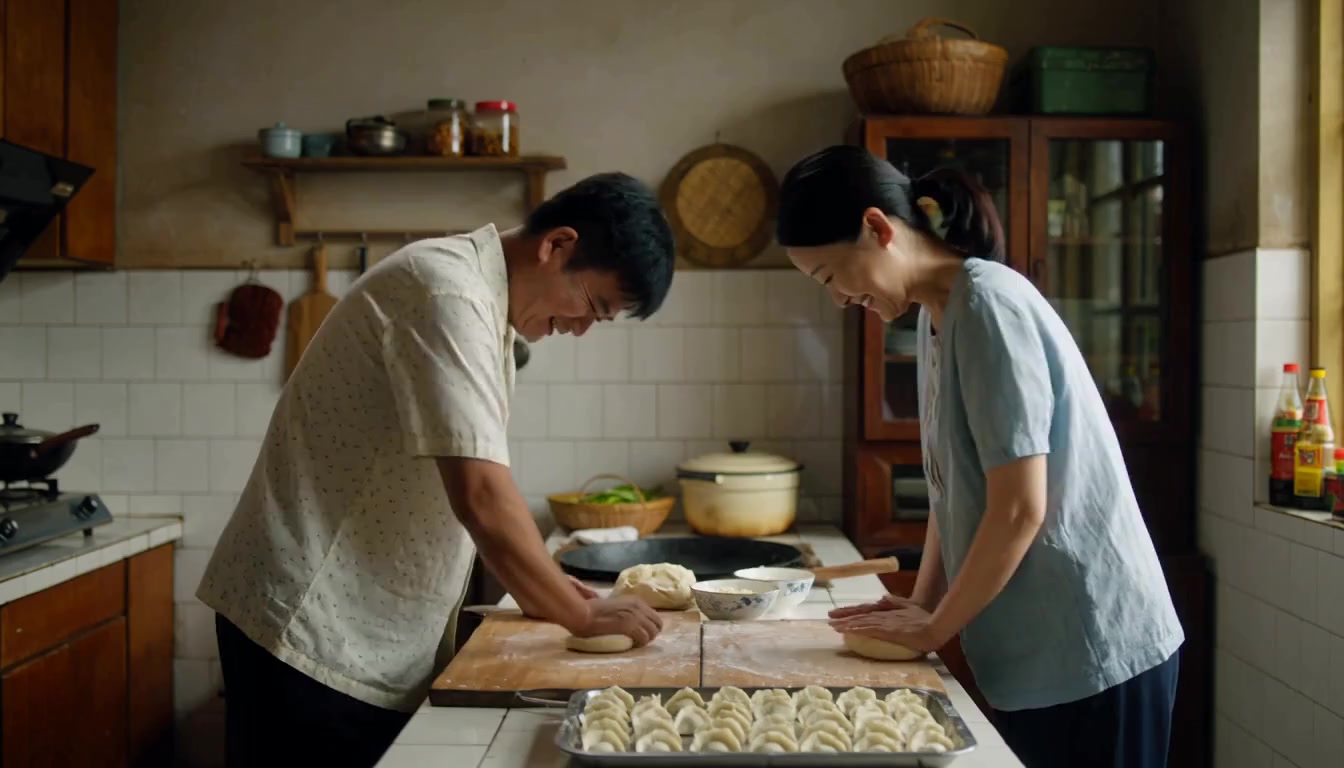
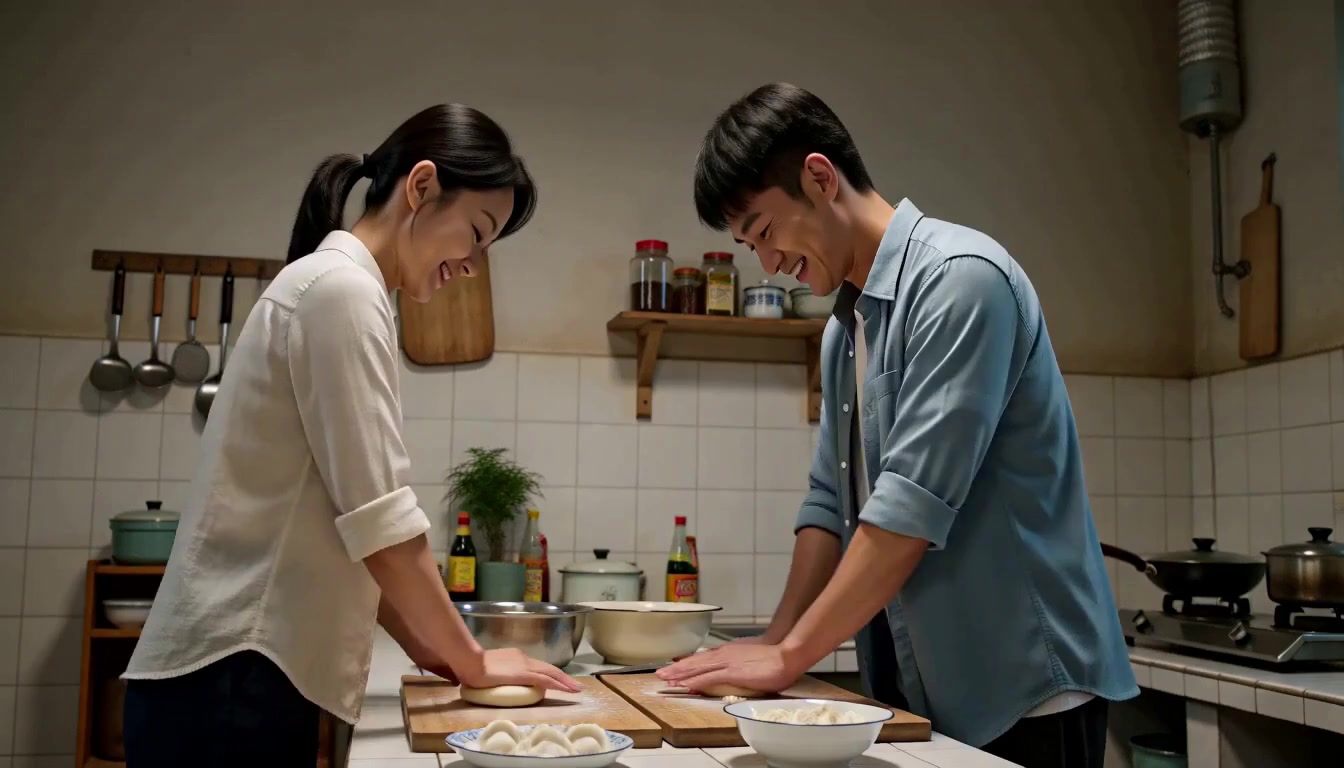
| Teacher, 50 étapes | Student DMAD, 4 étapes |
Une seconde paire correspondante issue de la grille MiniMax H3 de la page du projet.
Limites
- Les students publiés sont entraînés pour du 1344x768 à 124 images avec un audio stéréo 32 kHz, et la carte présente cela comme le point de fonctionnement plutôt que comme un réglage parmi d'autres.
- Les chiffres de préférence pour H3 excluent les égalités, et les comparaisons mélangent des méthodes que la release ne fournit pas ; les chiffres en face-à-face pour SDXL et Wan2.1 proviennent donc des runs de l'article, et non des fichiers publics.
- La release ne contenant aucun nœud officiel ni JSON de flux de travail, le support ComfyUI dépend de conversions communautaires, dont la réduction de rang et la disposition des clés ne sont pas celles évaluées dans l'article.
- La pile H3 complète est volumineuse (transformer de 33B plus un text encoder de 32B) : les quatre étapes réduisent donc le coût d'échantillonnage, et non la mémoire nécessaire pour charger le modèle.
Disponibilité
Page du projet : yzmblog.github.io/projects/DMAD
Article : arXiv 2610.02188
Code : Yzmblog/DMAD
Poids : ZhengmingYu/DMAD
Vidéo de démonstration : YouTube
Conversion ComfyUI : Kijai/MiniMax-H3-experimental
Modèle de base : MiniMaxAI/MiniMax-H3
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.