Qwen-Image 2.1 Consistency LoRA : des retouches bien cadrées
Un LoRA communautaire pour Qwen-Image 2.1 maintient les retouches dans le cadre d'origine : même prompt et même seed, sans dérive ni repeinture, avec deux workflows ComfyUI.
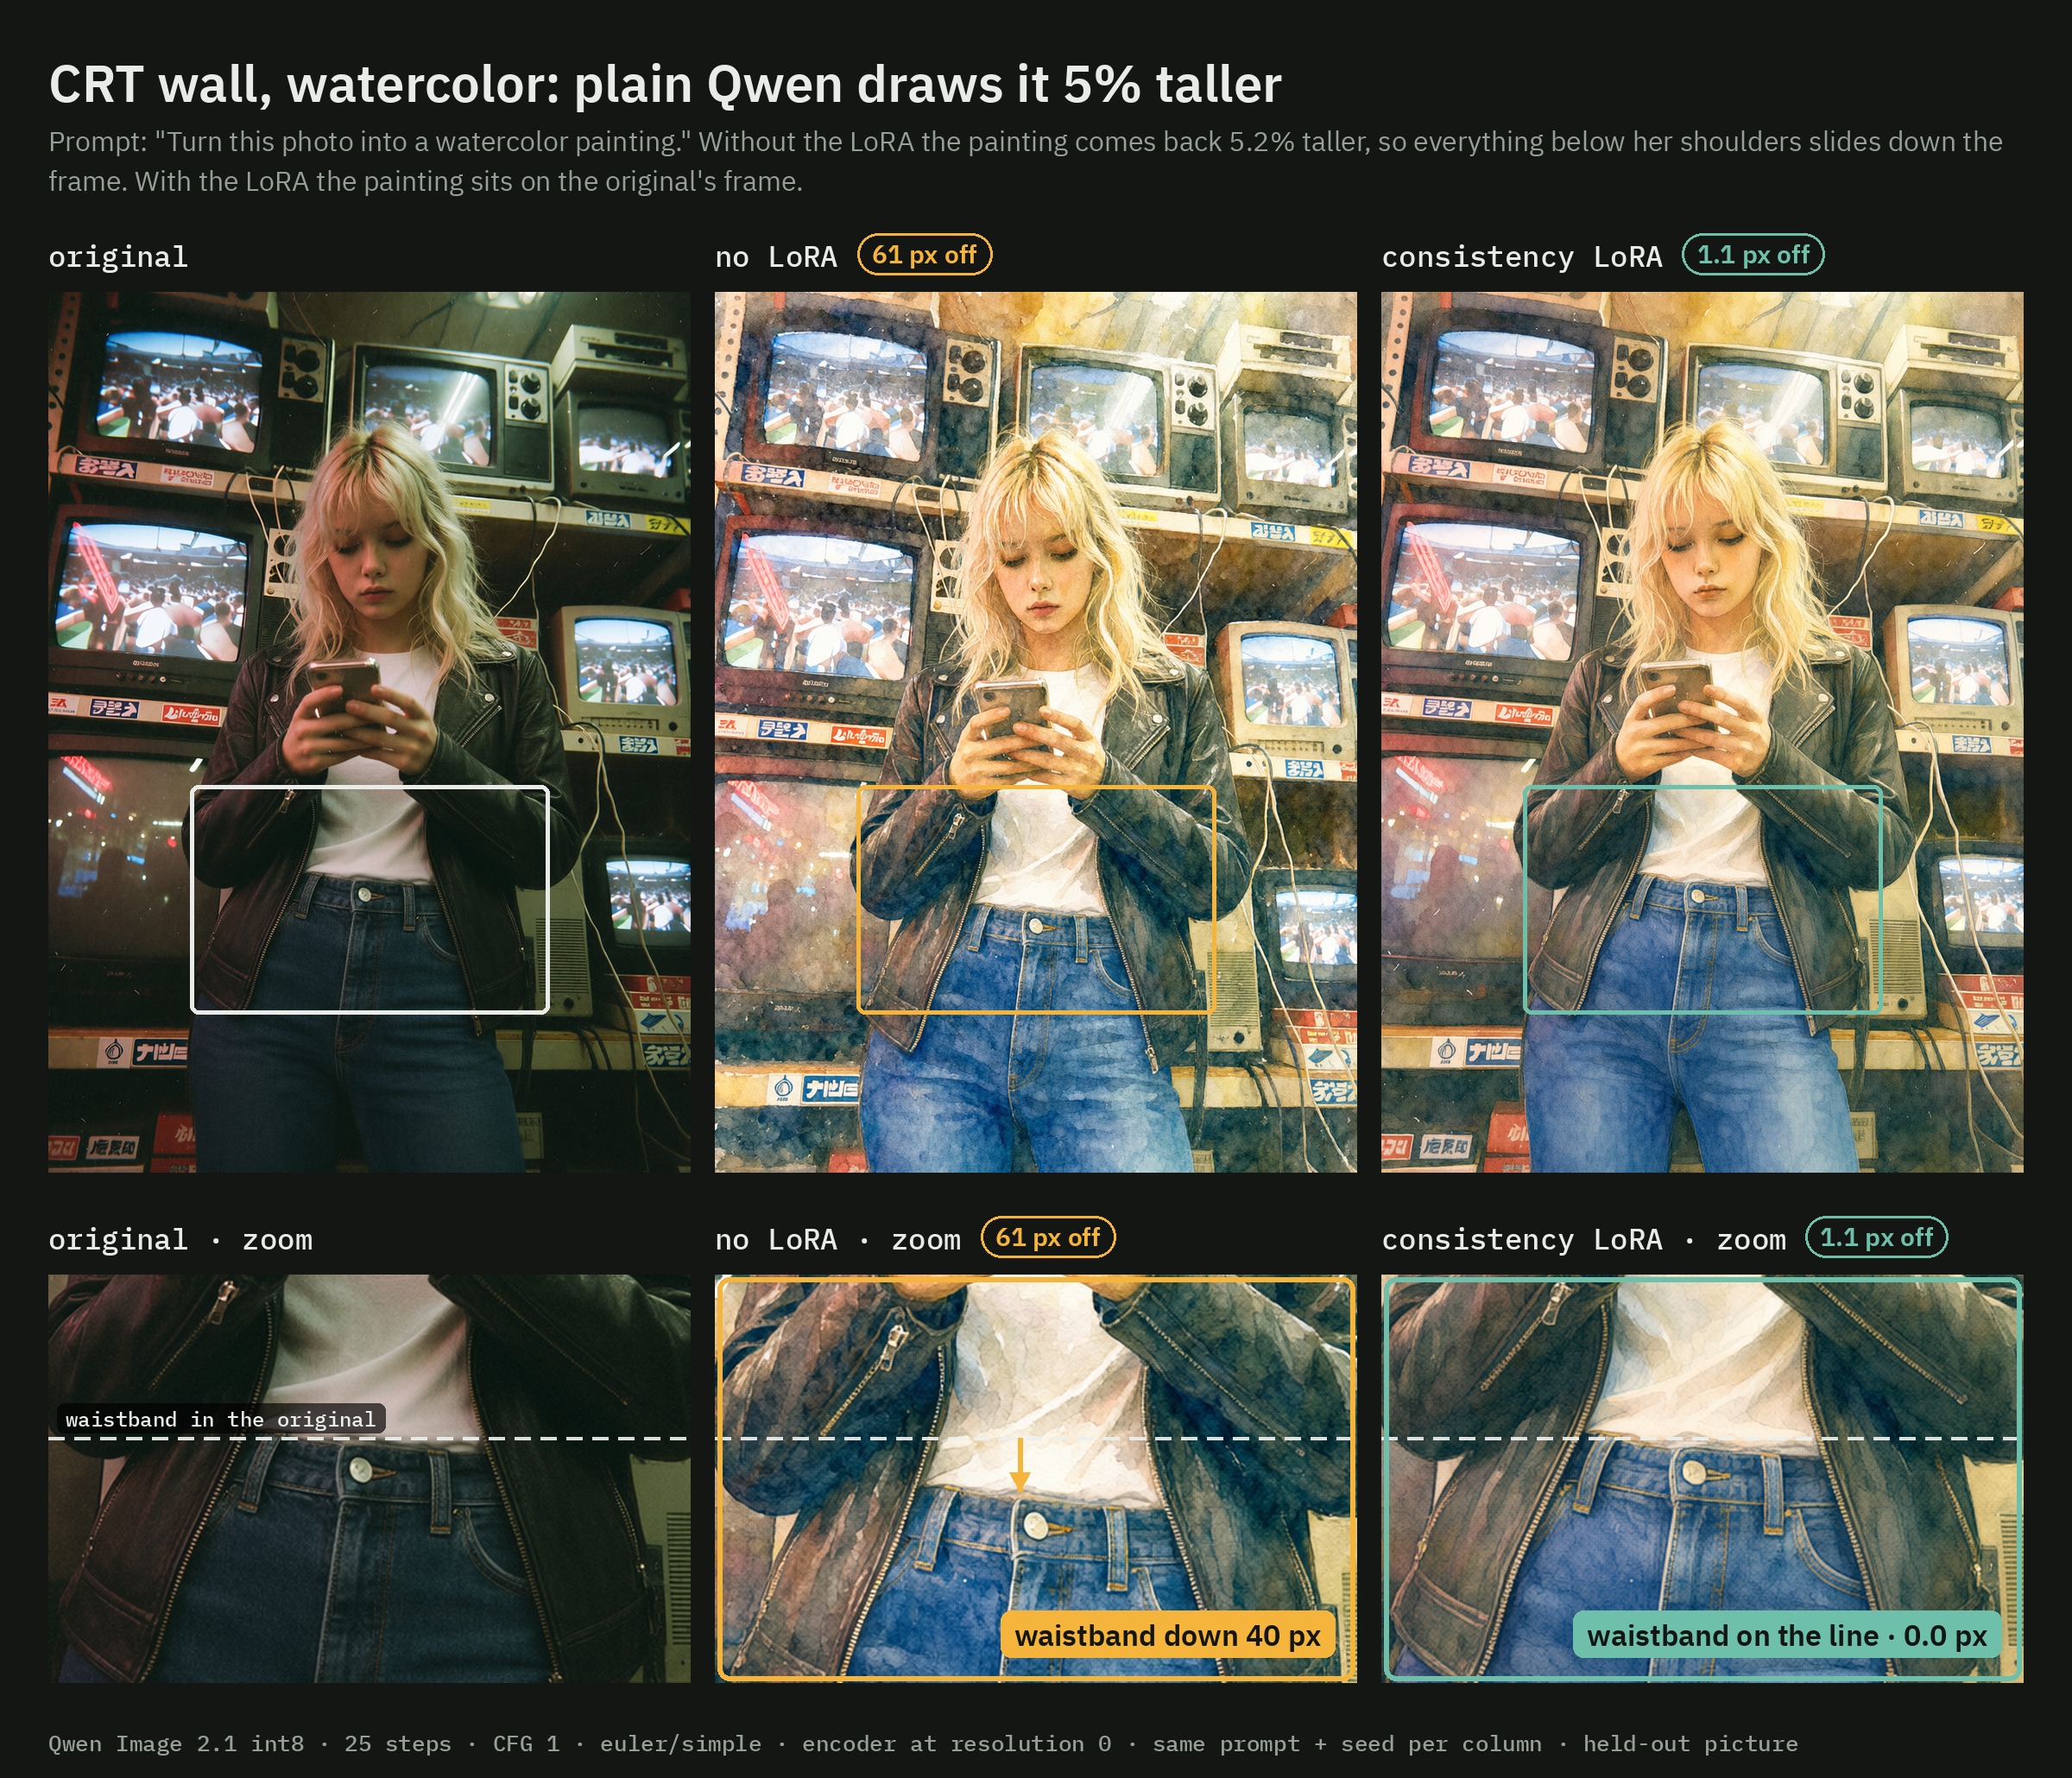
La ligne en pointillés marque l'emplacement d'un élément dans l'original et la flèche montre de combien il s'est déplacé. Même prompt et même seed dans chaque colonne, rendus dans ComfyUI sur les poids Comfy-Org INT8 Qwen-Image 2.1.
Ce que ça corrige
Chaque retouche de Qwen-Image 2.1 est une génération neuve, donc le modèle recompose toute l'image au lieu de ne changer que la partie demandée. Sur une remise en style globale, cela se manifeste par une dérive : une ceinture 40 px plus bas, un horizon 25 px plus haut, un visage qui ne s'aligne plus avec l'original. Sur une retouche locale, cela se manifeste par une repeinture : des mèches de cheveux, des panneaux et des textures en dehors de la retouche sont redessinés avec elle.
Le LoRA fait que la retouche se produit sur le cadre de l'original. Il n'y a pas de mot déclencheur. Chargez-le, écrivez l'instruction de retouche comme d'habitude, et les pixels en dehors du changement restent là où ils étaient.
Dérive mesurée
La carte du modèle rapporte les chiffres de retouches hors échantillon qui n'ont jamais fait partie de l'ensemble d'entraînement. Les décalages correspondent au pire coin de l'image mesuré par rapport à l'original, et la colonne de style compare chaque rendu avec l'apparence de Qwen-Image 2.1 simple, où une distance plus faible signifie une correspondance plus proche :
| retouches hors échantillon, Qwen 2.1 simple vs le LoRA | sans LoRA | étape 1500 | étape 2000 |
|---|---|---|---|
| remises en style (36) : pire coin décalé, médiane | 24,3 px | 1,6 px | 0,9 px |
| remises en style : pire coin décalé, pire cas | 61,1 px | 12,9 px | 3,5 px |
| remises en style à moins de 3 px de décalage | 3 % | 75 % | 97 % |
| remises en style (15) : distance de couleur vs l'apparence de Qwen simple | 7,0 | 6,3 | 10,9 |
| re-éclairages et retouches locales (12) : pire coin décalé, médiane | 0,7 px | 0,1 px | 0,1 px |
Deux seeds de Qwen-Image 2.1 simple diffèrent l'une de l'autre de 7,0 sur cette échelle de couleurs, donc les remises en style à l'étape 1500 ressemblent autant à Qwen simple que Qwen simple se ressemble à lui-même. L'étape 2000 s'aligne plus étroitement mais commence à changer l'apparence : papier plus blanc et moins de couleur sur l'encre et la gouache.
Un second ensemble mesure la repeinture plutôt que la dérive, sur 18 retouches de recoloration et de suppression de photos hors échantillon. Chaque rendu est d'abord aligné avec son original, donc ce qui est compté est la repeinture réelle, pas le décalage :
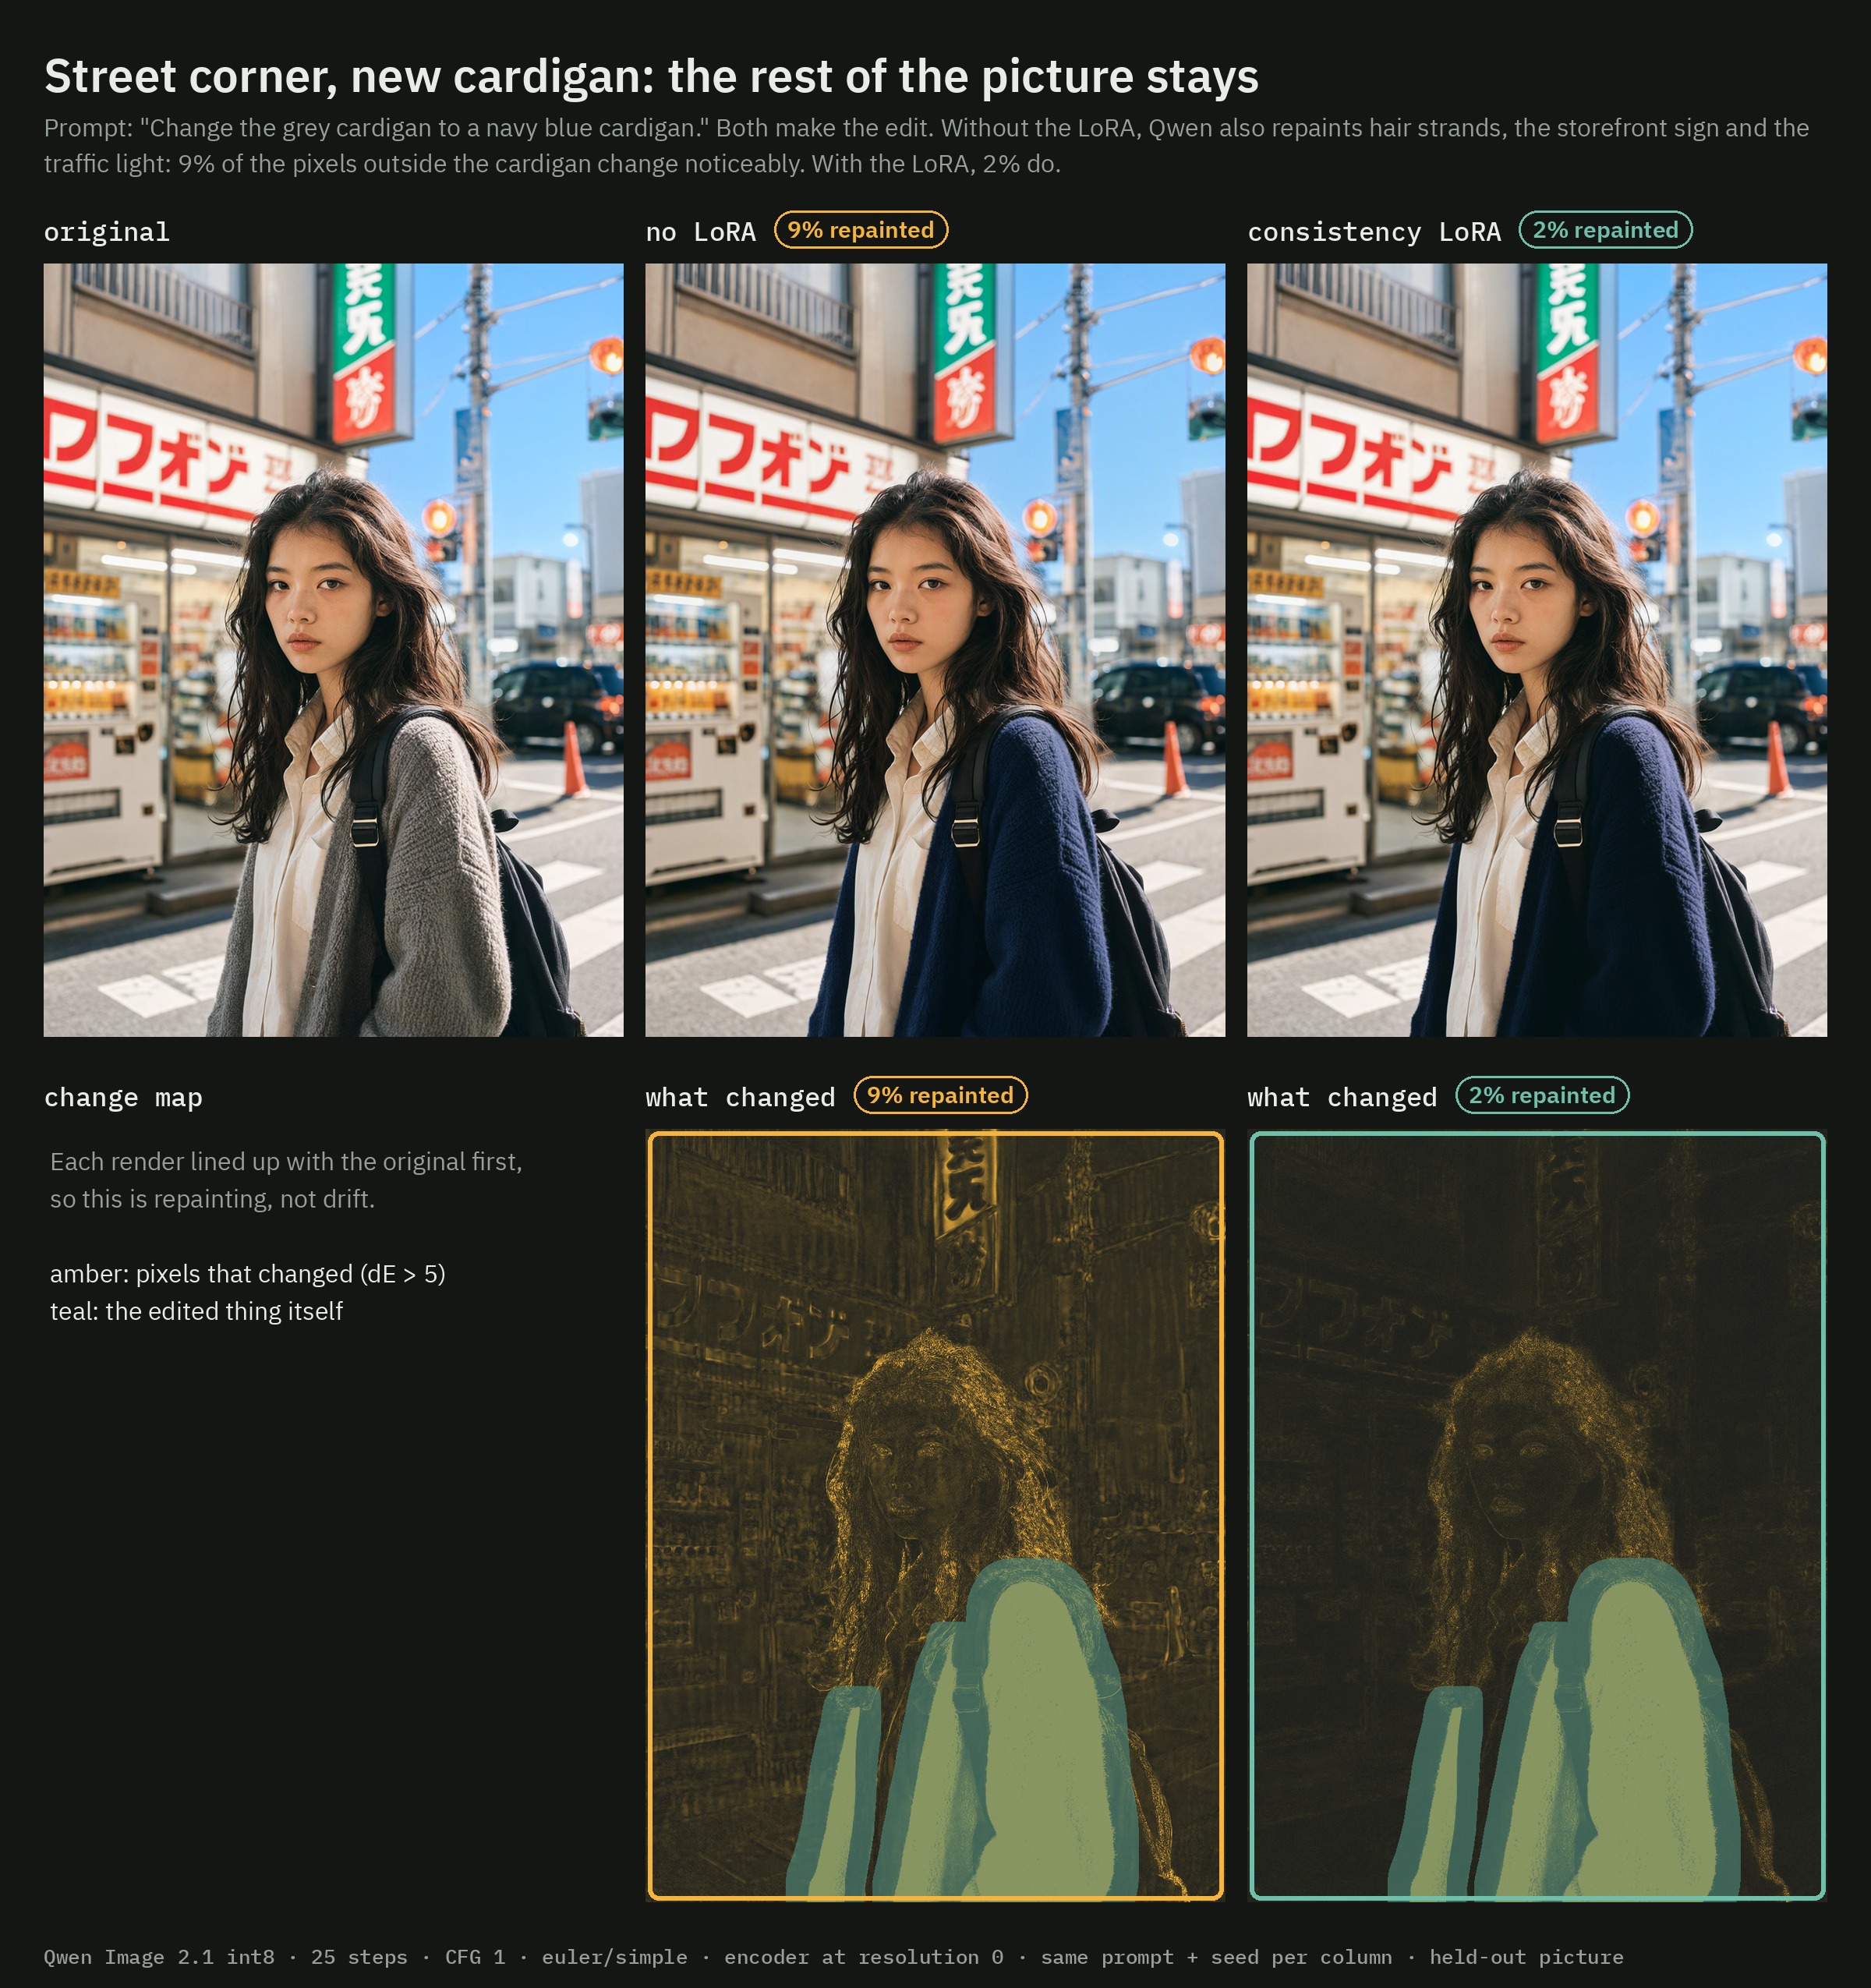
| en dehors de l'objet retouché | sans LoRA | étape 1500 | étape 2000 |
|---|---|---|---|
| pixels qui ont changé de façon notable | 12,8 % | 7,5 % | 7,5 % |
| PSNR par rapport à l'original | 27,7 dB | 31,6 dB | 31,7 dB |
Pour référence, encoder et décoder une image uniquement via le VAE Qwen-Image 2.1 change environ 2 % des pixels à 37 dB, c'est donc le plancher. La retouche elle-même a bien eu lieu dans les 18 cas, avec et sans le LoRA.
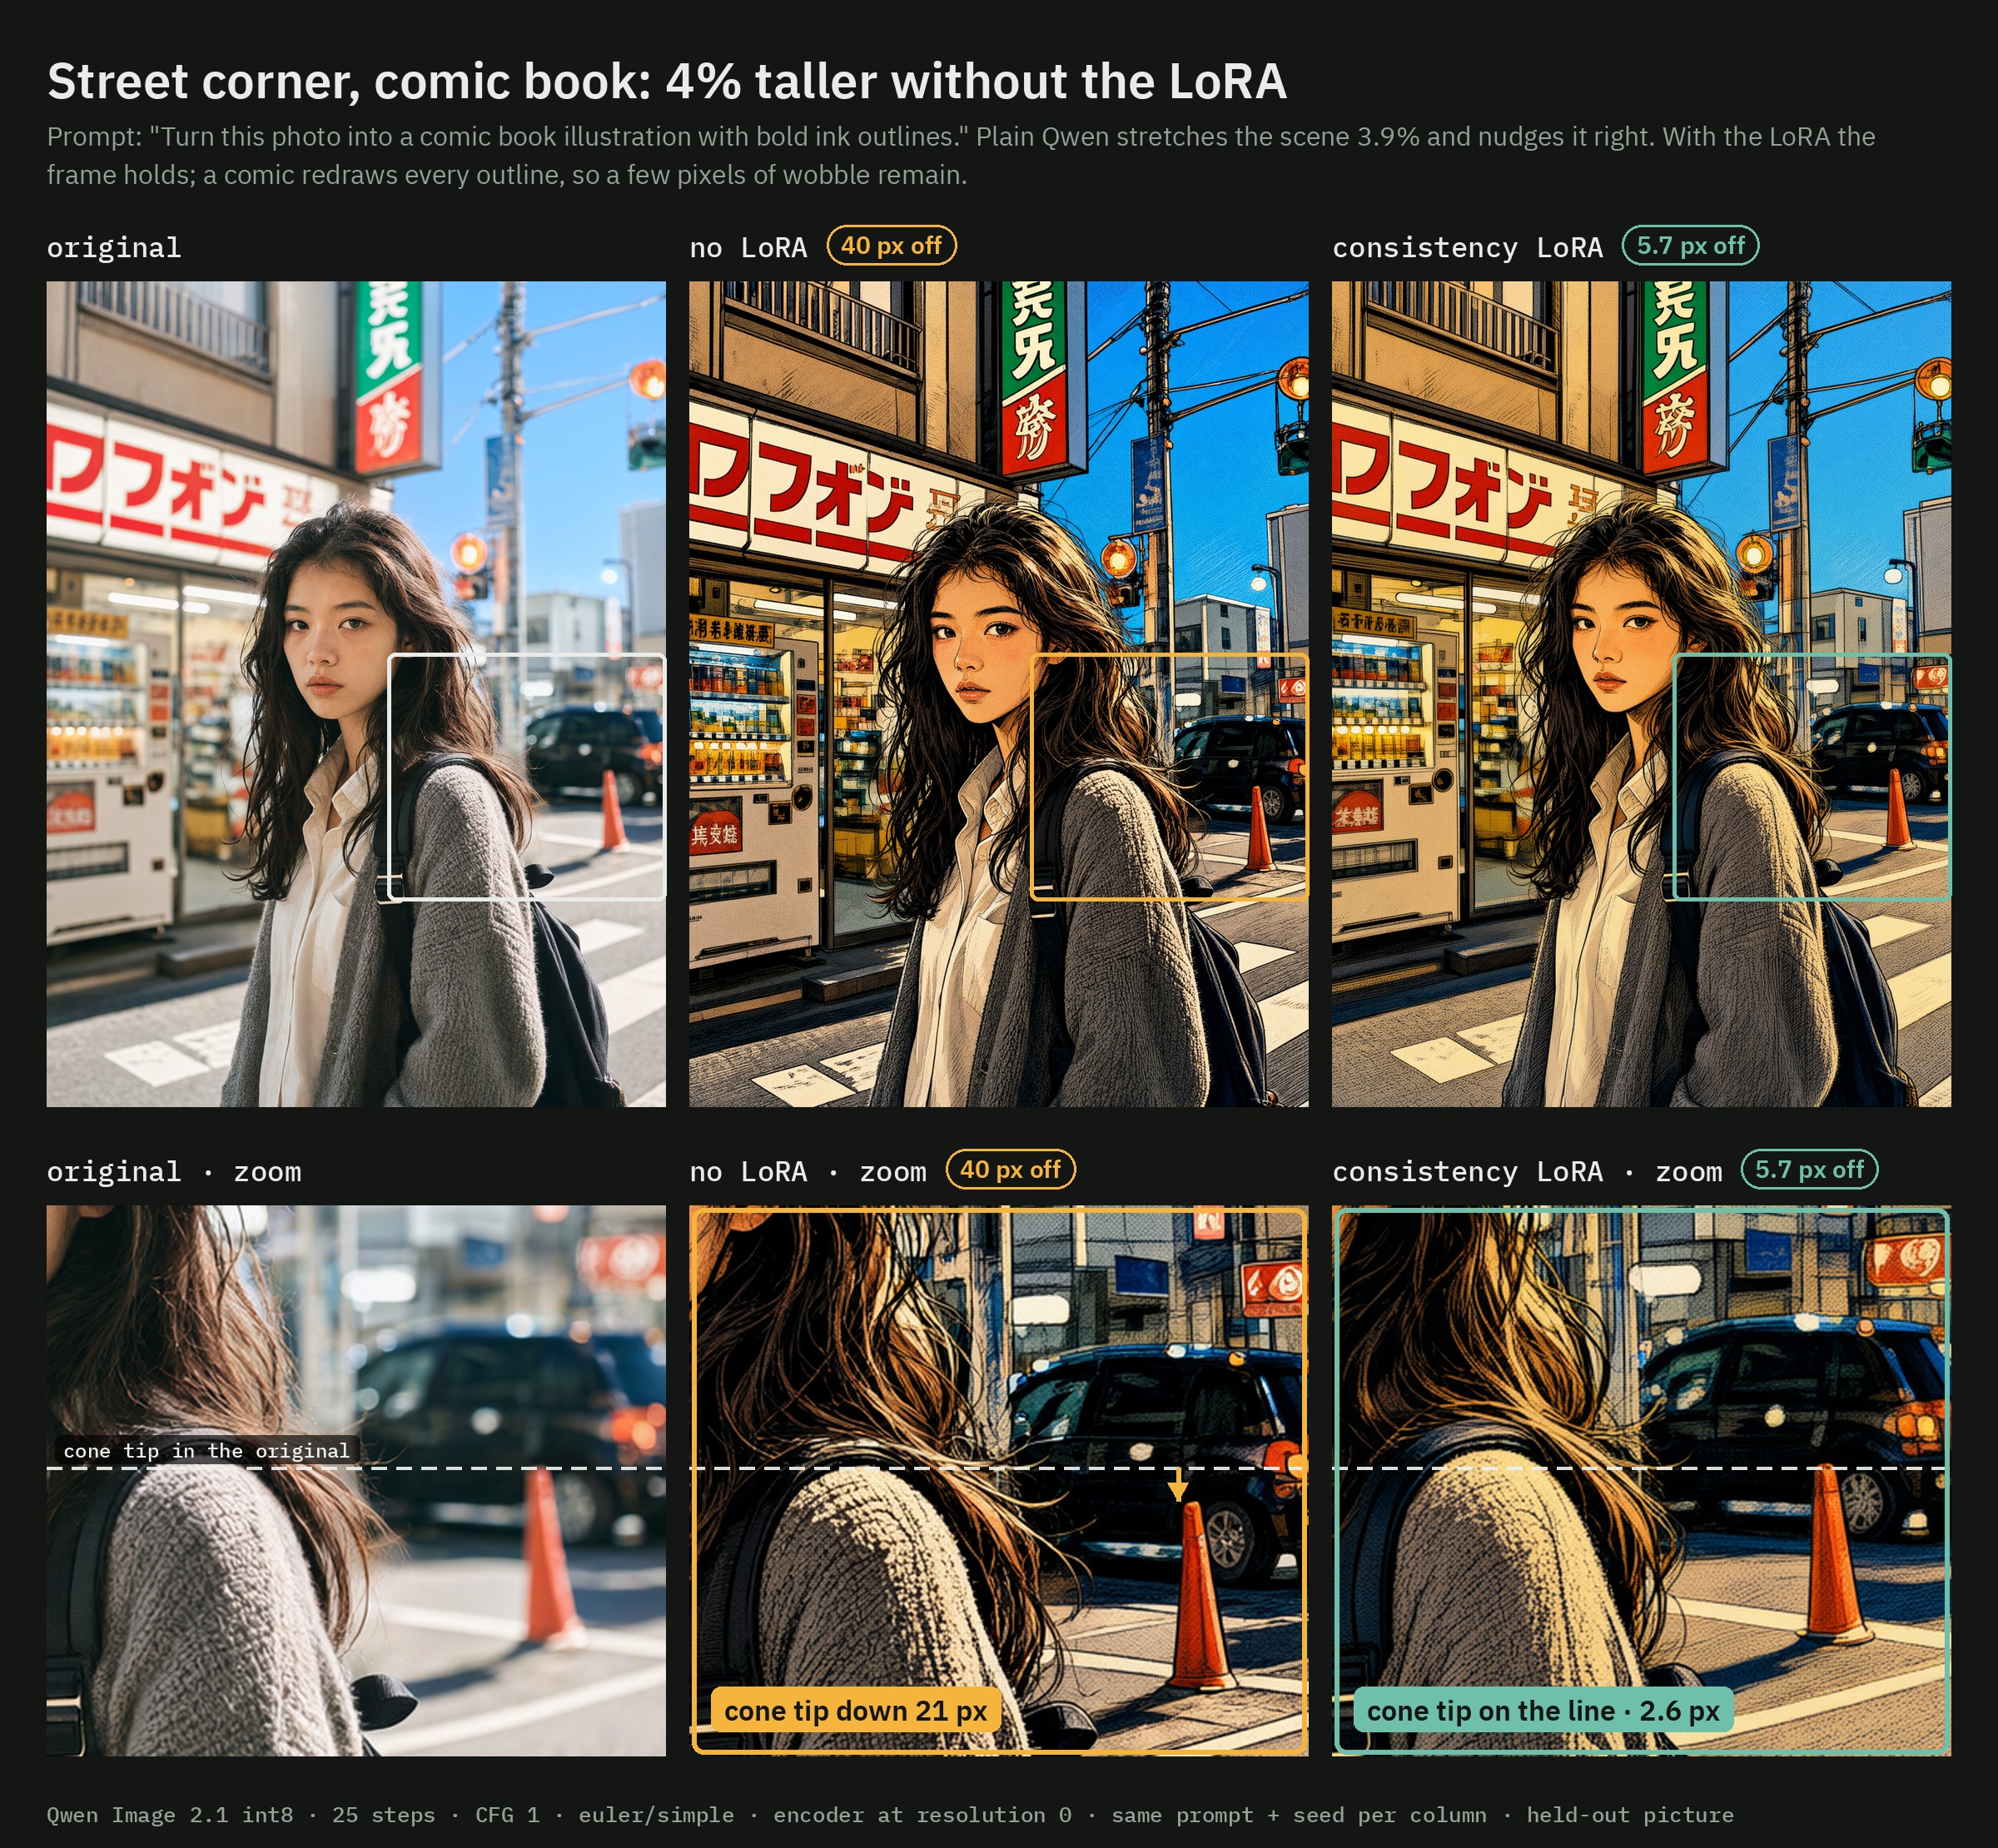
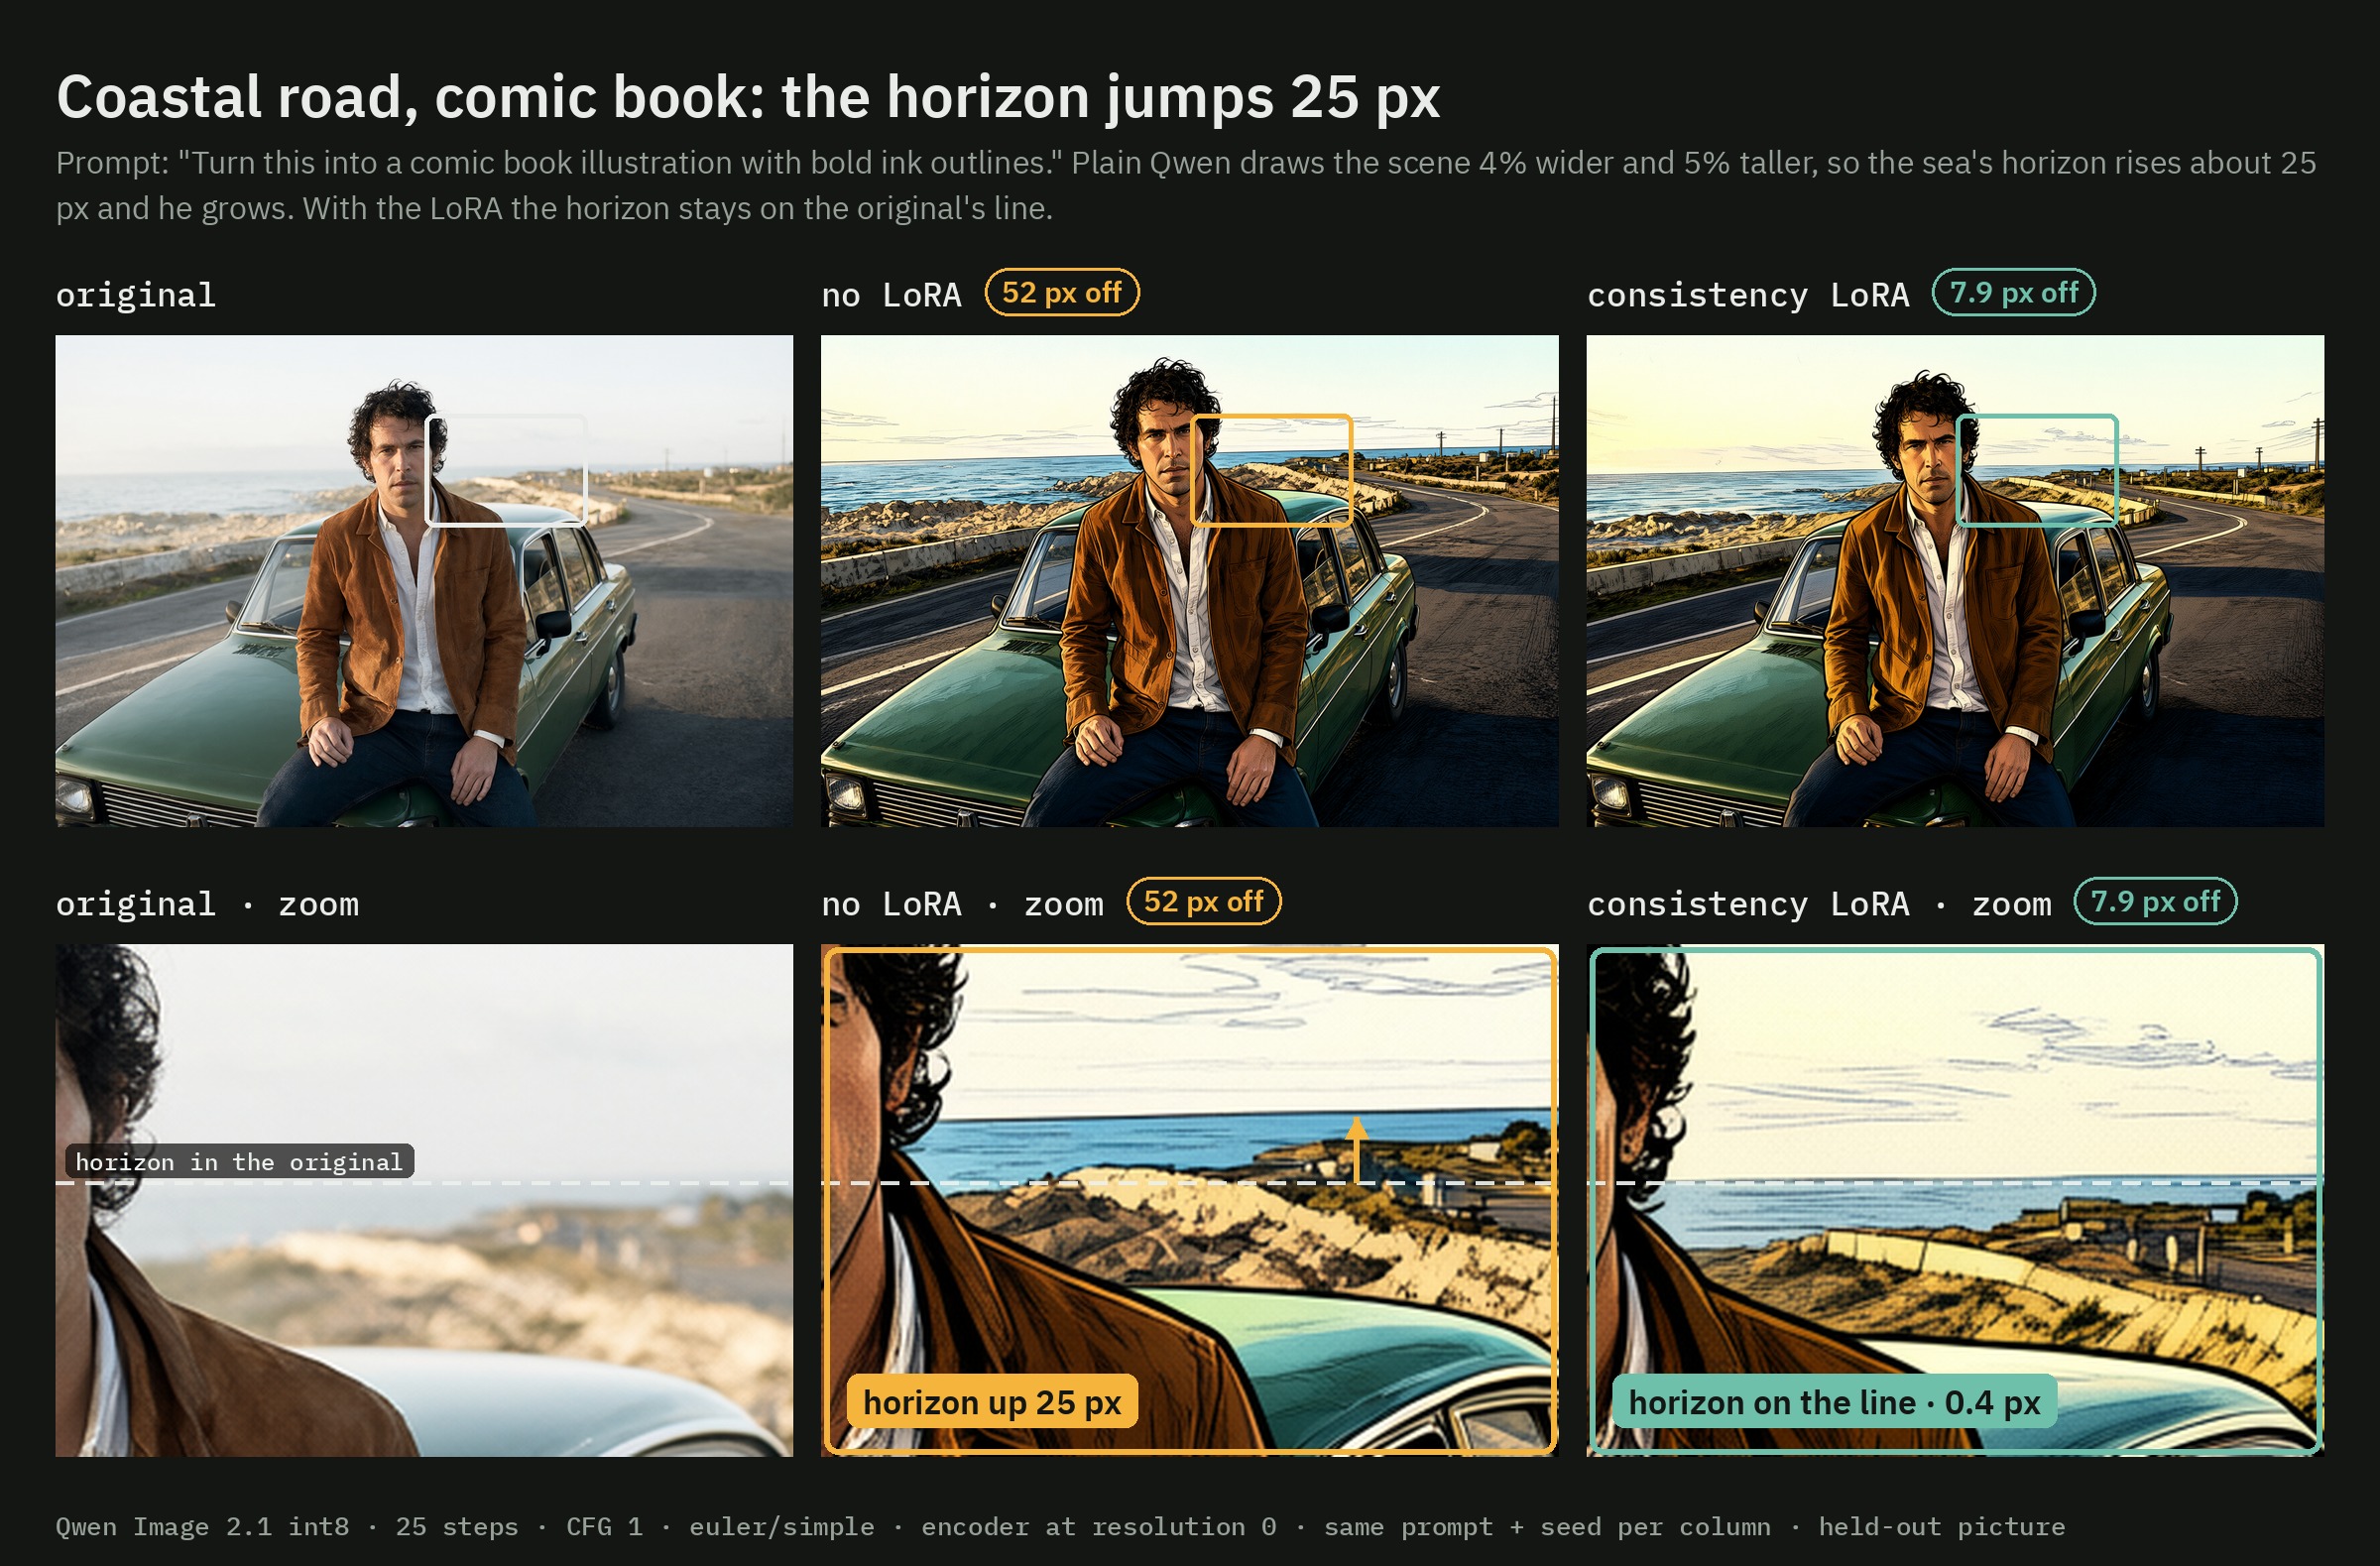
Une exécution côte à côte des mêmes retouches avec et sans le LoRA, issue de la carte du modèle.
Étape 1500 ou étape 2000
| fichier | notes |
|---|---|
qwen-image-2.1-consistency.safetensors | étape 1500, le point de départ recommandé. Conserve l'apparence propre de Qwen. |
qwen-image-2.1-consistency-2000.safetensors | étape 2000 : l'alignement le plus serré, mais les peintures ressortent un peu plus pâles. |
Les deux sont de rang 32 et utilisent le nommage des clés ComfyUI (diffusion_model.transformer_blocks.*), et les 384 tenseurs se chargent sur les poids Comfy-Org Qwen-Image 2.1.
L'utiliser dans ComfyUI
L'adaptateur est un LoRA modèle uniquement, donc aucun nœud personnalisé n'est nécessaire. Pour l'ajouter à n'importe quel graphique de retouche Qwen-Image 2.1 :
- Placez le fichier
.safetensorsdansComfyUI/models/loras/et ajoutez un nœud LoraLoaderModelOnly juste après le chargeur de modèle, à une force de 1.0. Des forces plus faibles laissent revenir une partie de la dérive. - Utilisez un nœud Text Encode Qwen Image 2.1 avec votre image comme
image_1,resolution0, et l'instruction de retouche comme prompt. - Échantillonnez sur la sortie
latentde l'encodeur avec KSampler à 25 étapes, CFG 1,euleretsimple, denoise 1. Un latent de toute autre taille fait que Qwen zoome selon le rapport de taille, ce qu'aucun LoRA ne peut annuler. - Décodez avec VAE Decode puis Diviser l'image avec Alpha, car le VAE Qwen-Image 2.1 décode en RGBA.
Le graphique d'exemple Qwen-Image 2.1 Edit du pack est celui dont viennent ces chiffres. Deux flux de travail prêts à l'emploi accompagnent le dépôt :
Le second flux de travail désactive le LoRA et utilise à la place un nœud Realign to Source pour réaligner la retouche terminée sur l'original, ce qui est la meilleure voie pour les retouches qui doivent déplacer quelque chose. Les deux ont été construits avec les nœuds ComfyUI-AusBoss de l'auteur, mais la carte précise que tout nœud équivalent fera l'affaire.
Comment il a été entraîné
L'ensemble de données est construit à partir de retouches réelles de Qwen-Image 2.1, avec la dérive mesurée et retirée de chaque cible afin que chaque exemple d'entraînement repose sur le cadre de sa source :
- 950 paires de retouches issues de 257 images : 110 portraits rendus avec Qwen-Image 2.1 pour cet ensemble de données, 133 photos Unsplash et 14 images sélectionnées à la main dans les dossiers de référence de l'auteur.
- Types de paires : paires directes (image vers retouche), paires inverses (retouche vers image), et retouches locales qui conservent les pixels de l'original partout en dehors de l'objet retouché.
- Entraînement : ostris/ai-toolkit avec
arch: qwen_image_2sur la base Comfy-Org INT8 ConvRot, la référence conservée à la taille de la cible. Rang 32, alpha 32, AdamW8bit à lr 1e-4, batch 1, pas de tempsshift, résolution cible 1408. 3 000 étapes sur un H100 ont pris environ 1,9 s par étape, avec des checkpoints toutes les 250.
Limites
La carte est directe sur l'étroitesse de la publication. Dans une mise à jour du 28 septembre, l'auteur écrit que l'ensemble de données a peut-être sur-ajusté le LoRA sur certains types de retouches, et qu'il peut ignorer les demandes qui nécessitent un vrai déplacement comme une nouvelle pose ou une tête tournée. Une v2 est prévue une fois un nouvel ensemble de données constitué, et jusque-là le flux de travail de réalignement est la voie recommandée pour ces retouches.
Les autres limites déclarées :
- Pas encore testé avec des LoRA turbo à 4 ou 8 étapes, à 2 MP, ou à un CFG supérieur à 1.
- Les remises en style bande dessinée et anime redessinent chaque contour, donc certaines formes peuvent encore se décaler de quelques pixels d'elles-mêmes. La pire remise en style à l'étape 1500 était décalée de 12,9 px dans un coin.
- Il maintient l'image en place. Il ne rend pas une retouche faible plus forte : si Qwen simple ne fait pas du tout la retouche, le LoRA n'y changera rien.
Disponibilité
- Poids du LoRA : ausboss/Qwen-Image 2.1 Consistency LoRA
- Repack du modèle de base : Comfy-Org/Qwen-Image-2.1
- Pack de nœuds de l'auteur : ausboss/ComfyUI-AusBoss
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.