MiniMax H3 X2 Detail VAE : une sortie 2-en-1 d'upscale et de détails
Une sortie expérimentale 2-en-1 pour MiniMax H3 : un VAE vidéo 2X et un nœud d'amélioration des détails par référence, avec un flux de travail ComfyUI testé.
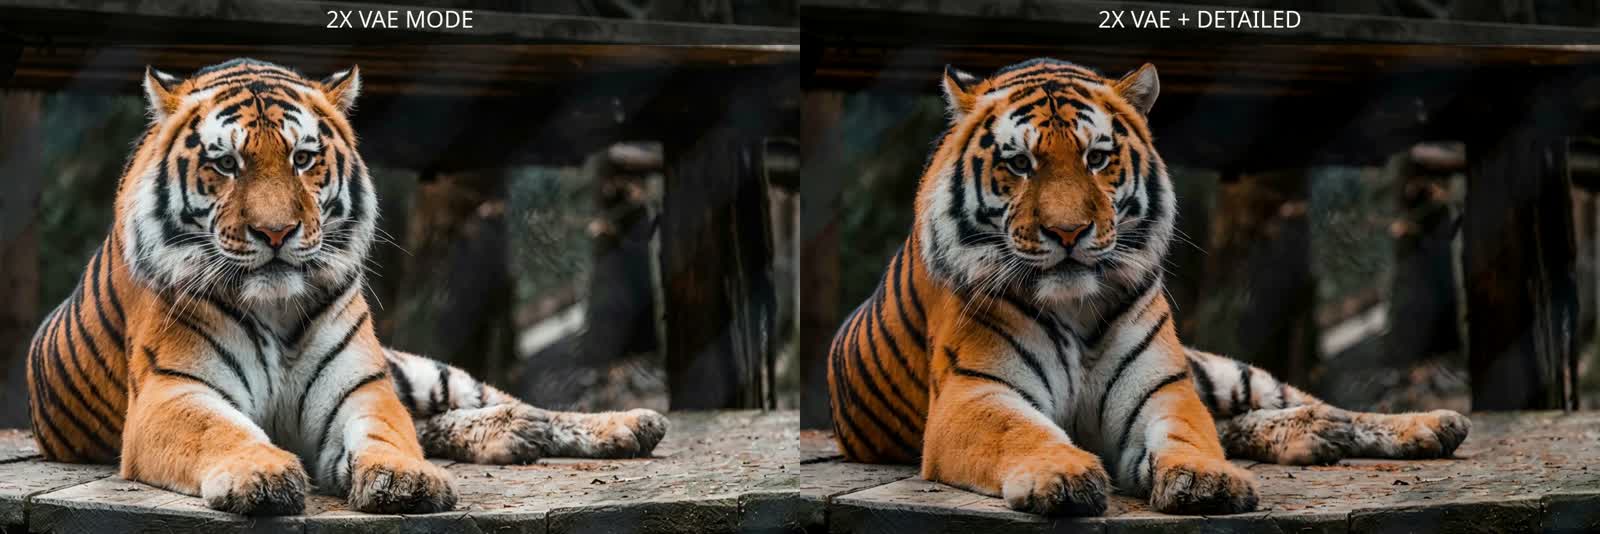
Images extraites du clip de comparaison de la sortie : d'un côté un décodage VAE 2X simple, de l'autre le même latent avec le chemin d'amélioration des détails.
Deux outils dans un seul fichier
La plupart des travaux sur le VAE H3 présents sur le wiki visaient à rendre le décodage plus rapide. Cette sortie prend le chemin inverse et se demande si le décodage peut être rendu plus net, et elle livre tout ce qui a survécu à cette recherche. Le même checkpoint, MiniMax-H3-X2-Detail-v1.safetensors, est utilisé de deux manières distinctes :
| Mode | Entrée | Ce qu'il fait | Nécessite le nœud personnalisé |
|---|---|---|---|
| VAE 2X | latent vidéo H3 | Décode à deux fois la résolution spatiale via une sortie compactée de 12 canaux plus PixelShuffle | Oui, uniquement pour le nœud de décodage rapide |
| Rehausseur de détails | image de référence RGB | Reconstruit une structure spatiale supplémentaire à partir d'un prélèvement précoce dans l'encodeur, avant la référence vers vidéo | Oui, inclus avec la sortie |
Les deux modes ne sont pas interchangeables. Le chemin 2X fonctionne sur un latent généré et ne nécessite aucune image de référence. Le chemin de détails nécessite une image RGB existante, car les informations supplémentaires qu'il utilise sont extraites de l'encodeur H3 avant le goulot d'étranglement latent normal.
Mode 1 : décodage VAE 2X
Placez le checkpoint dans ComfyUI/models/vae/ et sélectionnez-le dans le nœud standard Charger VAE. Pour le décodage proprement dit, remplacez le nœud VAE Decode habituel de ComfyUI par MiniMax H3 VAE Decode (fast) de TripleHeadedMonkey/ComfyUI-MiniMaxH3_LatentUpscaler, qui est ce qui transforme la sortie compactée en RGB pleine résolution.
H3 video latent
   ↓
MiniMax H3 VAE Decode (fast)   ← MiniMax-H3-X2-Detail-v1
   ↓
packed 12-channel X2 decode
   ↓
PixelShuffle ×2
   ↓
2X RGB / video frames
Le flux de travail est livré avec une configuration de départ validée : tiling = true, tile_size = 256, tile_overlap = 64, output_device = cpu, temporal_tiling = false.
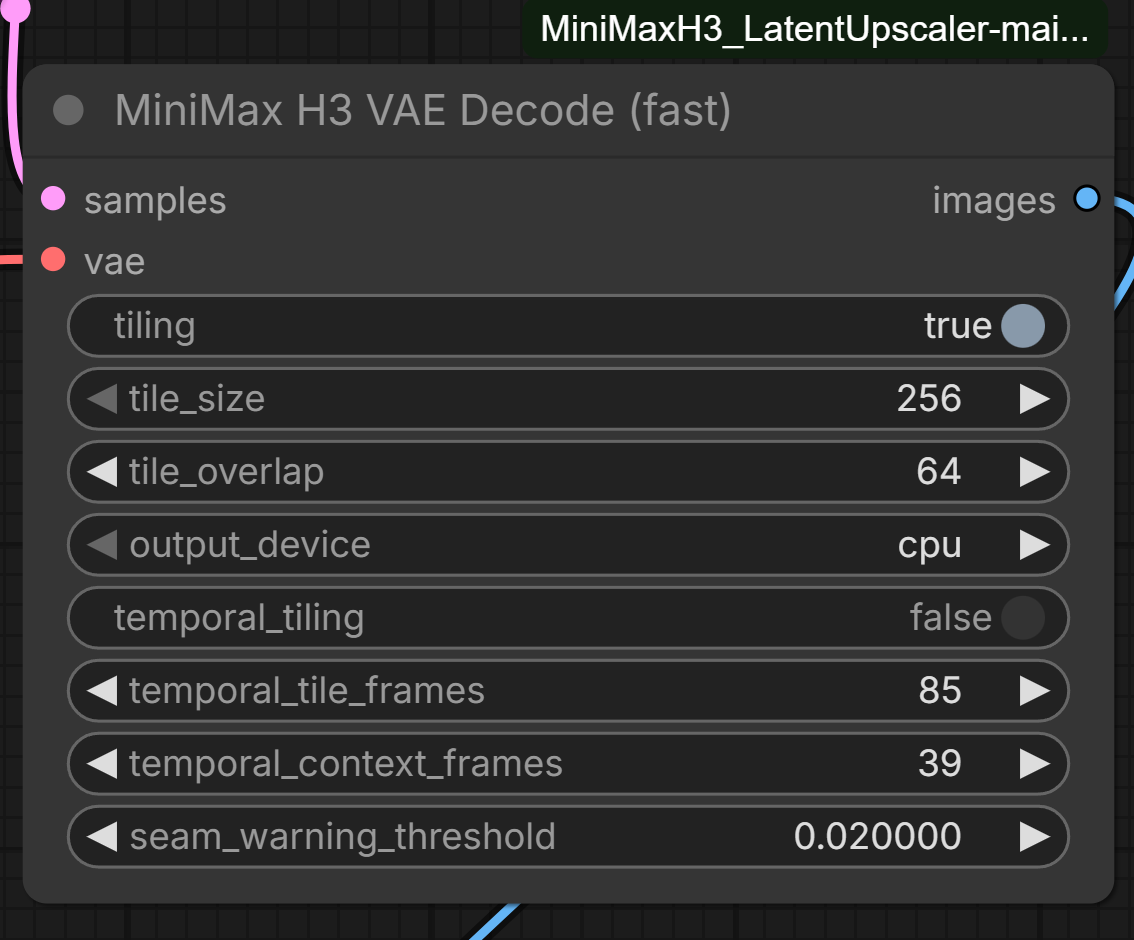
Le nœud MiniMax H3 VAE Decode (fast) requis, tel que présenté dans le README de la sortie.
Mode 2 : amélioration des détails par référence
Pour les flux de travail avec référence d'image, le même checkpoint est chargé une seconde fois dans MiniMax H3 VAE 2X (Detailed Upscale), un petit nœud personnalisé fourni sous la forme de ComfyUI-H3-X2-Detailed.zip. Il se place entre l'image source et MiniMax H3 Référence vers Vidéo, et detail_strength = 1.0 constitue la base testée. Le décodage vidéo final passe toujours par MiniMax H3 VAE Decode (fast) avec le même VAE X2.
Le flux de travail d'exemple
La sortie inclut un graphique 2-en-1 qui démontre les deux rôles à la fois : le nœud de détails améliore la référence RGB avant la référence vers vidéo, et le latent H3 généré est décodé via MiniMax H3 VAE Decode (fast) à la fin.
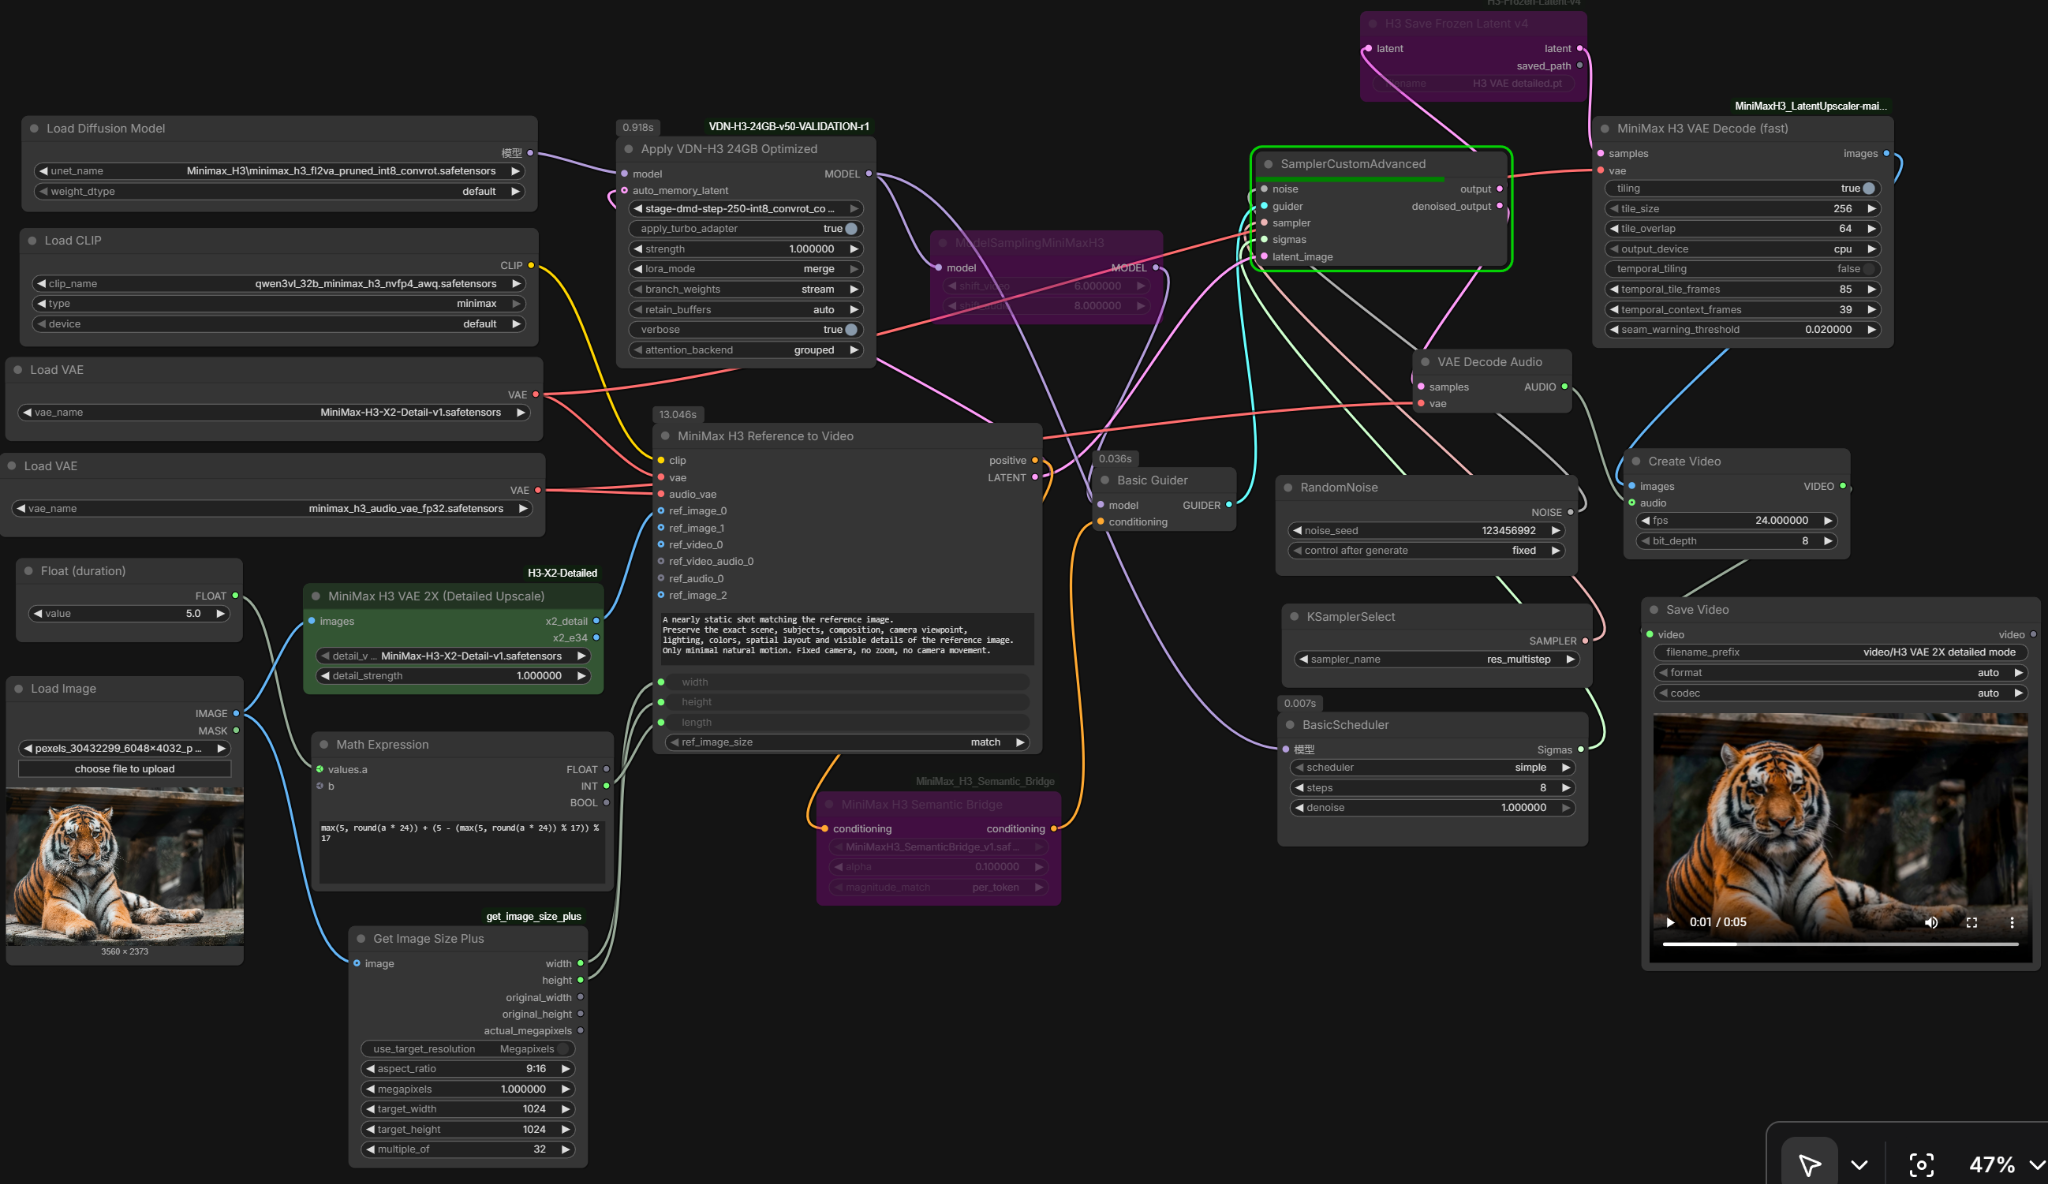
La capture d'écran complète du flux de travail 2-en-1 issue de la fiche du modèle.
Comparaison directe
Les deux clips ci-dessous utilisent le même modèle dans ses deux modes publiés avec des paramètres de génération identiques : le côté gauche correspond au VAE 2X seul, le côté droit au VAE 2X plus le chemin détaillé, où la référence est d'abord traitée par la branche de détails B32.
Comparaison 01 : décodage VAE 2X contre VAE 2X avec le chemin d'amélioration des détails.
Comparaison 02 : les deux mêmes modes sur un second clip.
Pourquoi il n'y a pas de « HQ VAE »
Le compte rendu est d'une franchise inhabituelle quant au résultat. Le point de départ était un VAE H3 2X déjà fonctionnel dont la sortie plus grande n'apportait pas proportionnellement plus de détails réels ; le projet a donc entrepris de donner du sens aux pixels supplémentaires. Les blocs côté décodeur, les pertes ciblant les détails, les « directions de détail » latentes et des décodeurs progressifs plus puissants ont tous échoué, et plusieurs d'entre eux amélioraient une perte numérique tout en produisant des halos sur les contours, une structure rappelant la gravure ou rien de visible du tout.
La seule branche qui a clairement fonctionné extrayait une représentation compacte de 32 canaux depuis down.1.block.1 de l'encodeur H3 figé, et elle améliorait les métriques RMSE, HP3 et de gradient sur les dix images de validation. Elle provenait également de l'image RGB d'origine, avant le goulot d'étranglement latent, soit exactement l'information qui n'existe pas quand H3 génère un nouveau latent lors du text-to-video. La conclusion de l'auteur est restreinte et énoncée sans détour : le gain de détails ne peut pas être reproduit à partir du seul latent H3 généré standard ; il ne pouvait donc pas devenir le VAE latent uniquement, directement substituable, que le projet visait. Il reste un outil expérimental 2-en-1, et non un goulot d'étranglement résolu.
Exigences et fichiers
MiniMax-H3-X2-Detail-v1.safetensors, le checkpoint de 5,2 Go, se place dansComfyUI/models/vae/.- ComfyUI-MiniMaxH3_LatentUpscaler fournit
MiniMax H3 VAE Decode (fast)et est requis pour le flux de travail 2X. ComfyUI-H3-X2-Detailed.zipajoute le nœud optionnelMiniMax H3 VAE 2X (Detailed Upscale)pour le chemin de référence.H3_VAE_Detailed_and_2X_VAE_2in1.jsonest le flux de travail d'exemple.
Disponibilité
Poids et ressources : speach1sdef178/MiniMax-H3-X2-Detail-VAE
Fichier ComfyUI : MiniMax-H3-X2-Detail-v1.safetensors dans models/vae/
Pack de nœuds requis : TripleHeadedMonkey/ComfyUI-MiniMaxH3_LatentUpscaler
Modèle de base : MiniMaxAI/MiniMax-H3
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.