Viggle Turbo v0.3 : Qwen-Image 2.1 en 6 et 9 étapes dans ComfyUI
La distillation v0.3 de Qwen-Image 2.1 par Viggle ajoute un mode 9 étapes et fournit des nœuds, flux et poids fusionnés officiels pour ComfyUI, en génération et édition 6 étapes.
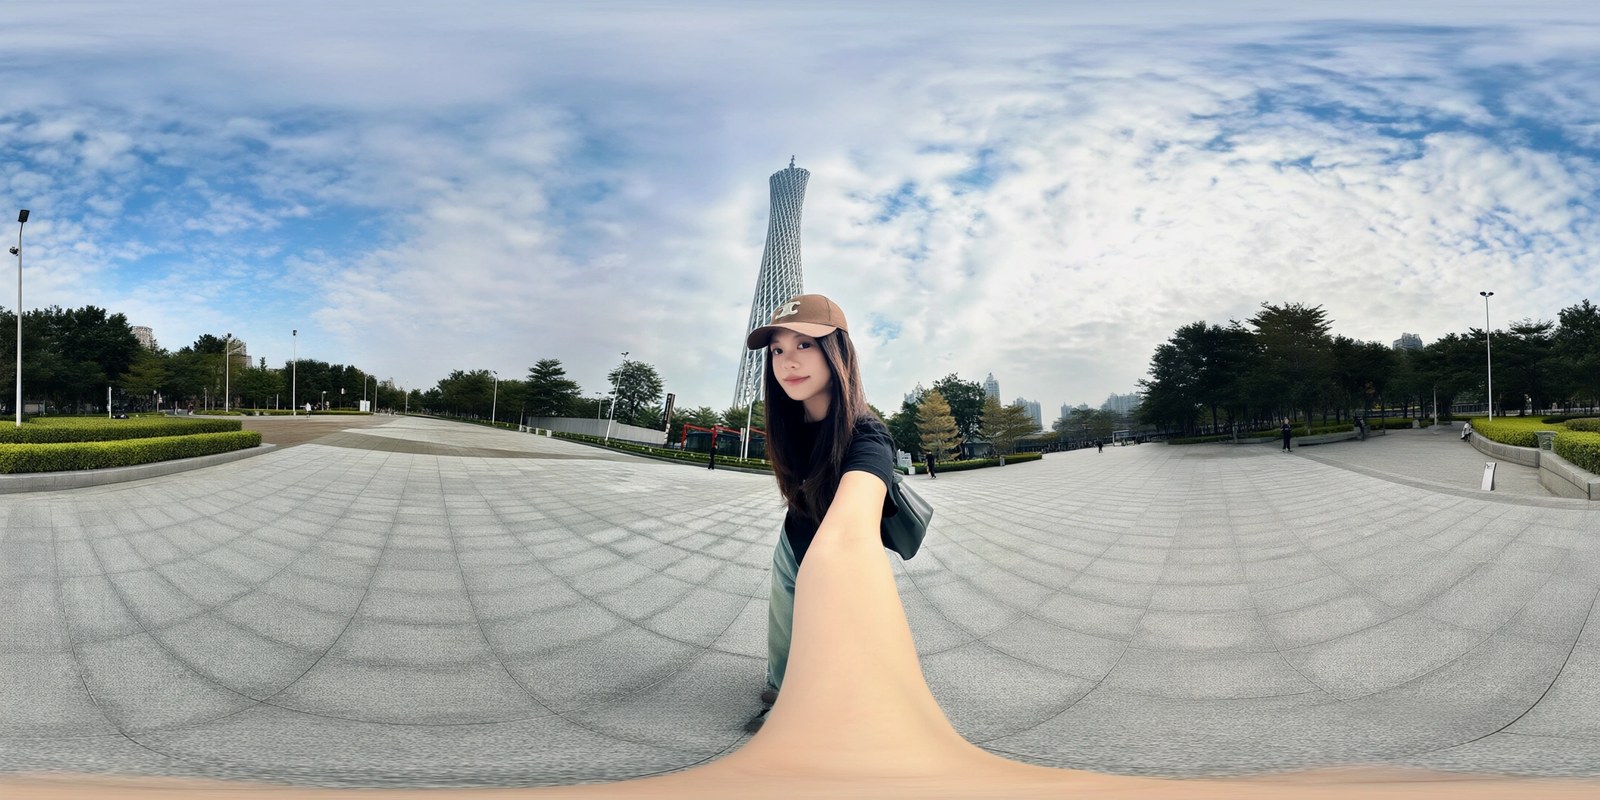
Un panorama équirectangulaire à 360 degrés construit à partir d'une seule photo en perspective, généré par la v0.3 en 9 étapes à 2176x1088. Source : onglet de comparaison du Space de démonstration de Viggle.
Ce que change la v0.3
La distillation elle-même est inchangée : un LoRA de rang 256 sur le transformer Qwen-Image 2.1 de base, échantillonné sur un planning sigma fixe avec true_cfg_scale=1.0 et sans prompt négatif. La v0.3 déplace l'équilibre plutôt que la méthode.
- 6 étapes, réajustées. Par rapport à la v0.2.1, les résultats sont moins granuleux et plus propres sur les surfaces planes, avec une texture fine légèrement plus douce. Viggle précise explicitement qu'il ne s'agit pas d'une mise à niveau stricte : si vous préfériez le rendu plus net de la v0.2.1, cet adaptateur reste dans le référentiel.
- Un nouveau mode 9 étapes. Sept étapes turbo, puis le LoRA est désactivé et le modèle de base non modifié termine les deux dernières. Le détail est plus fin et les petits textes rendus sont plus souvent corrects. Cela prend environ 1,4 à 1,5 fois plus de temps que 6 étapes, ce qui reste environ 3,5 fois plus rapide que le modèle de base en 40 étapes.
- Un plafond annoncé. Viggle écrit que 6 étapes correspond à peu près à ce que cet élève peut faire : chaque gain trouvé depuis la v0.2.1 a sacrifié quelque chose, plus de netteté venant avec plus de grain et moins de grain venant avec un rendu plus doux. Au-delà de ce point, la qualité doit se payer en étapes, ce que fait le mode 9 étapes.
Le mode 9 étapes
Le chemin en 9 étapes n'est pas simplement un planning plus long. Le pipeline calcule les K/V de texte et de référence une seule fois et les réutilise ; les 7 étapes turbo remplissent ce cache, donc la première étape du modèle de base doit le recalculer avant que le LoRA soit désactivé et que le modèle de base prenne le relais. Dans diffusers, cela implique un callback d'étape et un wrapper autour du forward du transformer, tous deux montrés dans la carte du modèle :
SIGMAS_9 = [1.0, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25, 1 / 6, 1 / 12]Le planning en 6 étapes conserve les nœuds à faible bruit 0.875, 0.75, 0.5, 0.25 et ajoute des étapes uniquement du côté à bruit élevé : 5 étapes correspond à [1, 0.875, 0.75, 0.5, 0.25], 7 étapes à [1, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25]. Déplacer les nœuds à faible bruit à la place rend les résultats plus doux, et passer un simple nombre d'étapes sans la liste de sigmas ne fonctionne pas.
9 étapes fonctionne actuellement uniquement dans diffusers et le Space de démonstration. Les flux de travail ComfyUI implémentent le planning à 6 étapes.
Prise en charge officielle de ComfyUI
C'est la partie que la v0.2 n'avait pas. La sortie inclut désormais un portage ComfyUI dans le dossier comfyui/ du référentiel de modèles, testé avec ComfyUI 0.37.0, qui prend en charge nativement Qwen-Image 2.1 :
viggle_turbo.pyajoute deux nœuds. Copiez-le dansComfyUI/custom_nodes/et redémarrez.Viggle Turbo Sigmasfournit le planning en 6 étapes avec le décalage dépendant de la résolution du pipeline, à utiliser avec euler etBasicGuiderau lieu d'un scheduler de KSampler, sans CFG et sans prompt négatif.Viggle Turbo LoRA (unmerged)applique l'adaptateur à l'exécution comme le fait diffusers. Les chargeurs LoRA standards le fusionnent dans les poids, ce que Viggle mesure comme une perte d'environ 30 % de la mise à jour de cet adaptateur en bf16 et l'ajout de bruit en int8. Le nœud unmerged coûte 10 à 25 % de temps supplémentaire par étape.- Des flux de travail pour la génération texte-vers-image et l'édition, plus des variantes pour les poids fusionnés en fichier unique et pour GGUF.
Avec les valeurs par défaut int8, le LoRA r128 et l'améliorateur de prompt activés, les flux de travail atteignent un pic d'environ 26 Go de VRAM à 1248x832. La carte du modèle note aussi que le portage ComfyUI a été en grande partie écrit avec un assistant de codage IA, donc des aspérités sont attendues et les correctifs sont bienvenus.
Transformers fusionnés en fichier unique
Si vous préférez ne pas charger de LoRA du tout, la v0.3 fournit aussi le transformer de base avec l'adaptateur de rang 256 déjà fusionné en fp32 et quantifié une seule fois. Les fichiers vont dans models/diffusion_models/ ; les versions GGUF nécessitent ComfyUI-GGUF, et chaque chemin nécessite toujours Viggle Turbo Sigmas fourni par le nœud personnalisé. Seul le mode 6 étapes est disponible de cette façon.
| Format | Taille | Chargeur ComfyUI | LPIPS v0.3 | LPIPS v0.2.1 |
|---|---|---|---|---|
| GGUF Q8_0 | 7,7 Go | Unet Loader (GGUF) | 0,051 | 0,054 |
| int8, recette convrot de Comfy-Org | 7,3 Go | Charger Modèle Diffusion | 0,057 | 0,060 |
| GGUF Q6_K | 6,0 Go | Unet Loader (GGUF) | 0,055 | 0,067 |
| fp8 e4m3fn, poids uniquement | 7,3 Go | Charger Modèle Diffusion | 0,068 | 0,070 |
| GGUF Q5_K_M | 5,1 Go | Unet Loader (GGUF) | 0,076 | 0,083 |
| GGUF Q4_K_M | 4,3 Go | Unet Loader (GGUF) | 0,100 | 0,118 |
| int8 plus le LoRA r128 (les flux de travail LoRA) | 8,0 Go | Charger Modèle Diffusion | 0,041 | 0,044 |
LPIPS est la distance VGG moyenne mesurée par Viggle par rapport à diffusers exécutant le LoRA de rang 256, sur 96 requêtes mises de côté avec le même prompt, les mêmes entrées, la même graine et le même bruit ; plus la valeur est basse, plus c'est proche. Pour donner l'échelle, ComfyUI et diffusers diffèrent d'environ 0,03 à 0,04 sans LoRA chargé.
Les poids fusionnés sont proches du chemin LoRA, mais pas identiques. Sur environ 8 de ces 96 requêtes, la version fusionnée int8 ou Q8_0 aboutit à une composition ou une tenue différente, contre 3 à 5 pour le flux de travail LoRA. Q4_K_M dérive visiblement davantage, à 23 à 29 sur 96, et Viggle ne le recommande que lorsque rien de plus grand ne tient en mémoire.
Le modèle de base en 40 étapes face aux modes 6 et 9 étapes
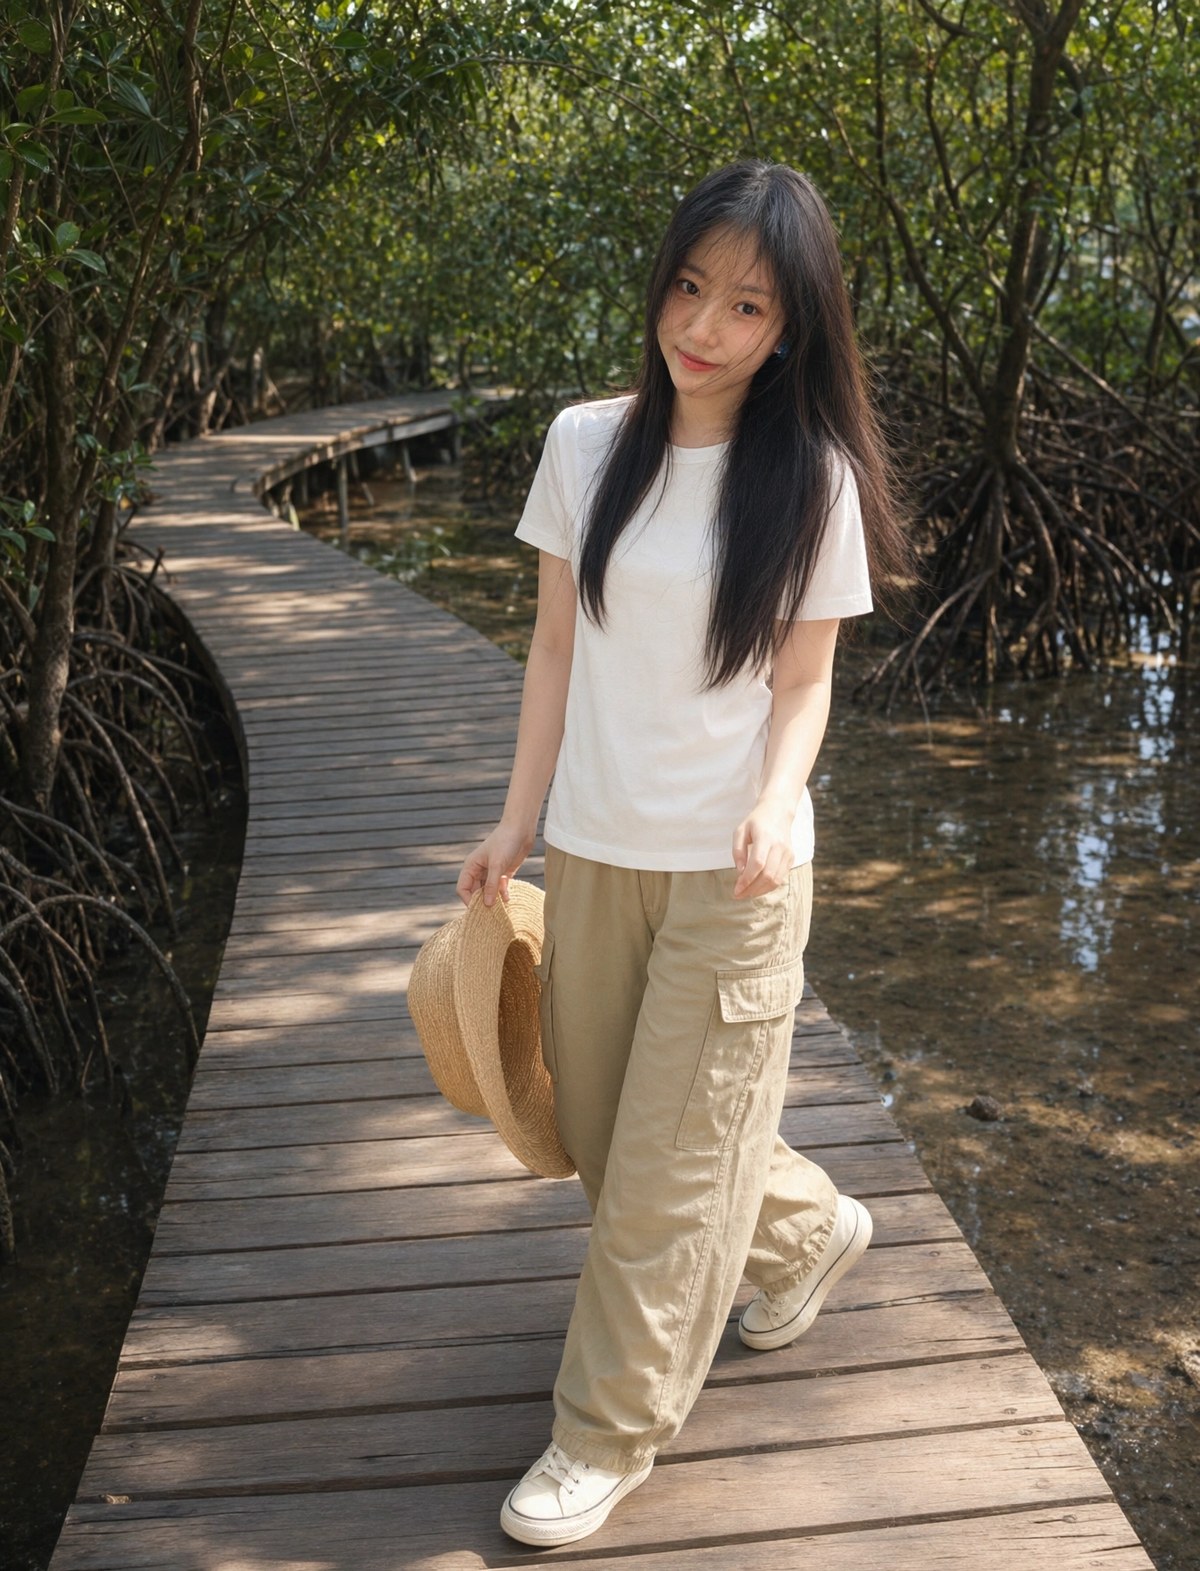
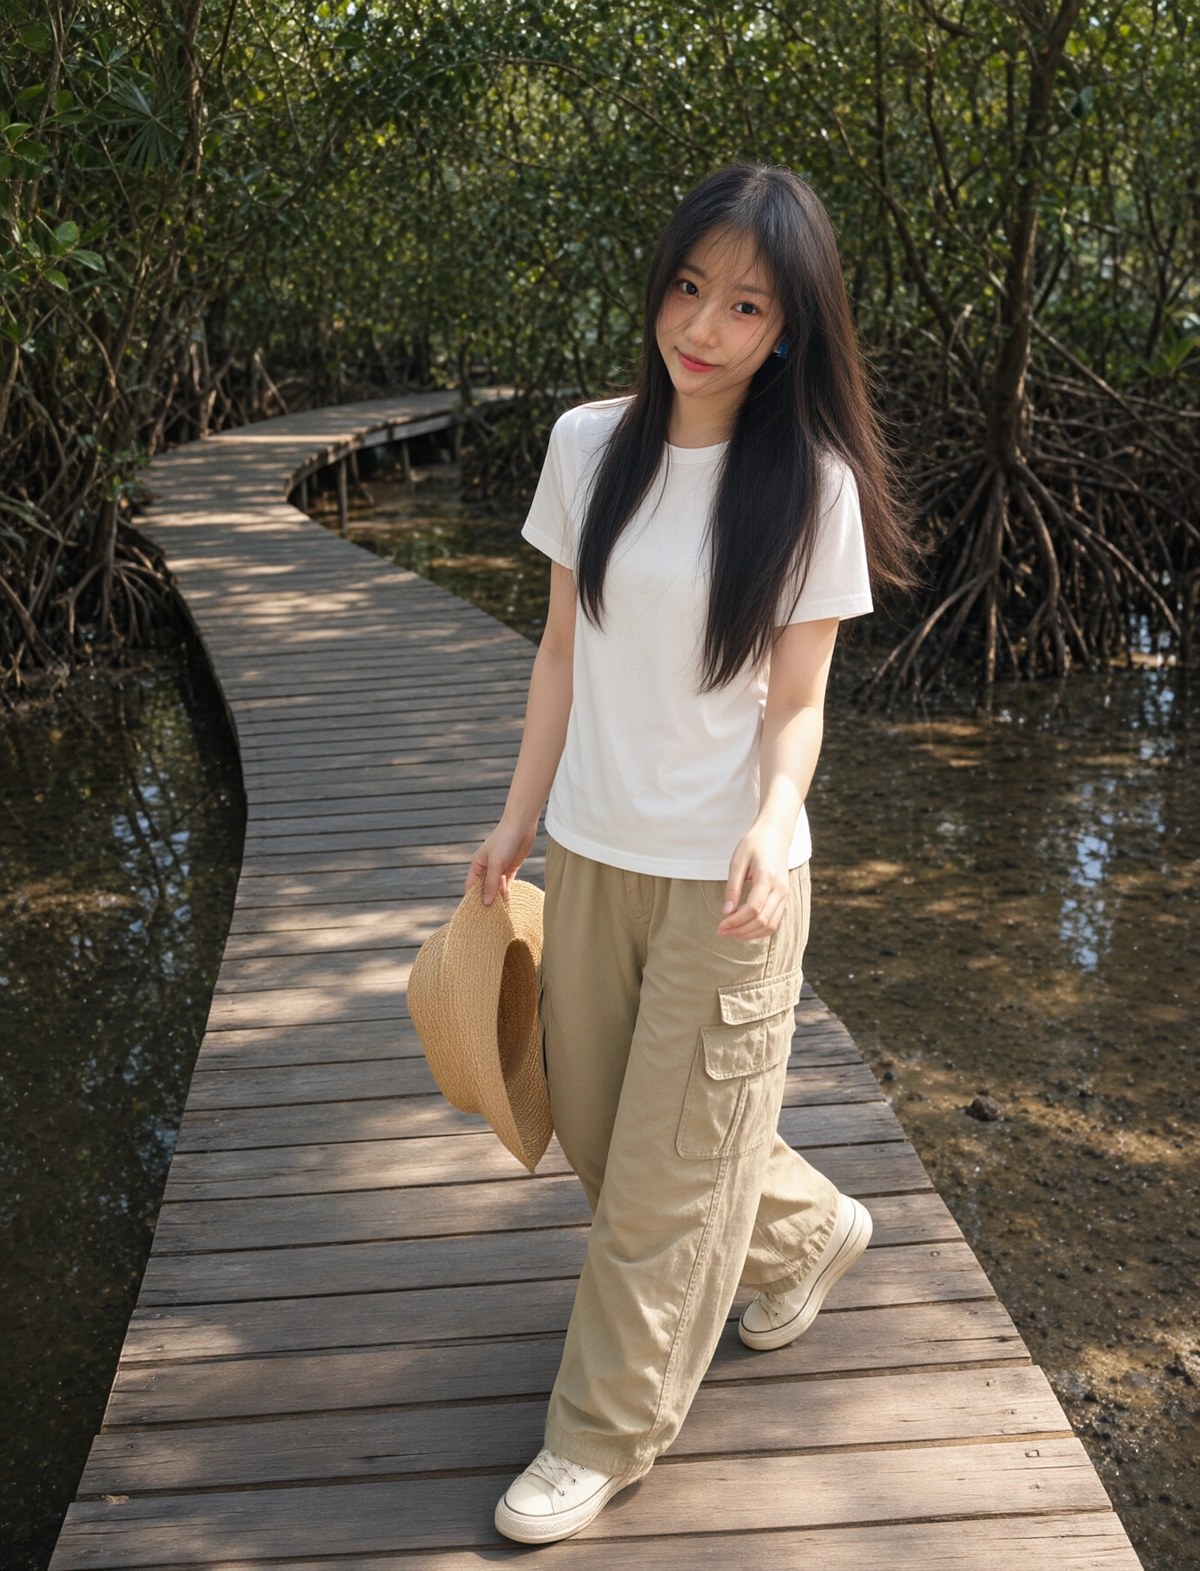
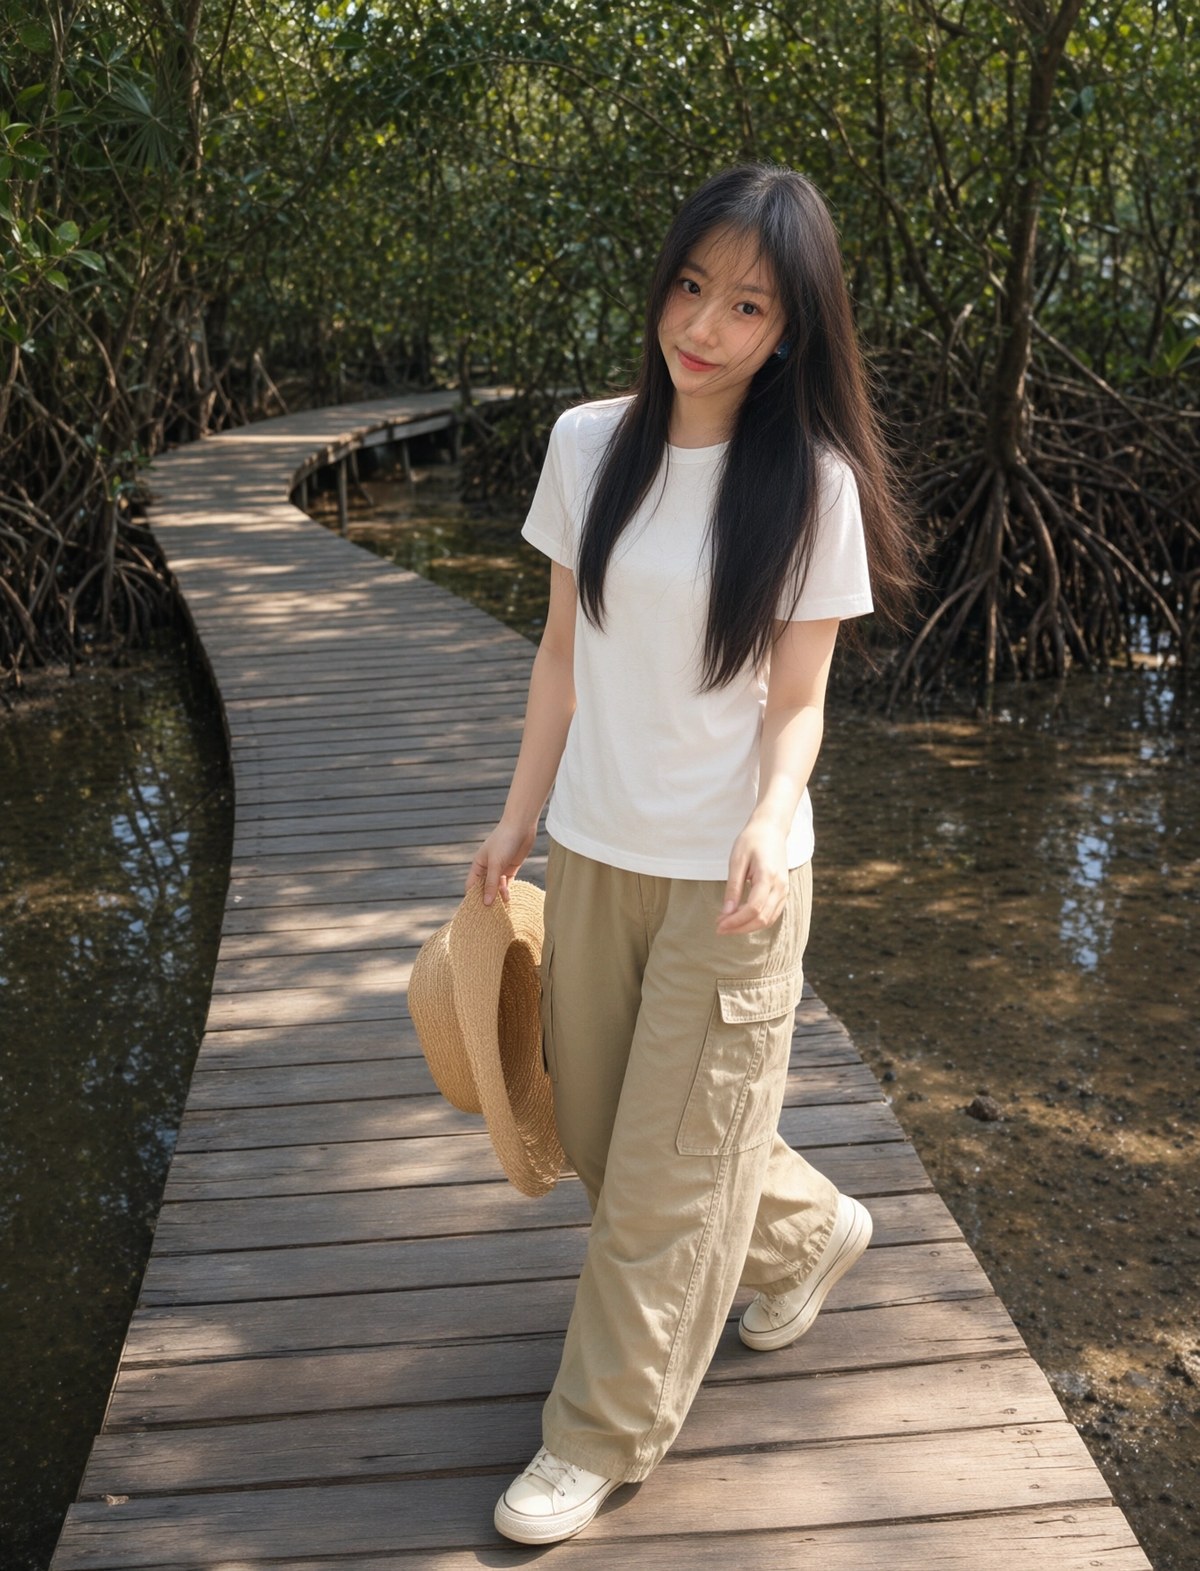
Les exemples ci-dessous proviennent de l'onglet Comparison du Space de démonstration de Viggle. Chaque colonne utilise le même prompt, les mêmes entrées, la même graine et le même bruit.
 |  |  |
|---|---|---|
| Modèle de base, 40 étapes | v0.3, 6 étapes | v0.3, 9 étapes |
Une référence de personnage transposée dans une scène de passerelle en mangrove à 1344x1760. Le résultat en 6 étapes est le plus propre des deux colonnes turbo ; 9 étapes ramène une partie de la texture fine.
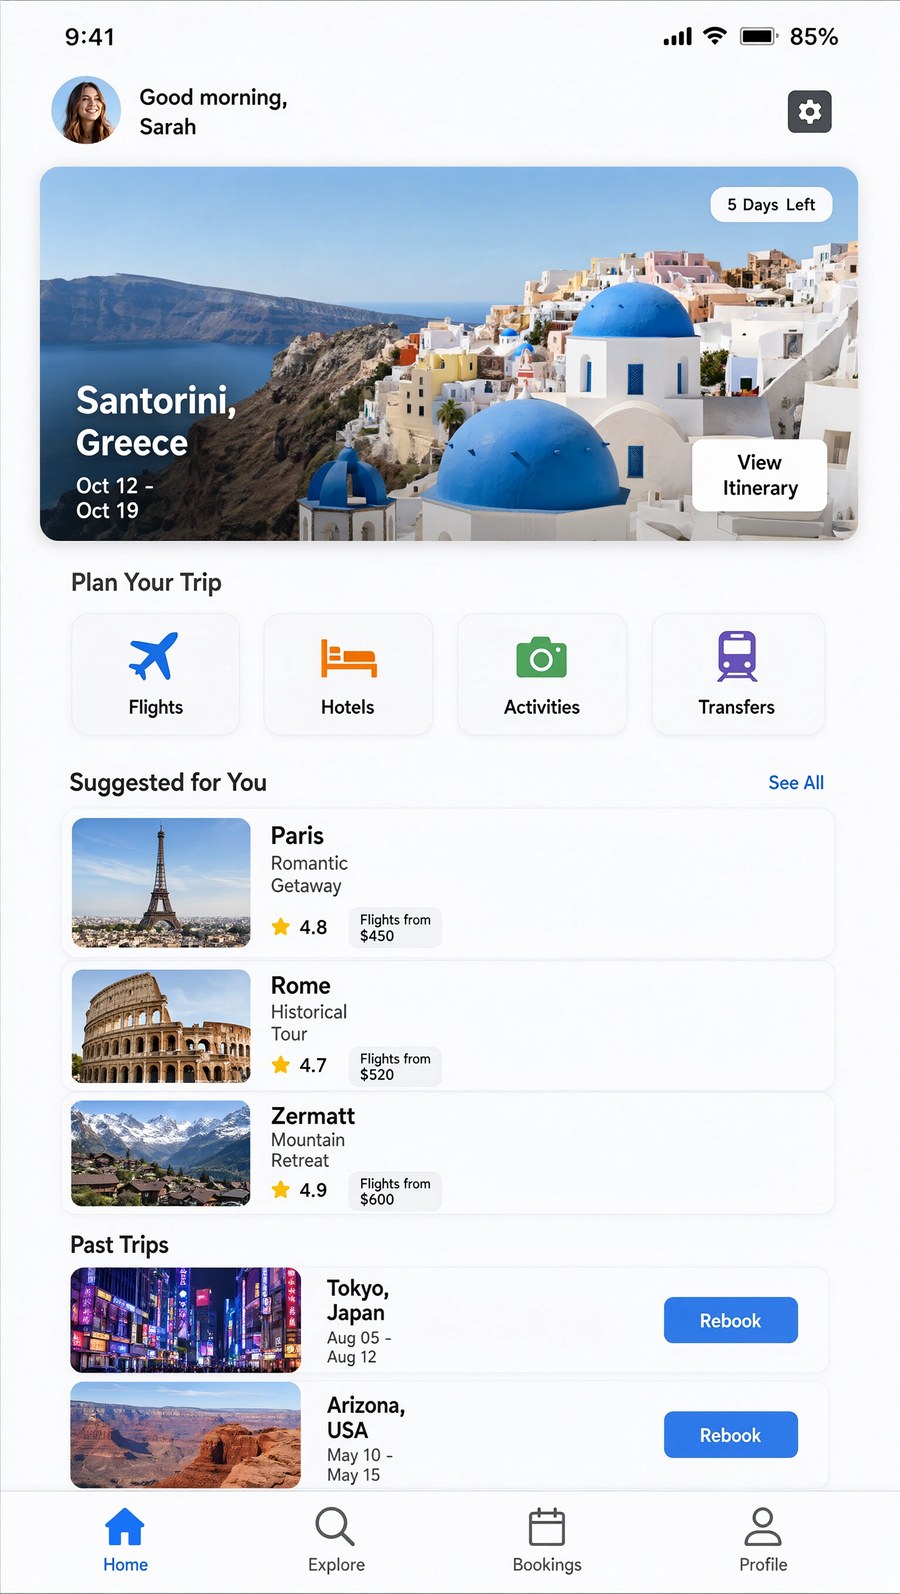
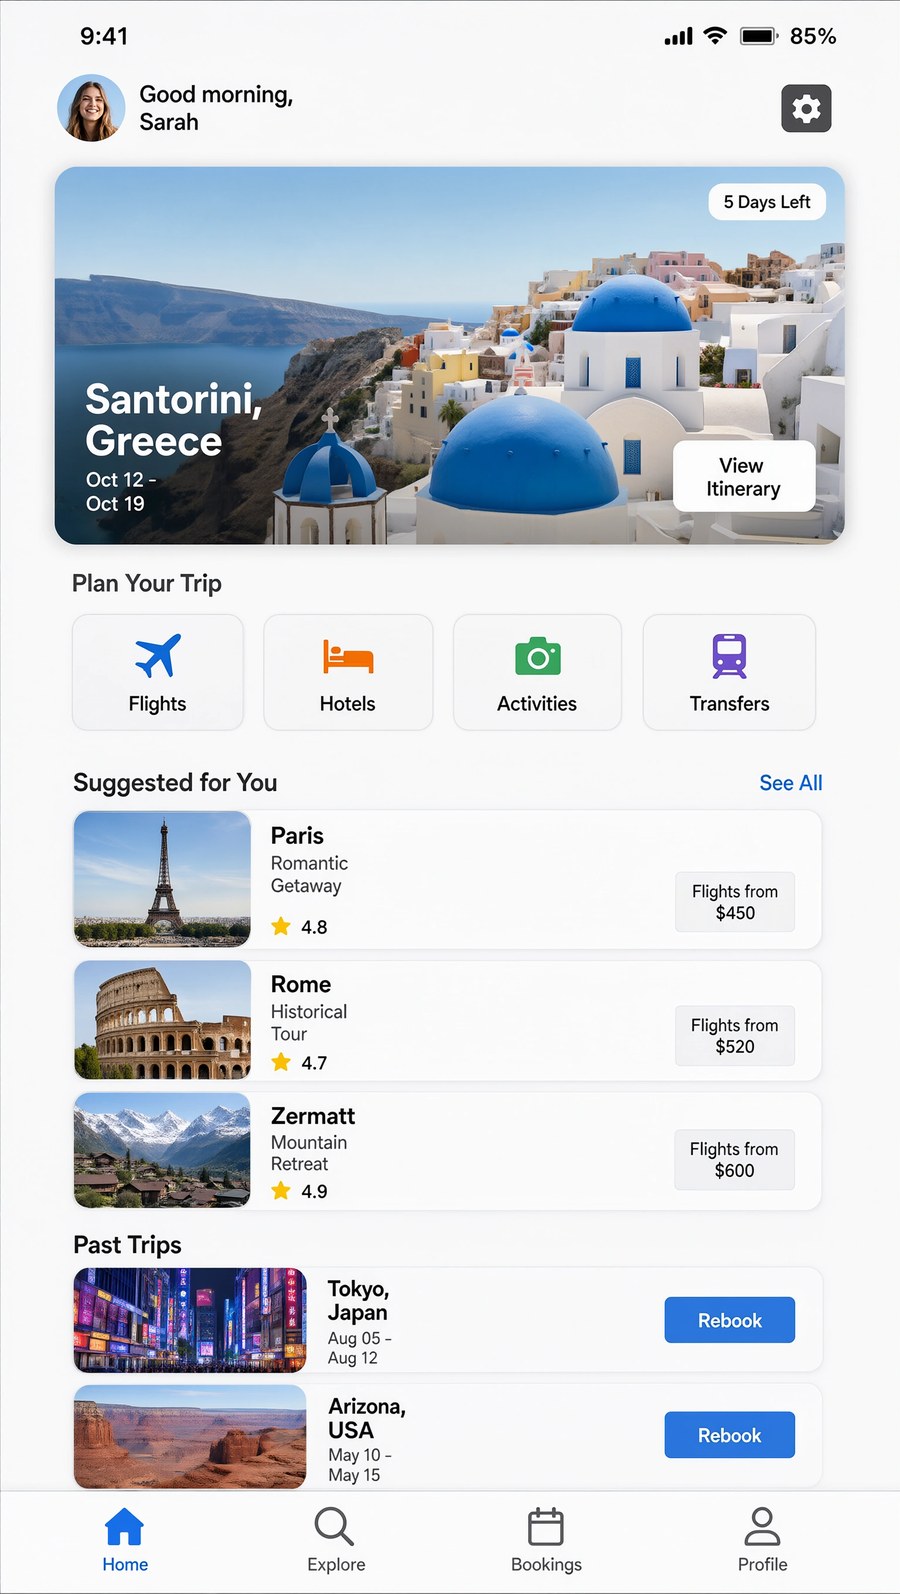
Le mode 9 étapes vise les deux endroits où l'élève 6 étapes reste en retrait par rapport au modèle de base : le texte dense rendu et les petits détails. Une capture d'écran verticale d'application contenant beaucoup de petits textes d'interface à 1536x2720 constitue un test de résistance raisonnable, et l'onglet de comparaison en exécute un.
 |  |
|---|---|
| Modèle de base, 40 étapes | v0.3, 9 étapes |
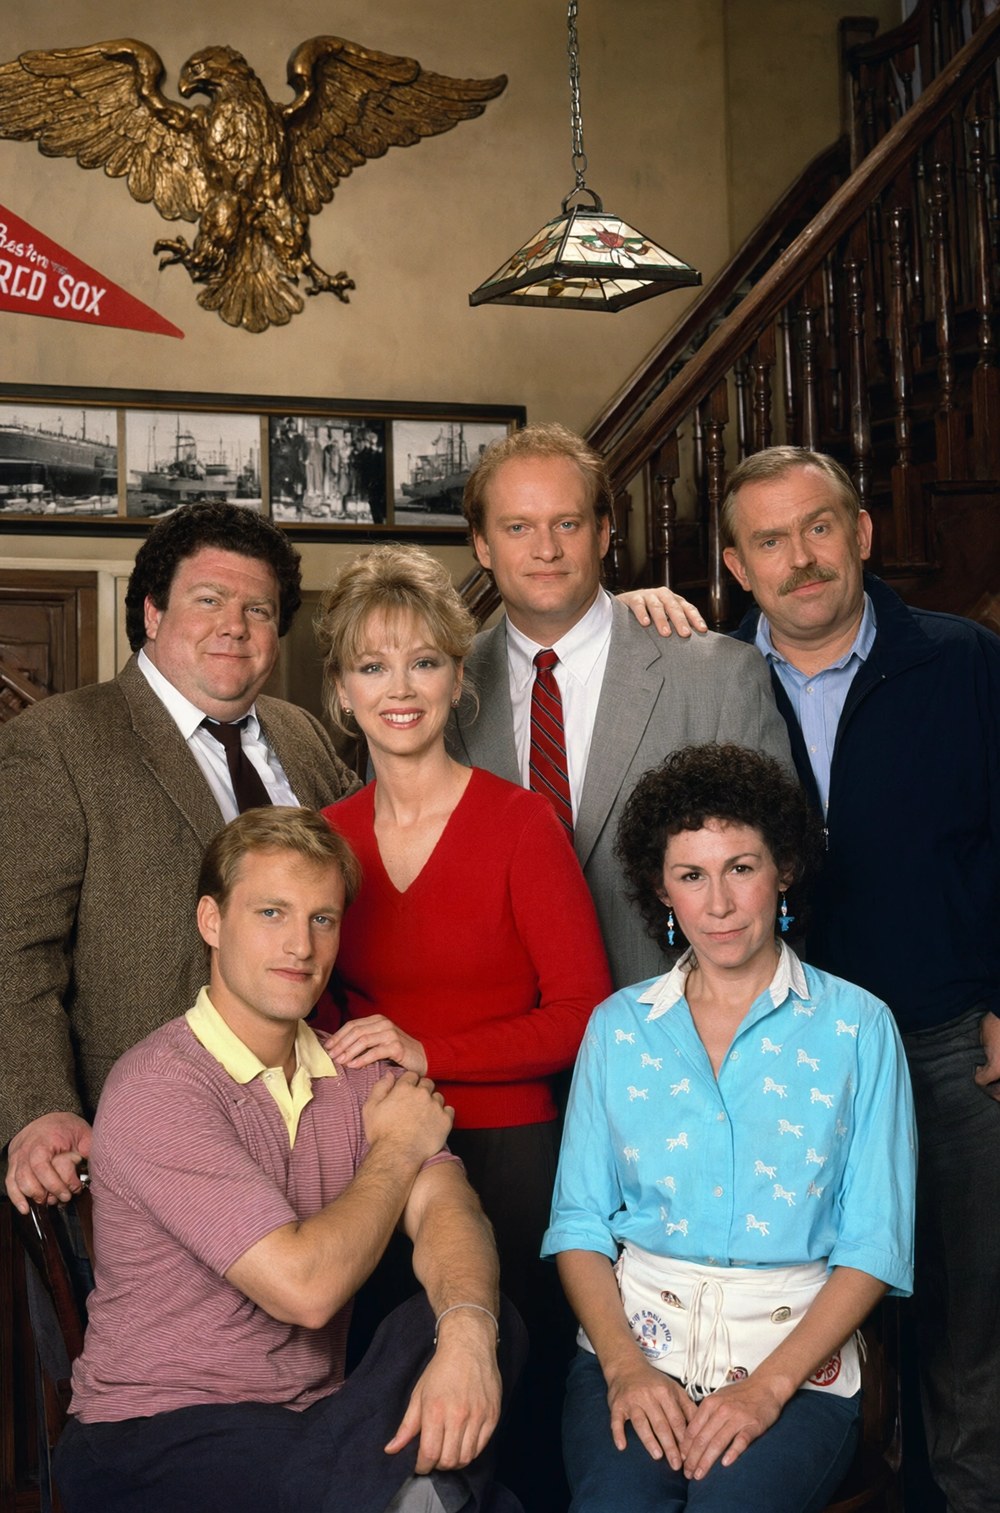
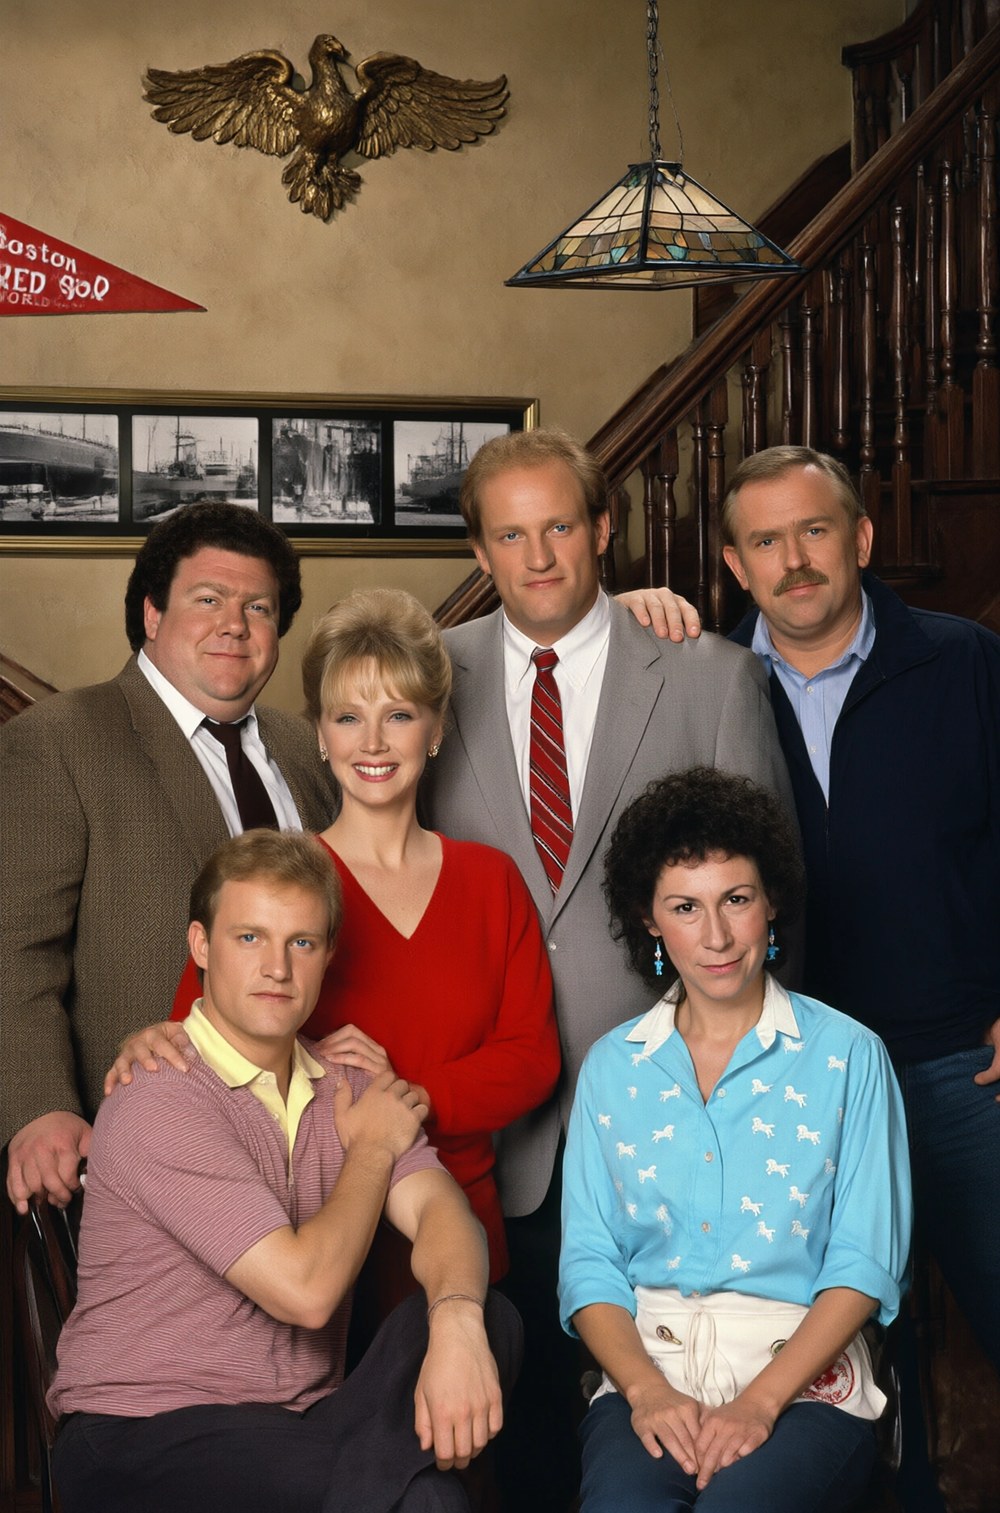
La distillation fonctionne aussi avec jusqu'à 3 images de référence dans diffusers, et le portrait de groupe à six images ci-dessous emprunte ce chemin : six identités, un prompt, un intérieur de bar.
 |  |
|---|---|
| Modèle de base, 40 étapes | v0.3, 6 étapes |
Vitesse
Mêmes comparaisons, temps par image en secondes tels que rapportés dans le Space de démonstration :
| Cas | Résolution | Base, 40 étapes | v0.3, 6 étapes | v0.3, 9 étapes |
|---|---|---|---|---|
| Portrait à partir d'une référence | 1344x1760 | 14,0 s | 2,9 s | 4,0 s |
| Portrait de groupe à six références | 1248x1888 | 25,8 s | 5,9 s | 8,8 s |
| Capture d'écran d'application dense | 1536x2720 | 26,9 s | 4,9 s | 6,8 s |
| Panorama à 360 degrés | 2176x1088 | 14,3 s | 2,9 s | 4,1 s |
Ce qu'il ne fait toujours pas
La carte du modèle est inhabituellement directe au sujet de l'écart restant. Les modifications compliquées restent le point faible de l'élève : la composition multi-références, les échanges de visage et les instructions préservant l'identité peuvent produire des figures dupliquées ou fantômes et une dérive d'identité. Les textes rendus petits ou longs se brouillent plus souvent qu'avec le modèle de base, et 9 étapes aident sans corriger le problème. Les couleurs ressortent quelques pourcents moins saturées. La sortie 2K, la sortie RGBA, les modifications guidées par masque et les modifications avec plus de 3 références ne sont vérifiées qu'à l'œil sur l'onglet de comparaison, sans benchmark annoncé.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.