LongLive-Plug : NVIDIA distille des LoRA few-step pour H3 et Wan
Le LongLive-Plug de NVIDIA distille des LoRA few-step, CFG et long-contexte une fois par backbone et les réutilise sur 54 modèles en aval, avec des poids pour MiniMax H3 et Wan.
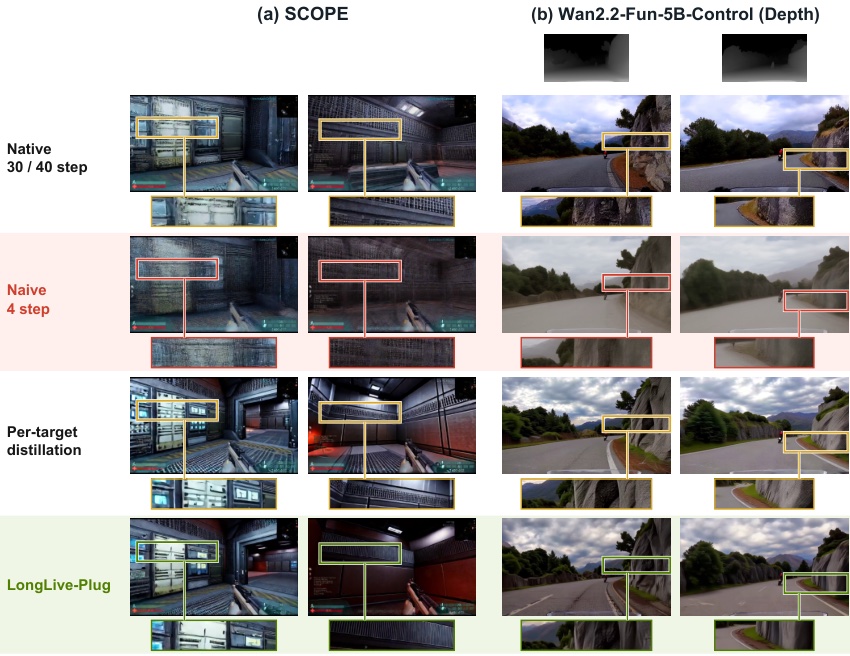
Images appariées issues de la figure 3 de l'article. Un échantillonnage naïf en quatre étapes (deuxième colonne) floute l'image ; les adaptateurs transférés (quatrième colonne) tiennent le coup à quatre étapes. Les encadrés marquent des coordonnées identiques entre les méthodes.
Une seule distillation, de nombreux modèles en aval
Construire un modèle vidéo spécialisé se termine souvent par une étape de distillation, pour réduire le nombre d'étapes d'échantillonnage ou pour que les longues générations tiennent ensemble. Cette étape est normalement répétée pour chaque modèle : collecter les données de la tâche, exécuter le teacher, optimiser à nouveau. Un fine-tune de Wan conditionné par la profondeur et un world model de robotique entraîné sur le même backbone payaient chacun pour leur propre LoRA few-step.
LongLive-Plug répartit ce travail en trois capacités, distillées une seule fois par famille de backbone, puis reportées comme des LoRA ordinaires :
- LoRA few-step : moins d'étapes d'échantillonnage, entraîné par appariement de distributions avec un teacher guidé par CFG.
- LoRA CFG : intègre le classifier-free guidance dans une seule passe conditionnelle.
- LoRA long-contexte : corrige l'accumulation d'erreurs dans les générations autoregressives causales.
Les adaptateurs sont conçus pour survivre aux changements qu'apporte un modèle en aval. L'ajout de branches de conditionnement ou l'élargissement des canaux de sortie ne les invalide pas, si bien que le même ensemble de fichiers s'attache à des fine-tunes complets, à des LoRA de tâche et à des modèles dotés de modules de contrôle supplémentaires.
Le poids CFG agit comme un bouton de réglage
Le guidance se paie normalement deux fois par étape : une passe conditionnelle et une passe inconditionnelle. Le LoRA CFG supprime la seconde passe, et comme le guidance est distillé dans l'adaptateur, le poids du LoRA lui-même devient le contrôle du guidance, même si l'adaptateur a été entraîné à une échelle fixe. L'augmenter renforce les attributs du prompt sans réexécuter la branche inconditionnelle.
Le détail important est que mettre à l'échelle tout le LoRA couplé ne produit pas le même effet : cela déplace en même temps l'update et le nombre d'étapes, et dégrade la sortie. C'est pourquoi les adaptateurs few-step et CFG sont des fichiers séparés, et pourquoi ils sont pondérés séparément. Le ratio recommandé par l'article est few-step : CFG = 1 : 0,5, et les fiches de modèle répètent que ces chiffres sont des poids d'adaptateur, pas l'échelle CFG native du modèle.
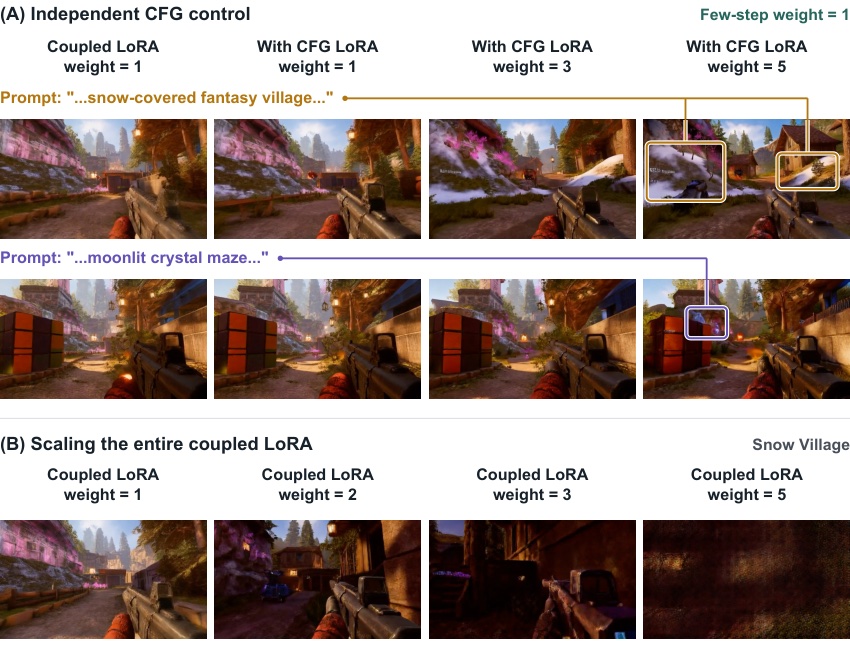
Figure 5 de l'article. Mettre à l'échelle le LoRA couplé seul ne répond quasiment pas au prompt ; ajouter un LoRA CFG pondéré séparément renforce les attributs encadrés tandis que le LoRA couplé reste fixe.
Ce qui a été publié
La collection Hugging Face contient six adaptateurs : un fichier few-step et un fichier CFG par backbone.
| Modèle de base | Adaptateur few-step | Adaptateur CFG | Remarques |
|---|---|---|---|
| MiniMax H3 | LongLive-Plug-MiniMax-H3-few-step (2,6 GB) | LongLive-Plug-MiniMax-H3-cfg (2,6 GB) | Format PEFT. Les fiches indiquent d'utiliser les deux séparément pour l'instant, l'usage combiné n'est pas encore recommandé |
| Wan2.1-T2V-14B | LongLive-Plug-Wan2.1-T2V-14B-few-step (1,2 GB) | LongLive-Plug-Wan2.1-T2V-14B-cfg | Livré avec un generator_lora_lightx2v.safetensors en plus de l'exportation PEFT |
| Wan2.2-TI2V-5B | LongLive-Plug-Wan2.2-TI2V-5B-few-step (1,3 GB) | LongLive-Plug-Wan2.2-TI2V-5B-cfg | PEFT adapter_model.safetensors |
Le fichier few-step de Wan2.1-14B est celui qui s'intègre directement dans un flux de travail Wan existant : il est exporté selon la nomenclature lightx2v que les chargeurs LoRA Wan de ComfyUI lisent déjà, donc il se place dans ComfyUI/models/loras/ comme n'importe quel autre LoRA d'accélération Wan. Les adaptateurs MiniMax H3 sont des exportations PEFT et nécessitent une conversion avant que ComfyUI puisse les charger ; Kijai a publié une version bf16 convertie sur Kijai/MiniMax-H3-experimental sous le nom minimax_h3_ELM_longlive_plug_4step_lora_bf16.safetensors (1,96 GB).
Couverture et coût
L'article vérifie un déploiement sans entraînement sur 54 modèles en aval répartis sur trois familles de backbone (24 sur Wan2.1-14B, 24 sur Wan2.2-TI2V-5B, six sur MiniMax H3) et huit catégories de tâches : modélisation du monde, robotique, génération conditionnée par la structure, contrôle de la caméra et de la trajectoire, montage et restauration vidéo, génération de sujet et d'avatar, génération audio et RGBA, et adaptation de style. Face aux planifications natives de 20 à 50 étapes, l'attachement des adaptateurs distillés sur le modèle de base donne une inférence en quatre étapes sans CFG, soit une réduction de 5x à 12,5x des étapes de débruitage.
L'argument du coût constitue l'autre moitié de l'article. La distillation de base représente environ 80 heures-GPU H100 (700 itérations sur 32 GPU, soit environ 2,5 heures). Distiller séparément les quatre tâches en aval coûte en plus 83,9 (profondeur), 150,0 (modélisation du monde), 86,8 (pose) et 56,1 (robotique) heures-GPU, soit environ 456,8 au total. Réutiliser les adaptateurs de base reste à environ 80 heures-GPU fixes, sans collecte de données spécifique à une tâche.
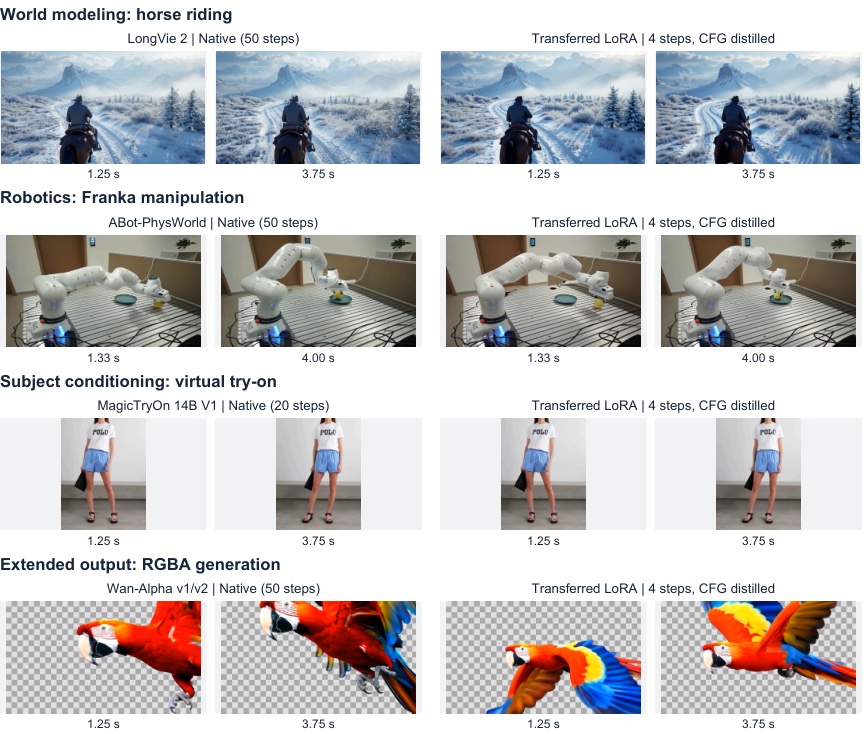
Figure 9 de l'article : LongVie 2, ABot-PhysWorld, MagicTryOn et Wan-Alpha, couvrant la modélisation du monde, la robotique, le conditionnement de sujet et la sortie RGBA, chacun comparant deux images natives aux mêmes horodatages après un transfert en quatre étapes.
MiniMax H3
La partie H3 de la publication est la plus restreinte. Six des 54 modèles vérifiés sont des H3, et l'article précise que ses dix comparaisons H3 sont des cas à graine unique sans intervalles de confiance sur des exécutions répétées, que la valeur native par défaut est un point de fonctionnement de référence et non une vérité terrain, et que des images statiques n'évaluent ni la qualité audio ni la synchronisation. Les exemples montrent que H3 en quatre étapes conserve mieux les contours des personnages qu'un échantillonnage Euler naïf en quatre étapes, même si l'apparence peut encore différer du résultat multi-étapes non distillé.
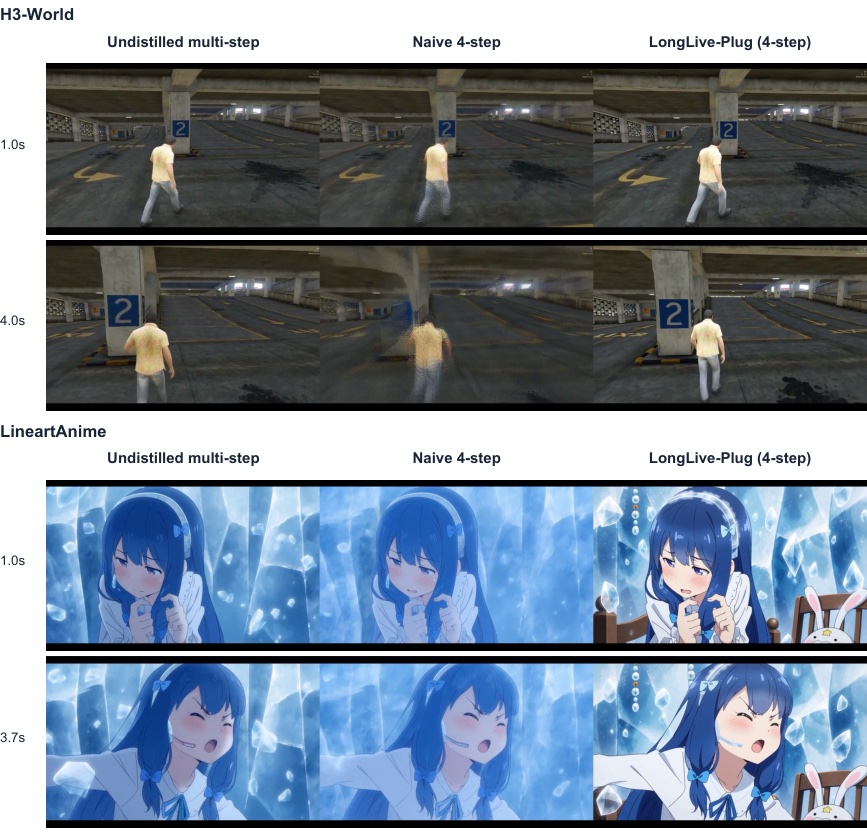
Figure 11 de l'article : H3-World sous une condition d'action vers l'avant et LineartAnime, comparant une inférence multi-étapes non distillée, un échantillonnage naïf en quatre étapes et une inférence en quatre étapes avec LongLive-Plug.
Limites
- L'idée de transfert fonctionne sur les backbones pour lesquels elle a été distillée. Wan2.1, Wan2.2 et MiniMax H3 ont chacun leur propre jeu d'adaptateurs, et l'article ne revendique pas de réutilisation entre familles.
- L'effet sur H3 est mesuré sur dix cas à graine unique sans intervalles de confiance, et la piste audio ne fait pas partie de l'évaluation.
- Pour MiniMax H3, les deux adaptateurs doivent être utilisés un à la fois pour l'instant, donc la vitesse few-step et le contrôle CFG ne peuvent pas encore y être combinés.
- Le contrôle du guidance est un réglage de poids, pas un nouvel échantillonneur : les fichiers few-step et CFG doivent être chargés et pondérés séparément pour obtenir les deux.
Disponibilité
Page du projet : nvlabs.github.io/LongLive/LongLive-Plug
Article : arXiv 2609.38154
Film de démonstration : YouTube
Poids : Efficient-Large-Model/longlive-plug
Conversion ComfyUI de l'adaptateur few-step H3 : Kijai/MiniMax-H3-experimental
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.