Looped-DiT : 260M de paramètres battent un modèle 6,5x plus grand
OpenSenseNova (SenseTime) publie Looped-DiT : des blocs transformer partagés réexécutés à chaque étape de débruitage permettent à un petit modèle de dépasser un modèle plus grand.
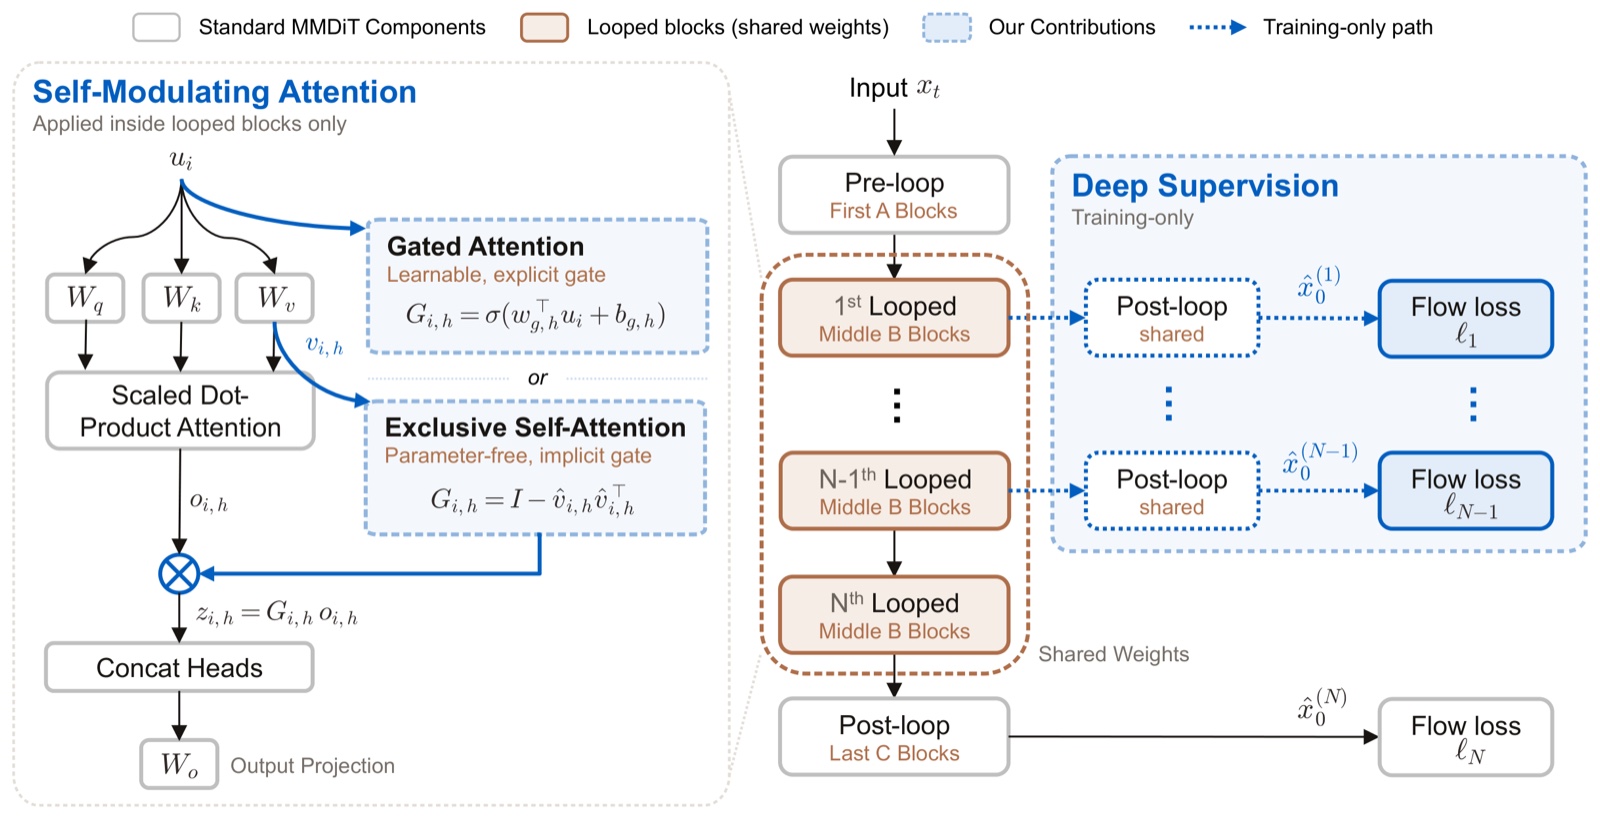
La méthode : un groupe de blocs partagé boucle N fois par étape de débruitage, avec une attention auto-modulante qui régule la boucle et une supervision profonde qui entraîne l'état après chaque passage.
Pourquoi un bouclage naïf échoue
Exécuter deux fois les mêmes blocs n'améliore pas de façon fiable un transformer de diffusion. L'article attribue cela à deux problèmes : une supervision faible entre les boucles intermédiaires, et des mises à jour d'attention qui érodent progressivement l'information locale à mesure que le nombre de boucles augmente. Looped-DiT ajoute deux composants pour y remédier :
- Deep Supervision décode l'état après chaque boucle via les blocs post-boucle et entraîne chacune de ces prédictions par rapport à la même cible d'image propre.
- Self-Modulating Attention régule les mises à jour d'attention à l'intérieur de la boucle, en utilisant l'attention auto-exclusive (XSA) ou une porte d'attention par tête.
Le backbone est le MMDiT en espace pixel de MiniT2I, conditionné par un FLAN-T5-Large gelé. Le référentiel couvre l'entraînement pour B/32, B/16 et L/16, l'inférence à n'importe quelle profondeur de boucle, l'évaluation sur six benchmarks et des scripts de préparation de jeux de données pour chaque ensemble d'entraînement.
Résultats
Les scores utilisent les poids EMA, 100 étapes d'Euler, un guidance de 6,0 et une profondeur de boucle de 4 :
| Modèle | Patch | GenEval | DPG | PRISM | CoRe | Spatial | TIIF | Moy. |
|---|---|---|---|---|---|---|---|---|
| Looped-DiT B/32 | 32 | 85.1 | 85.3 | 54.4 | 44.5 | 52.3 | 76.1 | 66.3 |
| Looped-DiT B/16 | 16 | 87.4 | 87.0 | 67.0 | 53.5 | 54.6 | 79.7 | 71.5 |
L'affirmation qui compte se trouve dans le résumé de l'article : dans des configurations à paramètres et à calcul équivalents, la conception bouclée surpasse systématiquement les références non bouclées, et des boucles plus profondes apportent davantage que des étapes de débruitage supplémentaires sous un budget d'inférence fixe. Les auteurs rapportent aussi que des boucles plus profondes corrigent progressivement les erreurs commises dans les boucles antérieures, un comportement qu'ils décrivent comme suggérant un raisonnement latent.
Comment l'exécuter
Les deux checkpoints sont publiés sous forme de fichiers PyTorch, sensenova/Looped-DiT-B16 et sensenova/Looped-DiT-B32, et l'inférence se fait par un seul appel de module. --loops définit la profondeur de boucle, et fournir plusieurs profondeurs génère une ligne pour chacune, ce qui permet de comparer la profondeur sur un même prompt :
hf download sensenova/Looped-DiT-B16 looped-dit-b16.pt --local-dir checkpoints

python -m looped_dit.sample --checkpoint checkpoints/looped-dit-b16.pt \
    --prompt "a red cube on top of a blue sphere" --loops 1 2 3 4 --out loops.png
Les principaux résultats de l'article utilisent Euler avec 100 étapes, un guidance de 6,0 et une profondeur de boucle de 4 en 512x512 sur les poids EMA en bfloat16. La profondeur 4 est la profondeur entraînée, mais les auteurs notent que d'autres profondeurs fonctionnent sans réentraînement ; le nombre de boucles est donc un réglage au moment de l'inférence plutôt qu'une propriété fixe du checkpoint.
Disponibilité
Il s'agit d'une publication de recherche, pas d'une intégration ComfyUI. Il n'existe actuellement aucun nœud ComfyUI, aucun reconditionnement Comfy-Org et aucun pipeline diffusers : l'exécuter implique donc l'environnement Python du référentiel lui-même, à savoir une version CUDA de PyTorch 2.1 ou plus récente, requirements.txt, et les piles d'évaluation (mmdet, vLLM, modelscope) installées séparément, car les données de benchmark et les poids Mask2Former ne sont pas fournis. Vu la date de publication et les 51 étoiles GitHub accumulées jusqu'ici, un portage communautaire ne serait pas surprenant, mais rien n'existe au moment de la rédaction.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.