Turbo8 : LoRA de distillation en 8 étapes pour Qwen-Image 2.1
Turbo8 distille Qwen-Image 2.1 en 8 étapes sans CFG : génération, édition, sortie RGBA et extraction de sujet, avec deux workflows ComfyUI prêts à l'emploi.
Qwen-Image 2.1 a suscité plusieurs approches en quelques étapes depuis sa sortie le 20 septembre 2026 : les LoRA Pruna 5 étapes et 8 étapes, le LoRA turbo de Viggle, et la distillation Fun Acc officielle en 4 étapes d'Alibaba PAI. Turbo8 est une contribution communautaire dans cette même course, et son point distinctif est l'étendue : au lieu d'accélérer uniquement la génération texte-image, il est entraîné à préserver le comportement de l'ensemble du modèle de base, y compris les chemins RGBA et d'édition multi-références que les adaptateurs antérieurs géraient moins bien.
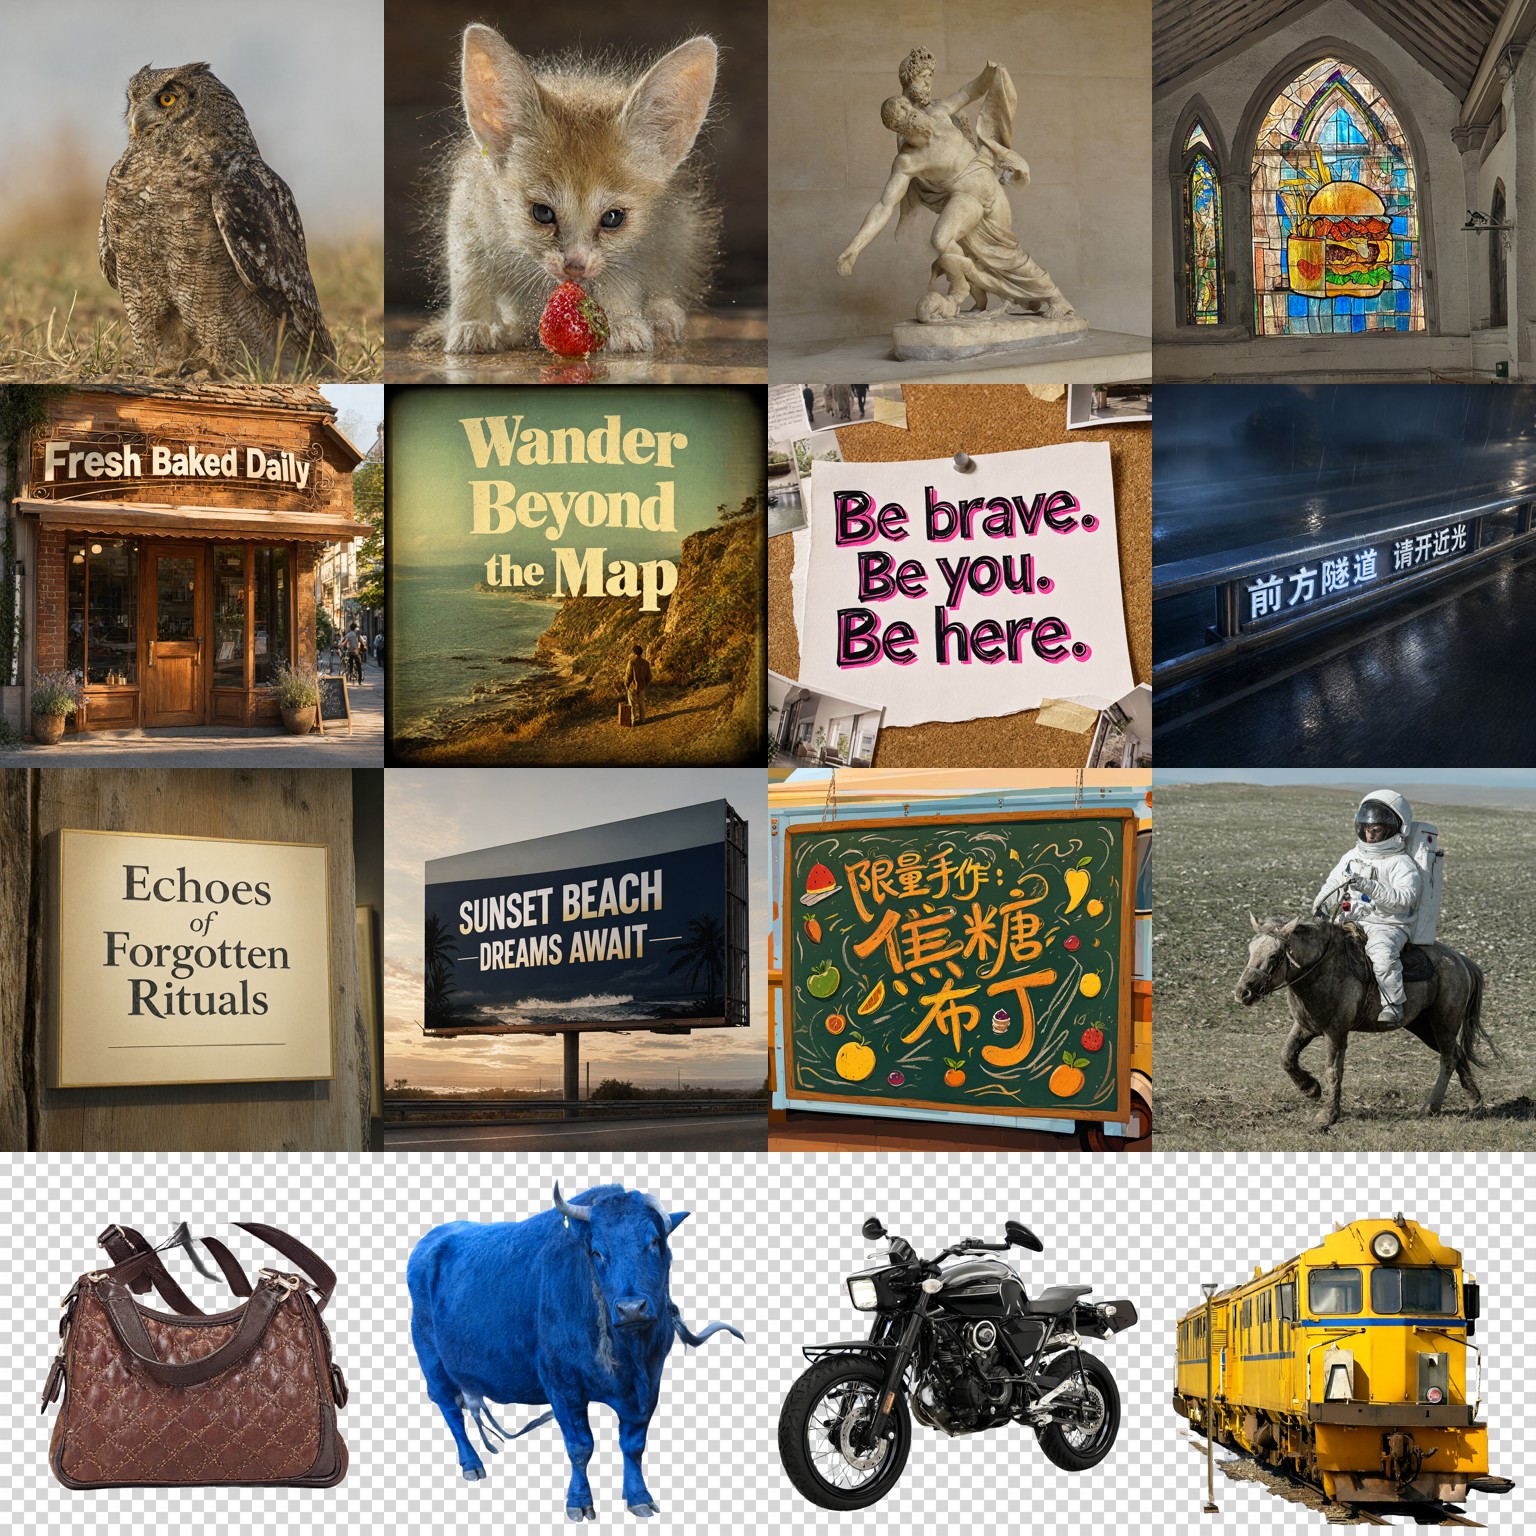
Tous les échantillons utilisent Turbo8 avec 8 étapes et CFG 1 en 1024², première graine, sans sélection parmi les résultats au sein d'un même prompt. Les prompts ont été choisis pour l'affichage dans l'ensemble d'évaluation mis de côté. Source : Turbo8-LoRA-Qwen-Image-2.1.
Ce qu'il fait
L'adaptateur est un LoRA de rang 128 appliqué aux calques d'attention, MLP, de modulation et d'embedding de pas de temps de Qwen-Image 2.1, distillé de façon à laisser les poids de base intacts. À l'inférence, il tourne avec 8 étapes, CFG 1, sampler euler, scheduler simple, et l'auteur note que dépasser 8 étapes ou aller au-delà de CFG 1 n'améliore pas les résultats.
La promesse est une couverture plutôt qu'une seule tâche : génération texte-image jusqu'à la résolution native de 2K du modèle, rendu de texte en anglais et en chinois, édition par instruction avec jusqu'à 10 images de référence, génération transparente, et extraction de sujet (fournir une photo et demander un détourage RGBA). La carte du modèle documente aussi la méthode d'entraînement, une recette en trois étapes : 3 100 rendus de l'enseignant à bruit fixe en 40 étapes, enregistrés aux 8 niveaux de bruit de l'étudiant, 3 000 étapes de régression de trajectoire, puis 2 500 étapes d'appariement de distribution DMD2 avec un critique de faux score et une tête GAN. Le critique est un second LoRA appliqué au même transformer gelé.
L'exécuter dans ComfyUI
Turbo8 cible directement la prise en charge native de Qwen-Image 2.1 dans ComfyUI :
- Placez
turbo8_lora_step2500.safetensorsdansComfyUI/models/loras/. - Chargez
comfyui/turbo8_t2i.json(texte-image et RGBA) oucomfyui/turbo8_edit.json(édition et extraction). - Conservez steps 8, CFG 1, sampler
euler, schedulersimple.
Le graphique T2I inclut un nœud ModelSamplingFlux (max_shift 0,6935, base_shift 0,5) relié à la largeur et à la hauteur, ce qui reproduit le programme de bruit dépendant de la résolution avec lequel le LoRA a été distillé, y compris en 2K. D'après la carte du modèle, les 227 calques du LoRA sont tous mappés dans ComfyUI et une image en 1024² prend environ 4 secondes sur une RTX PRO 6000.
Comparaison avec le modèle enseignant
La carte du modèle évalue Turbo8 face à son propre enseignant, le modèle de base à 40 étapes, sur 192 prompts mis de côté : DrawBench plus des graines supplémentaires, des prompts de rendu de texte, des sujets RGBA, des éditions et extractions OmniEdit.
| Métrique | Enseignant (40 étapes) | Turbo8 (8 étapes) |
|---|---|---|
| PickScore, T2I | 22,15 | 21,94 |
| CLIPScore, T2I | 26,89 | 26,89 |
| PickScore, RGBA | 20,51 | 20,07 |
| Correspondance exacte du texte (OCR) | 95,0 % | 75,0 % |
| Précision des caractères du texte | 99,6 % | 95,3 % |
| Taux de transparence (RGBA + extraction) | 0,875 | 0,925 |
| Diversité des graines (plus bas = plus varié) | 0,705 | 0,670 |
| Similarité d'édition avec l'enseignant (DINOv2) | n/a | 0,967 |
| IoU alpha d'extraction vs enseignant | n/a | 0,85 |
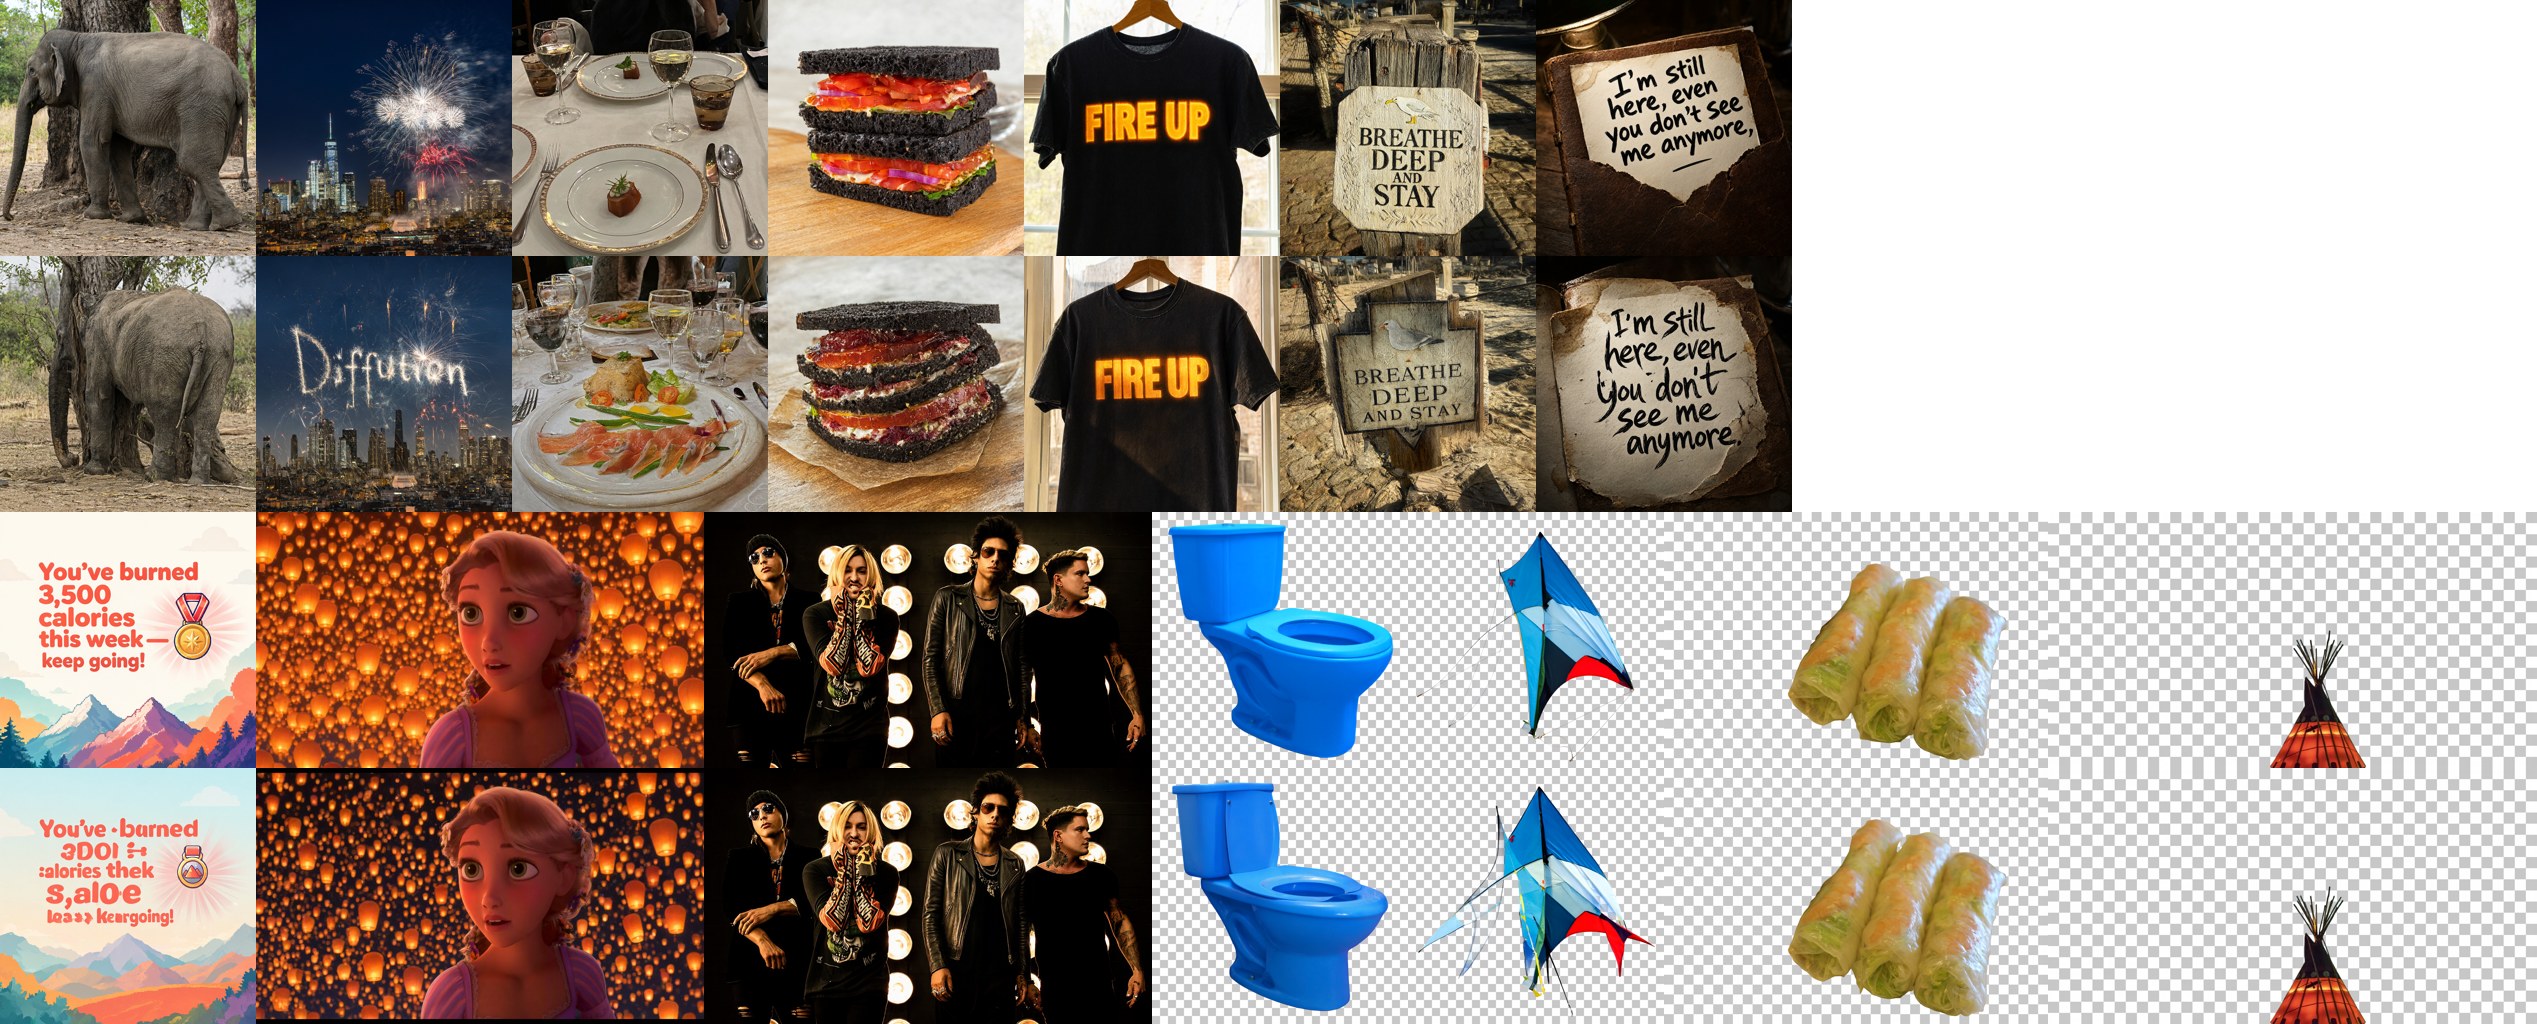
Enseignant à 40 étapes (rangée supérieure de chaque paire) contre Turbo8 à 8 étapes (rangée inférieure), même graine. Les échantillons couvrent la génération texte-image, le rendu de texte, les éditions, le RGBA et l'extraction.
Limitations documentées
La carte du modèle énumère les lacunes plutôt que de laisser les utilisateurs les découvrir :
- Le texte dense ou long (paragraphes, petits caractères) se dégrade bien davantage qu'à 40 étapes, tandis que les titres courts, les panneaux et les étiquettes restent fiables.
- Sur certaines scènes chargées, la composition peut différer de celle de l'enseignant à graine identique.
- L'extraction hérite des cas d'échec du modèle de base : dans l'évaluation, 3 extractions sur 16 sont ressorties vides, aussi bien pour l'enseignant que pour Turbo8, et Turbo8 conserve parfois davantage de contexte autour du sujet dans le détourage.
Dans la communauté
Dans le canal #qwen-image de Banodoco, les utilisateurs ont testé Turbo8 face aux approches en quelques étapes antérieures durant les jours suivants. Le constat commun est qu'il faut réduire la force et dépasser 8 étapes pour que l'édition tienne : les retours convergent autour d'une force de 0,65 et d'environ 16 étapes avant l'apparition d'artefacts corporels, et plusieurs utilisateurs le classent devant le turbo Viggle en 6 étapes pour les éditions, tout en préférant le programme en 8 étapes de Pruna pour certains travaux.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.