LoRA Character Swap de MiniMax H3: remplacer un personnage
Le LoRA d'Akatz Labs pour MiniMax H3 Ref2VA remplace une personne d'une vidéo de référence par un personnage fourni en image, poids et dataset ouverts.
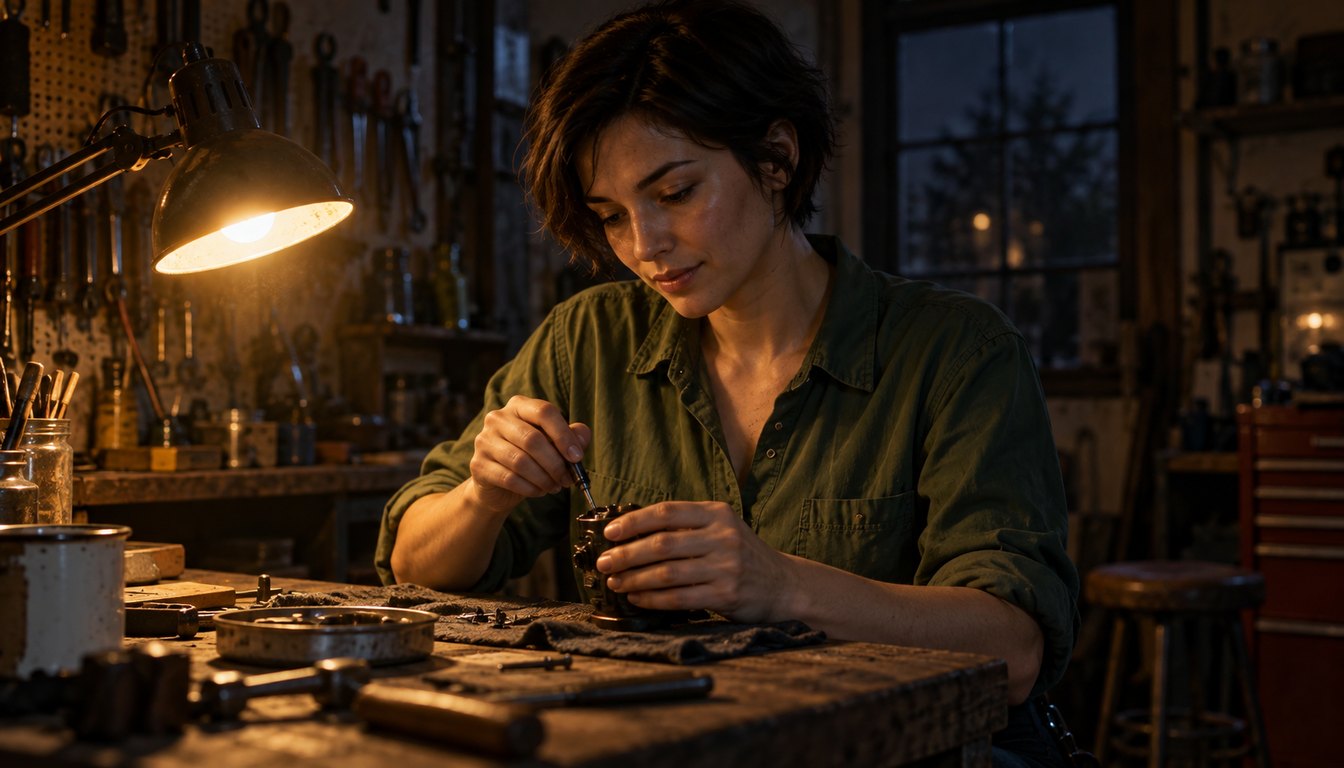 | 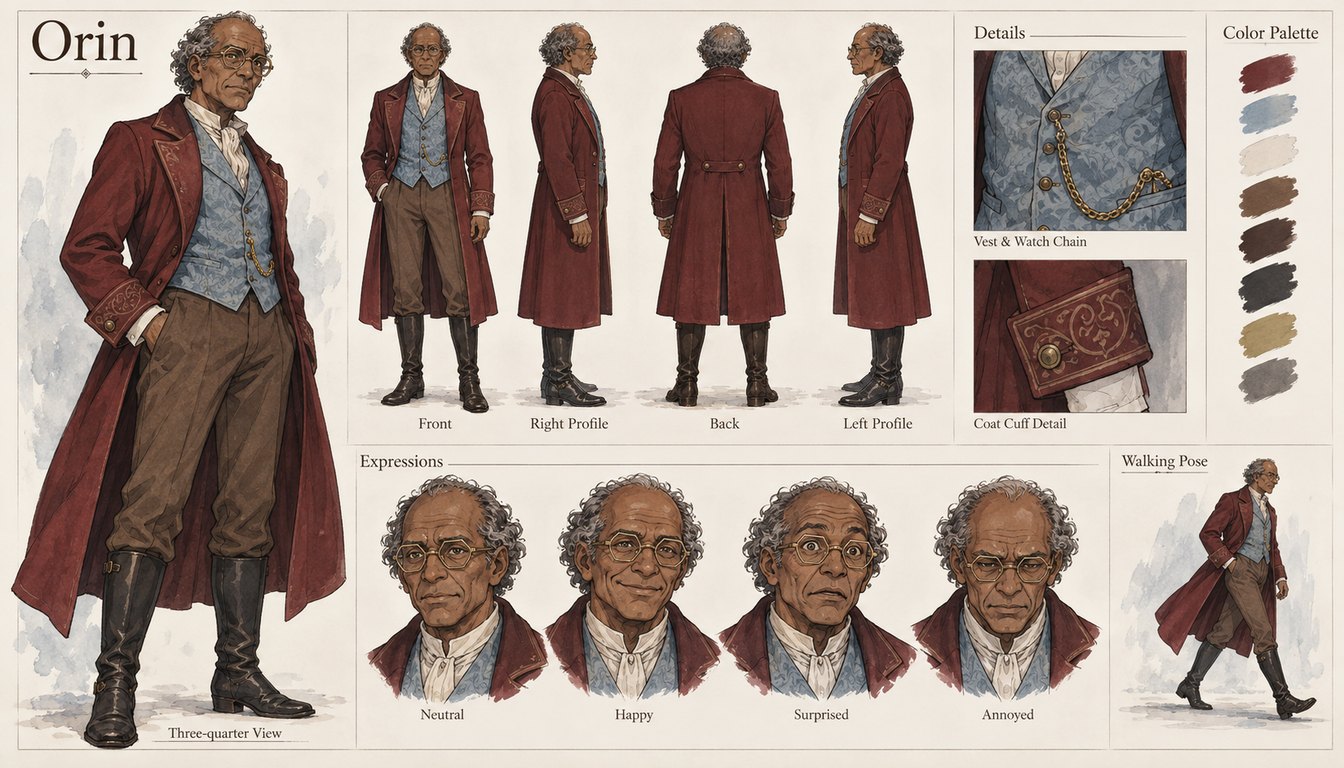 | 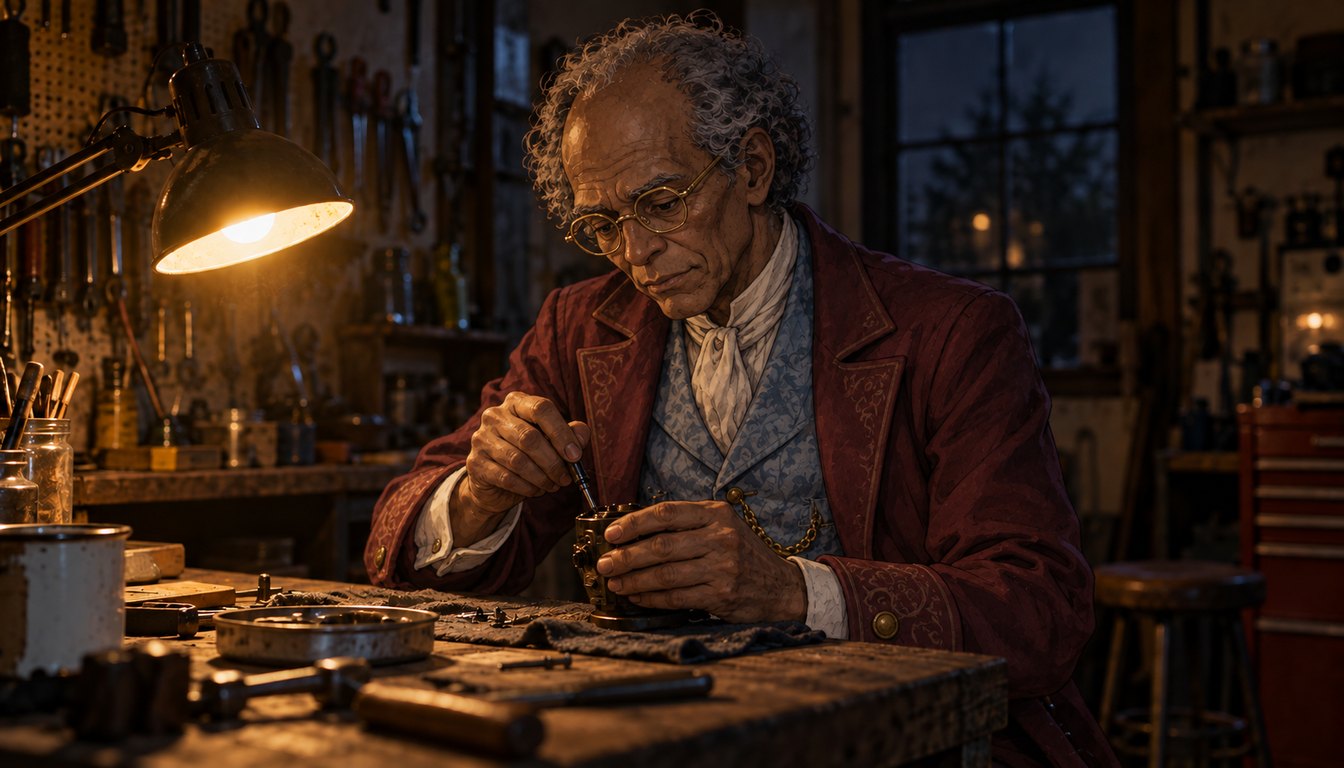 |
|---|---|---|
| Image de la vidéo source | Référence de planche de personnage | Cible du jeu de données : le personnage remplacé |
Un exemple d'entraînement issu du jeu de données publié, présenté sous forme d'image source, de planche de personnage et de cible éditée que le LoRA a été entraîné à produire. Source : H3 Character Swap v1.
La tâche est plus large qu'un simple transfert d'identité. Le LoRA H3 FaceSwap déplace un visage sur la performance déjà présente dans le clip ; cet adaptateur copie le personnage de remplacement dans son intégralité, y compris sa tenue et son médium de rendu, tout en préservant à son tour le médium de la scène source. C'est ce qui rend possibles les échanges entre styles : un personnage illustré intégré à des images réelles conserve son apparence illustrée, et 34 des 94 modifications d'entraînement ont été construites exactement de cette manière.
Ce que contient le jeu de données
Akatz Labs a entraîné l'adaptateur sur H3 Character Swap v1, un jeu de données conditionné par référence publié en même temps que les poids :
- 134 exemples : 94 modifications de remplacement de personnage et 40 clips de préservation. L'entraînement a utilisé 76 modifications et 32 clips, avec 18 modifications et 8 clips mis de côté.
- Les modifications sont construites à partir d'une seule image fixe chacune. La scène est fournie sous forme de vidéo statique de cinq images (
<Video 1>), le remplacement arrive sous forme d'image ou de planche de personnage (<Picture 1>), et chaque paire porte une courte instruction de ciblage telle queSwap the man in the purple shirt in <Video 1> with the character in <Picture 1>. - Couverture des styles croisés et des planches. 34 modifications échangent entre styles de rendu et 20 utilisent des planches de personnage complètes, les planches portrait, carré et paysage étant conservées dans leur rapport d'aspect d'origine.
- Les clips de régularisation sont des exemples explicites de préservation. La même vidéo sert à la fois de contrôle et de cible avec la légende
Keep <Video 1> unchanged. - Un seul personnage à la fois. Les remplacements de plusieurs personnages n'ont pas été supervisés dans les cibles d'entraînement.
L'adaptateur lui-même est un LoRA de rang 16, de 148 Mo, entraîné pendant 1 000 mises à jour sur la base Ref2VA INT8 élaguée de Comfy-Org/MiniMax-H3 avec l'assistant d'entraînement Ostris. Seul le checkpoint final est publié, et le lanceur d'entraînement ainsi que la configuration d'exécution sont fournis dans le référentiel sous training/.
Autres exemples
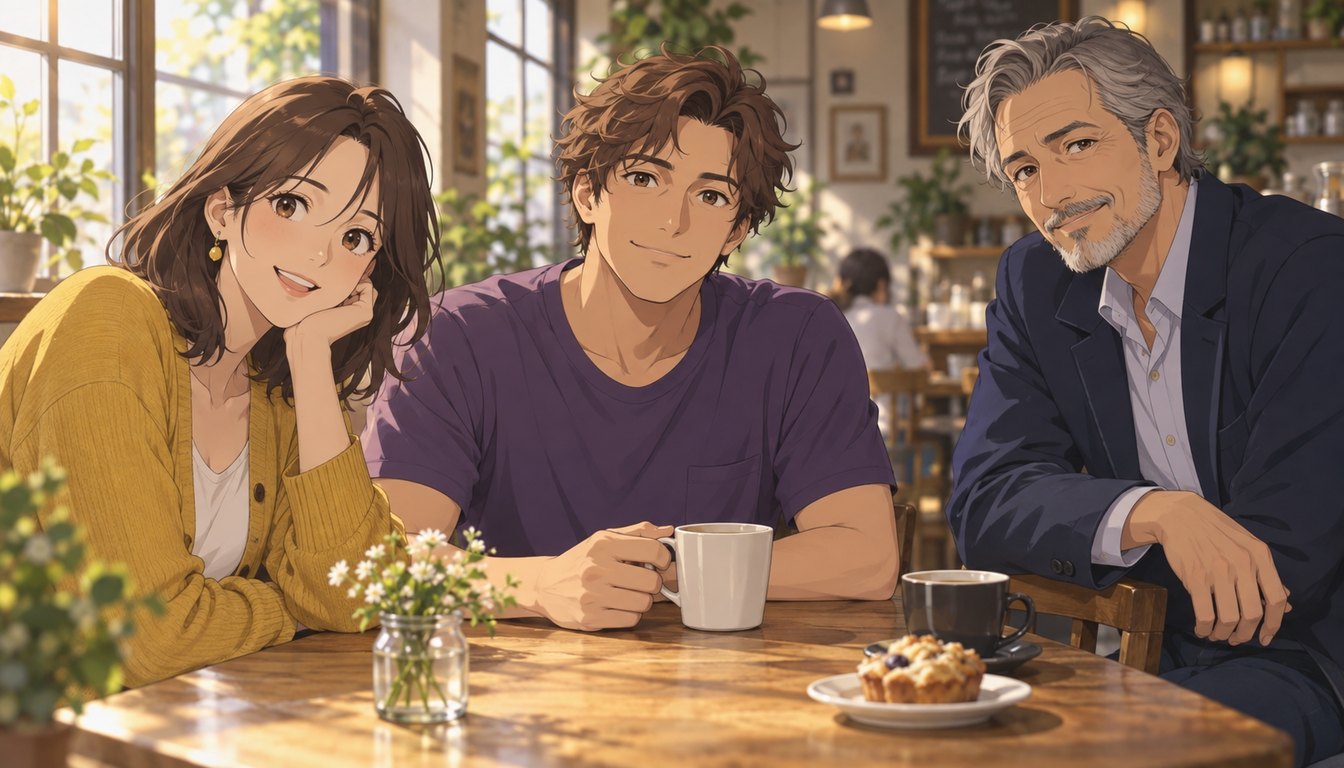 | 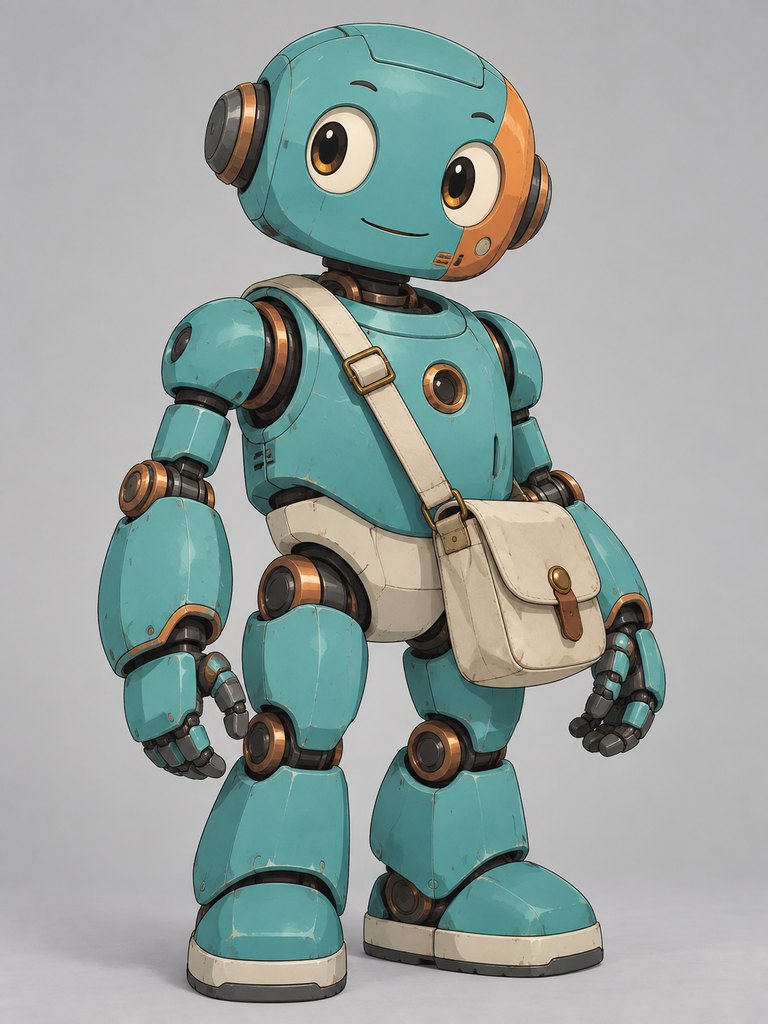 | 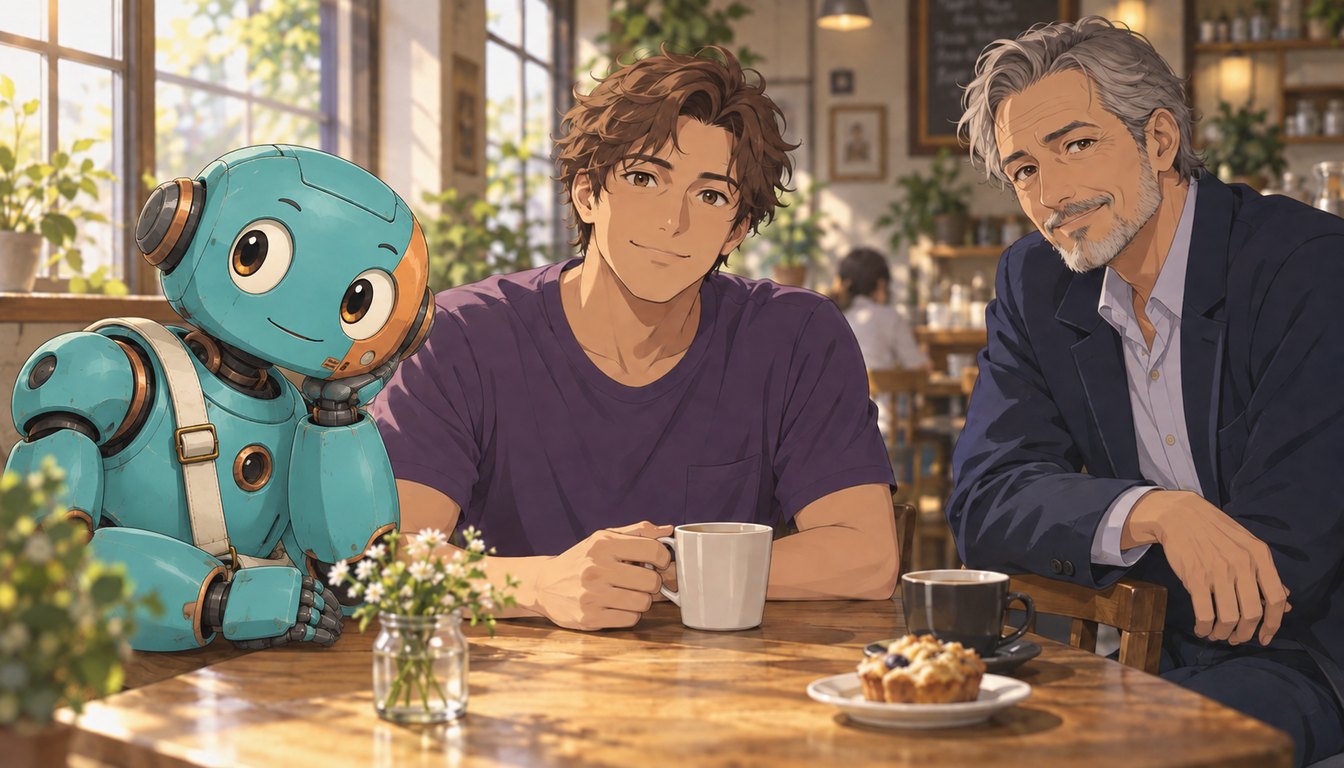 |
|---|---|---|
| Image de la vidéo source | Référence de personnage en portrait | Cible du jeu de données : le personnage remplacé |
Une deuxième paire d'entraînement, celle-ci conditionnée par une référence en portrait plutôt que par une planche.
Ce qu'il fait bien, et où il échoue
La comparaison de l'auteur lui-même avec le modèle de base est limitée et mérite d'être lue avant de télécharger :
- Meilleure préservation de la scène. Dans les comparaisons côte à côte, l'adaptateur conservait les arrière-plans et la structure de la scène plus fidèlement à la source que le modèle de base, mais l'auteur qualifie ces évaluations de qualitatives plutôt que de benchmark.
- Dérive sur les clips longs. Le cadrage, le placement et le timing source dérivent sur les fenêtres plus longues, et les coupes franches peuvent dégénérer en un lent repositionnement au lieu d'une modification.
- Expressions peu fiables. Les expressions faciales en gros plan ne suivent souvent pas la performance originale, et des instructions d'expression plus fortes supprimaient parfois complètement le remplacement.
- Les clips courts sont idéaux. Les plans continus d'environ 4 à 5 secondes tenaient mieux que les tentatives complètes de 14 secondes de l'auteur ; aucune durée maximale précise n'a été établie.
- Pas de mot déclencheur. Le ciblage provient du prompt, et la carte précise explicitement que la formulation du prompt ne garantit pas un alignement strict avec la source.
Les testeurs de Banodoco se sont heurtés au même mur. Charlie a réalisé un test de dix secondes avec l'adaptateur sur un modèle H3 hybride FL2VA/Ref2VA et a rapporté qu'il tenait environ cinq secondes, une tentative de 15 secondes se transformant en image floue, tandis qu'un autre testeur a noté que la pose et l'action de la personne d'origine doivent encore être décrites dans le prompt, sinon le remplacement ne copie pas le mouvement.
La raison de cette dérive est structurelle : comme chaque cible de modification était une image fixe, le modèle n'a jamais vu de cible de remplacement de personnage en mouvement montrant comment maintenir une performance dans le temps. Akatz Labs a candidaté au programme de subventions de calcul de Banodoco avec ce diagnostic et a été approuvé pour 40 heures de H100 afin de tourner 12 à 24 paires vidéo en mouvement couvrant les expressions, les coupes, les occlusions et les séquences plus longues, ainsi qu'une comparaison du conditionnement de référence actuel avec des positions latentes source et cible explicitement alignées.
L'exécuter dans ComfyUI
L'adaptateur est un LoRA unique en modèle seul, sans dépendances de nœuds :
- Téléchargez
h3_character_swap_pro4500_1000.safetensorsdansComfyUI/models/loras/. - Construisez ou ouvrez un flux de travail MiniMax H3 Ref2VA et pointez-le vers la base Ref2VA INT8 élaguée, son encodeur de texte et les VAE vidéo et audio H3.
- Appliquez le LoRA à une force de 1.0 via un chargeur LoRA en modèle seul.
- Chargez le clip que vous souhaitez conserver en tant que
<Video 1>et le remplacement en tant que<Picture 1>, puis nommez la personne cible dans le prompt, par exemple :
Replace only the man in the purple shirt in <Video 1> with the character in <Picture 1>.
Keep the replacement character's identity, outfit, and art style from <Picture 1>.
Preserve the source video's camera, background, lighting, objects, and all other people.
Match the target person's position, scale, pose, and movement.
Do not show the reference sheet or its background.
La carte recommande 24 fps avec la grille d'images prise en charge par H3 et des plans continus courts plutôt que longs. Elle note que l'adaptateur ne nécessite pas de Turbo LoRA, ni d'attention Spectrum ou Sol pour fonctionner, et que sa combinaison avec un Turbo LoRA de 8 étapes relevait d'un choix d'évaluation plutôt que d'une affirmation de compatibilité.
Disponibilité
- Poids du LoRA : akatz-ai/MiniMax-H3-Character-Swap-LoRA
- Jeu de données d'entraînement et provenance : akatz-ai/H3-Character-Swap-v1
- Configuration d'entraînement et lanceur :
training/dans le référentiel des poids - Modèle de base : Comfy-Org/MiniMax-H3
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.