Fizgig H3 Still : images fixes monoframe pour MiniMax H3 dans ComfyUI
ComfyUI-Fizgig-H3-Still ajoute deux nœuds qui construisent un véritable latent MiniMax H3 d'une seule frame et le décodent sans banding, pour des images fixes nettes dès 3 MP.
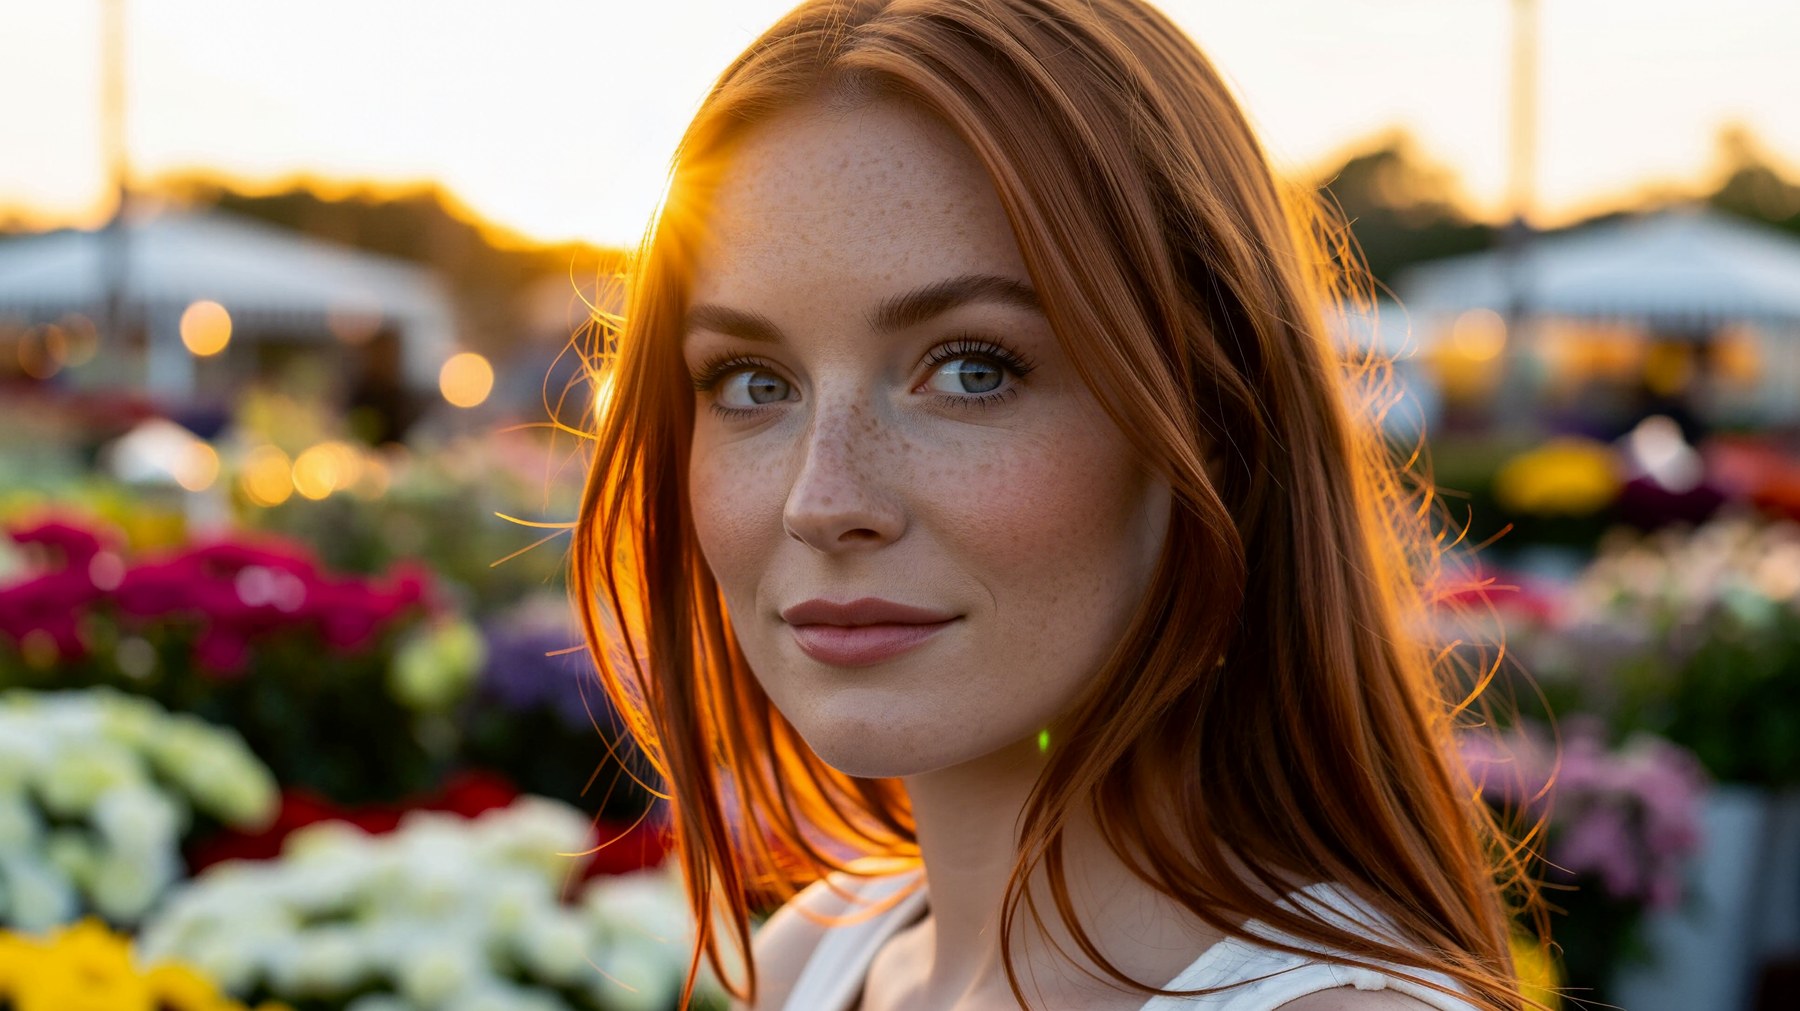
Image fixe 3872x2176, sans Turbo LoRA, 50 étapes, er_sde. Fizgig H3 Still Latent + Fizgig H3 Still Decode, d'après l'exemple 8 MP du référentiel.
Pourquoi un modèle vidéo a besoin d'un pipeline d'images fixes
L'image native de H3 est une frame unique, mais les pipelines standards ne la traitent jamais comme telle. Un latent H3 normal fait au moins cinq frames, donc une « image fixe » est en réalité la première frame d'un court clip. Décoder cette frame isolée avec le nœud VAE Decode standard donne une sortie striée et marquée de bandes : c'est pourquoi la solution habituelle consistait à rendre cinq frames pour n'en garder qu'une.
Le pack divise le problème en deux nœuds, issus de la façon dont Fizgig rend ses propres aperçus d'images fixes H3 :
- Fizgig H3 Still Latent produit un véritable latent d'une seule frame.
- Fizgig H3 Still Decode décode cette frame unique sans bandes.
Les deux s'appuient sur la prise en charge intégrée de MiniMax H3 dans ComfyUI et ne nécessitent aucune dépendance Python supplémentaire. Les tests de l'auteur les comparent aussi au VAE monoframe dédié présenté dans MiniMax H3 Single-Frame VAE 500K : ce checkpoint est plus lent et plus doux, avec moins de détail de peau, ces nœuds sont donc la voie recommandée.
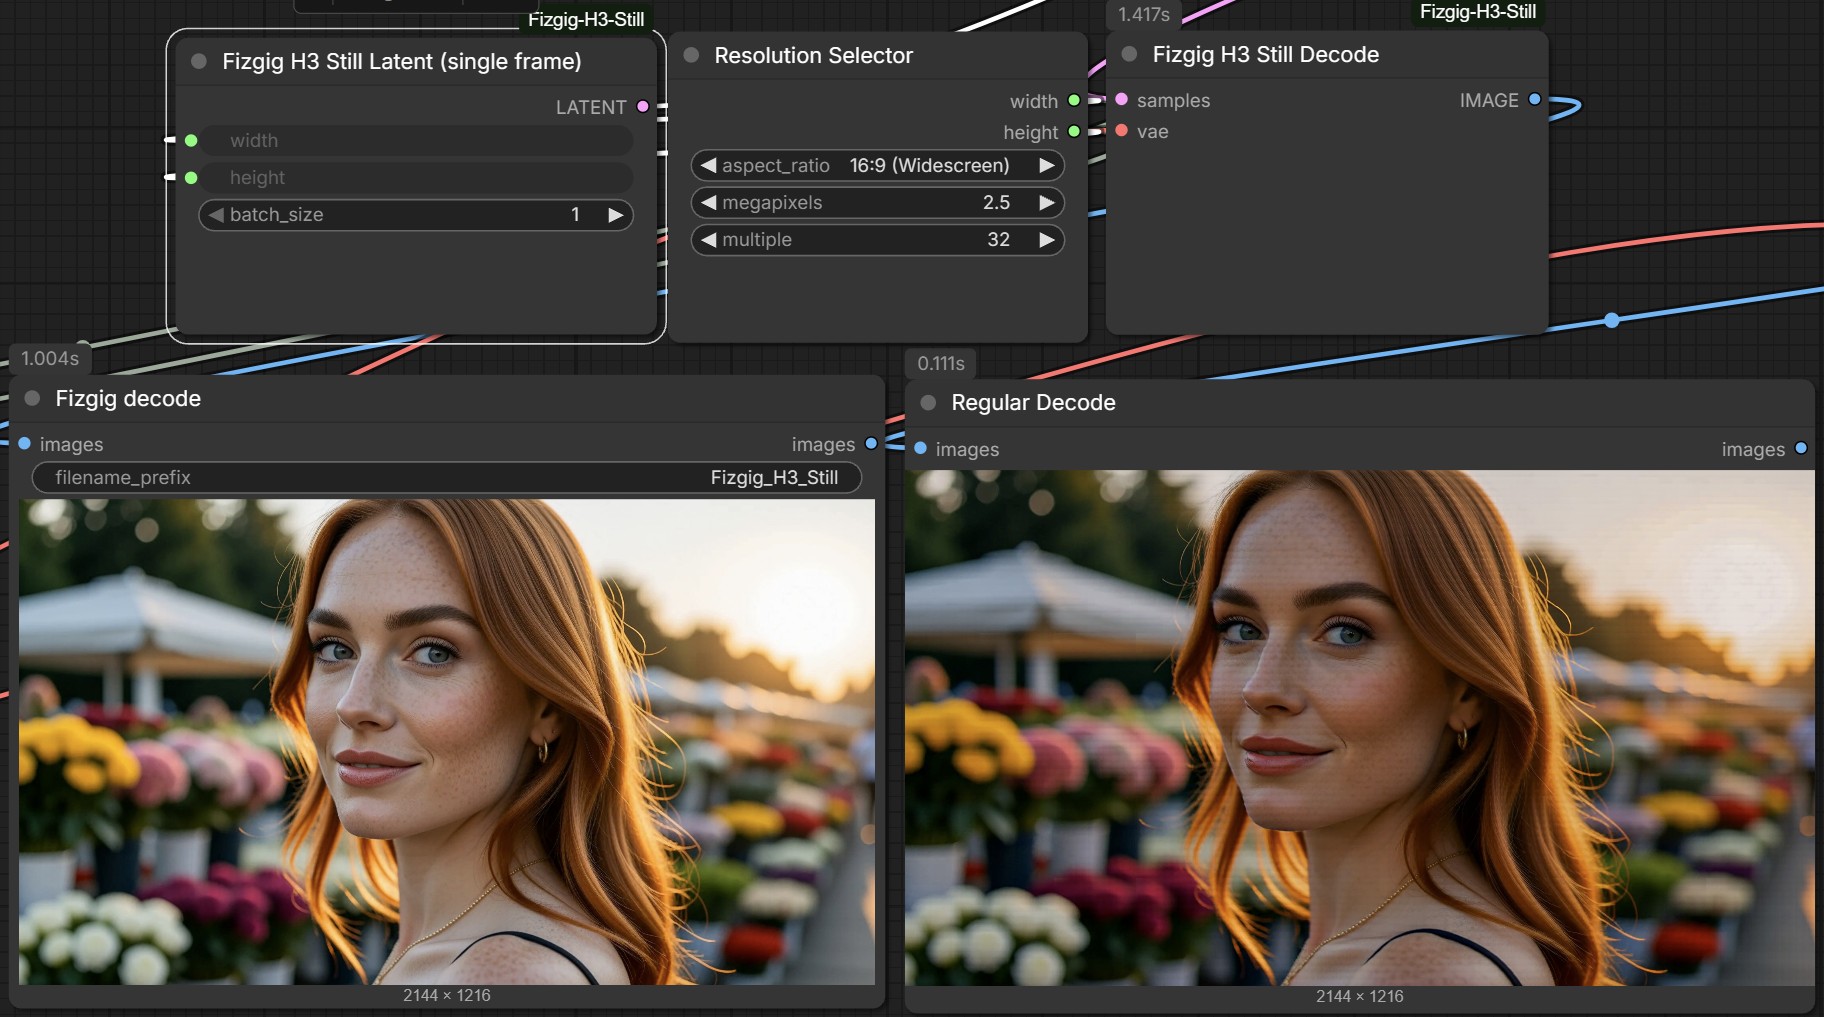
Même seed, 2144x1216 : Fizgig H3 Still Decode (à gauche) contre le VAE Decode standard (à droite).
L'intégrer à un graphique H3
LATENT non connectée. Branchez Fizgig H3 Still Latent sur l'entrée latente de l'échantillonneur à la place, en utilisant la même largeur et la même hauteur que le nœud de conditionnement.
Remplacer le décodeur
Remplacez VAE Decode par Fizgig H3 Still Decode. Il prend la sortie de l'échantillonneur et le VAE vidéo, les mêmes entrées que le nœud qu'il remplace.
Ajouter éventuellement un Turbo LoRA
Ajoutez le LoRA de larryvrh/MiniMax-H3-Turbo-Lora via un chargeur LoRA model-only. Les paramètres fournis utilisent le fichier v4 step-600 EMA à une force de 0,38 avec 20 étapes et l'échantillonneur er_sde ; l'exemple 8 MP est rendu sans Turbo à 50 étapes.
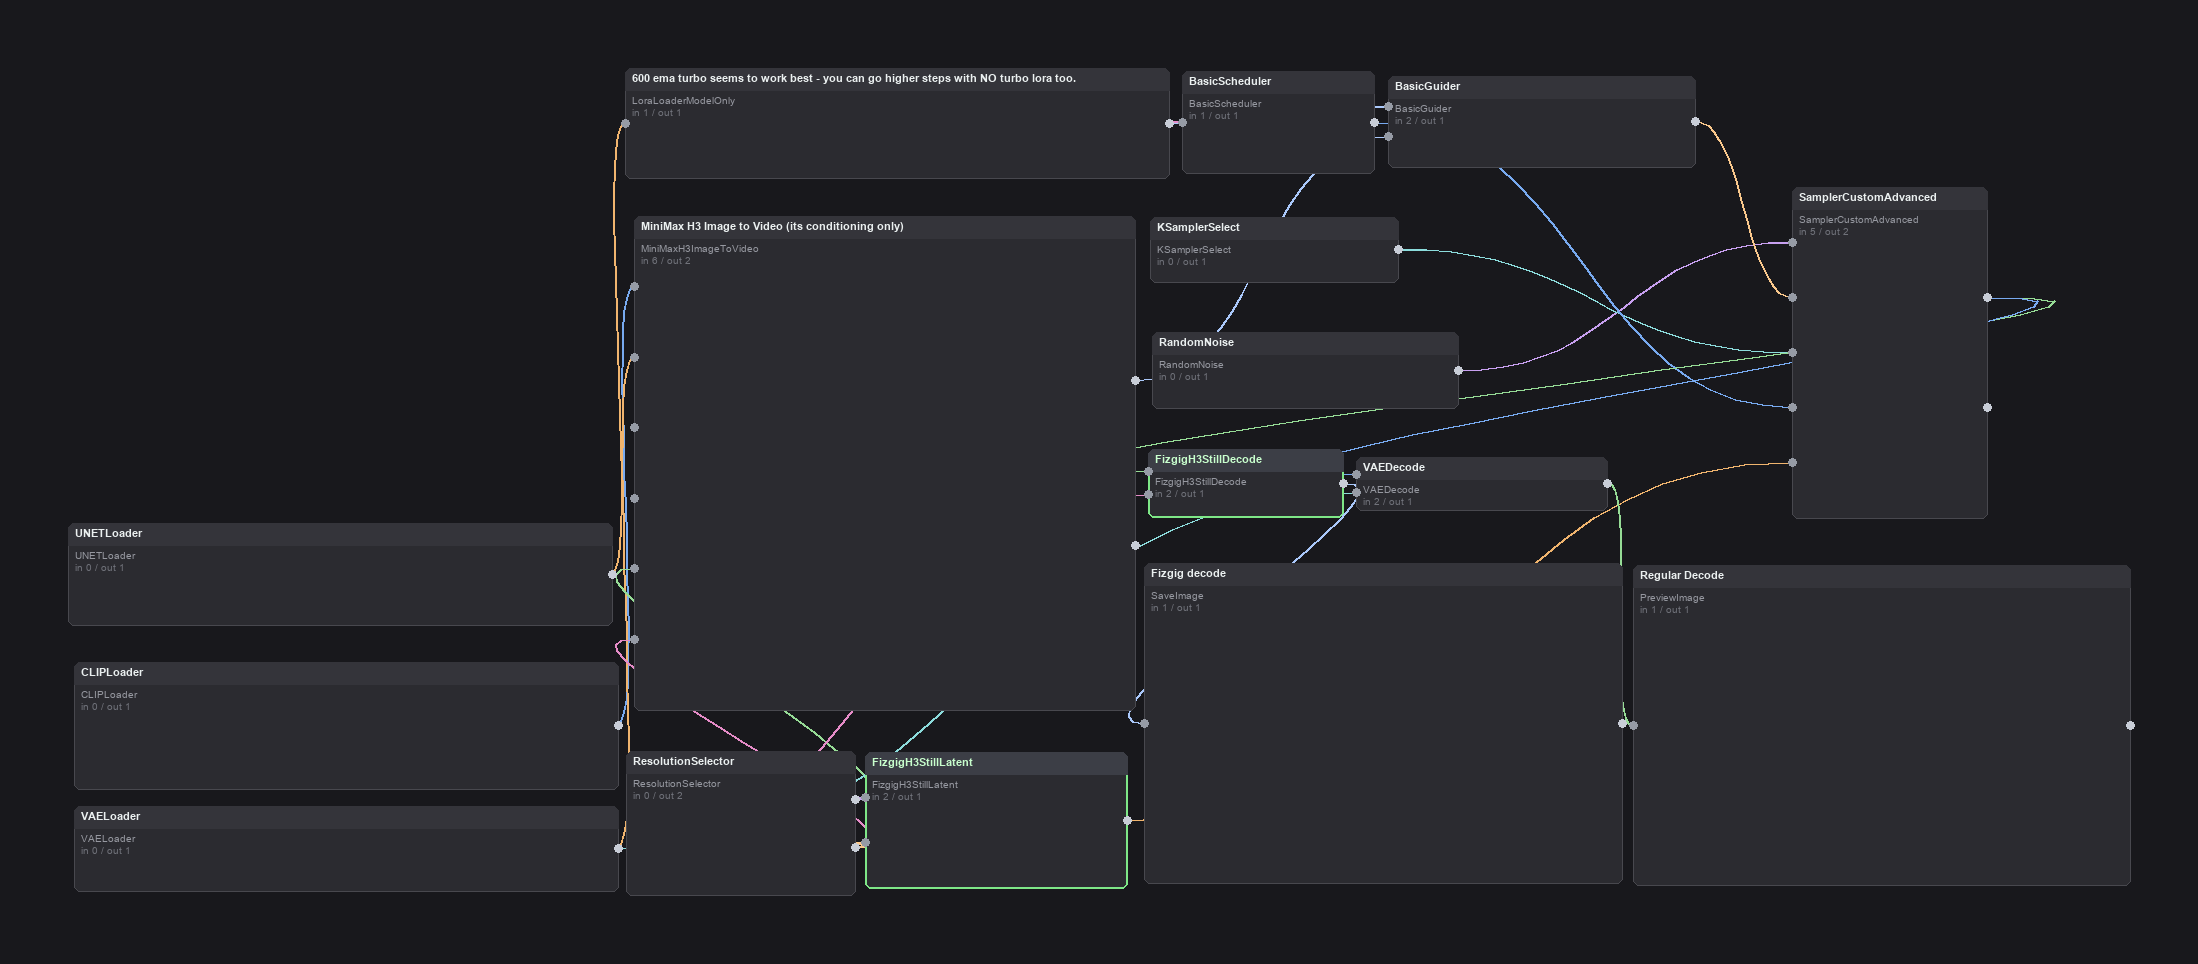
L'exemple h3_still_text_to_image, rendu à partir du JSON de flux de travail fourni dans le référentiel. Il décode deux fois, une fois avec Fizgig H3 Still Decode et une fois avec le VAE Decode standard, afin de comparer les deux sorties côte à côte.
Toute largeur et toute hauteur multiples de 32 fonctionnent, mais les résultats tiennent le mieux à partir de 3 MP : les petites images ressortent nettement plus faibles. Le décodage est en mosaïque, il traite donc quelques tuiles à la fois, ou une seule à la fois quand la VRAM est limitée, ce qui signifie que les grandes images fixes n'ont pas besoin d'une grosse carte. À savoir avant de réutiliser le graphique pour de la vidéo : le nœud de latent est réservé aux images fixes, tandis que le nœud de décodage transmet tout ce qui dépasse une frame directement au décodage standard, donc le laisser dans un flux de travail de clip ne fait aucun mal.
Le pack fournit également un exemple d'édition qui fait passer une photo par MiniMax H3 Référence vers Vidéo et y fait référence sous la forme <Picture 1> dans le prompt, avec d'abord un upscale à 2,5 MP, car les éditions H3 semblent fonctionner au mieux à cette taille.
Pack frère : H3 Tweaks
Le pack de nœuds antérieur du même auteur, ComfyUI-Fizgig-H3-Tweaks, couvre le versant vidéo de la même exploration avec des réglages sans entraînement : contrôle de la texture de peau, relance d'une scène en conservant le sub-seed, et un curseur de force de prompt pour les rendus Turbo. Sa mise à jour du 09-25 a ajouté les variantes de nœuds H3 Latent et VAE Decode aux côtés du travail sur les images fixes.
Réaction de la communauté
Les nœuds ont circulé sur r/comfyui le 2026-09-26, et un testeur indépendant a fait tourner le graphique 8 MP à 30 étapes pendant le week-end. Ses notes : le pipeline d'images fixes rend enfin la petite typographie utilisable, mais pas pour les lettrages très fins, et ses rendus sont ressortis plus lisses que la sortie ordinaire, sans coutures de pixels ni « lignes de balayage ». Il a aussi mesuré un décalage de couleur : le chemin d'image fixe renvoyait un rendu noir et blanc pur de film noir au lieu de la légère chaleur sépia de la sortie normale.
Installer
cd ComfyUI/custom_nodes
git clone https://github.com/shootthesound/ComfyUI-Fizgig-H3-Still
Redémarrez ComfyUI, et les deux nœuds apparaissent dans la catégorie Fizgig. Les exemples utilisent les fichiers H3 de Comfy-Org : minimax_h3_fl2va_pruned_int8_convrot.safetensors dans models/diffusion_models, qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors dans models/text_encoders, et minimax_h3_video_vae_int8_convrot.safetensors dans models/vae. L'exemple d'édition utilise en plus AILab_ImageResize de ComfyUI-RMBG.
Référentiel : shootthesound/ComfyUI-Fizgig-H3-Still
Pack frère : shootthesound/ComfyUI-Fizgig-H3-Tweaks
Voir aussi : Fizgig v6 RefMods, MiniMax H3 Video VAE Optimization
Modèle de base : Comfy-Org/MiniMax-H3
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.