Texture-Fix-VAE : un décodeur VAE plus propre pour Qwen-Image 2.1
Texture-Fix-VAE de madebyollin réentraîne le décodeur VAE de Qwen-Image 2.1 pour supprimer le damier. Placez le fichier dans ComfyUI/models/vae et chargez-le normalement.
ComfyUI/models/vae/ et sélectionnez-le dans le nœud Charger VAE.
Qwen-Image 2.1 débruite dans un espace latent compressé, et le décodeur VAE est la dernière étape qui reconvertit ce latent en pixels. Tout ce que le décodeur ne parvient pas à reconstruire proprement reste gravé dans l'image terminée, quelle que soit la qualité de l'échantillonnage. Les utilisateurs décrivent ce symptôme depuis la sortie du modèle : une légère grille de deux pixels et un aspect un peu tramé dans les zones chargées comme le feuillage, les cheveux et le tissu.
Texture-Fix-VAE s'attaque spécifiquement à cette étape. L'encodeur n'est pas touché, donc le format latent, le plan d'échantillonnage et chaque LoRA ou checkpoint quantifié continuent de fonctionner sans changement.
Avant et après
L'auteur a généré les latents de la comparaison ci-dessous avec Qwen-Image 2.1 à partir d'un prompt de style photographique riche en textures fines :
Landscape photograph of a subalpine wildflower meadow in the Pacific Northwest in midsummer: a clear mountain stream winding over mossy boulders through purple lupine and red paintbrush, dense old-growth Douglas fir and western red cedar forest behind, a snow-capped volcano in the distance, golden late-afternoon light, highly detailed
Les deux colonnes décodent les mêmes latents, toute différence provient donc uniquement du décodeur.
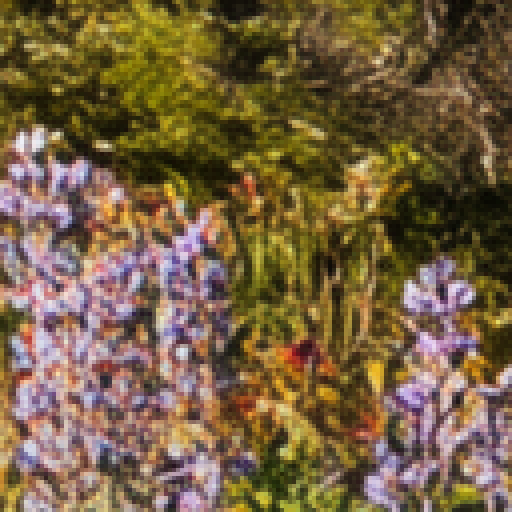 | 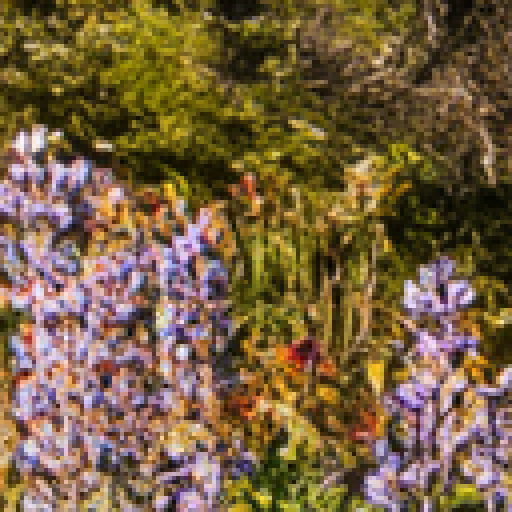 |
|---|---|
| VAE d'origine, recadrage zoomé | Texture-Fix-VAE, même recadrage |
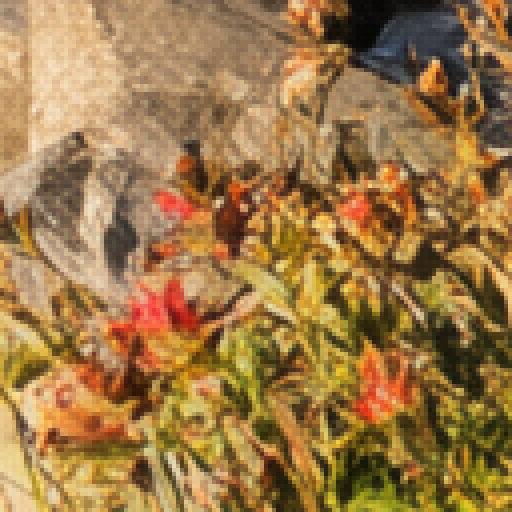 | 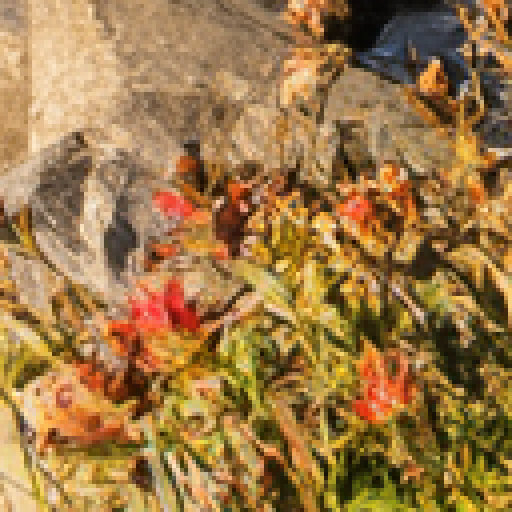 |
|---|---|
| VAE d'origine, deuxième recadrage zoomé | Texture-Fix-VAE, même recadrage |
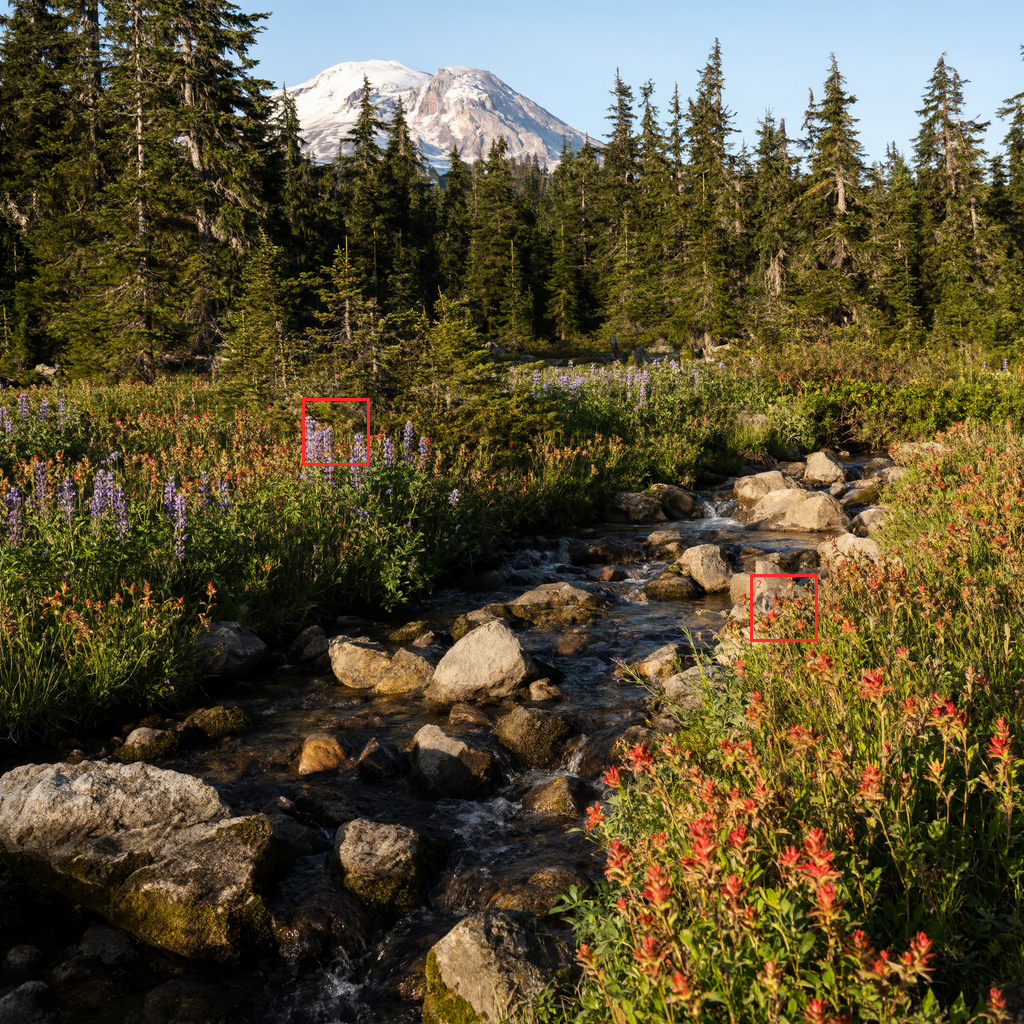 | 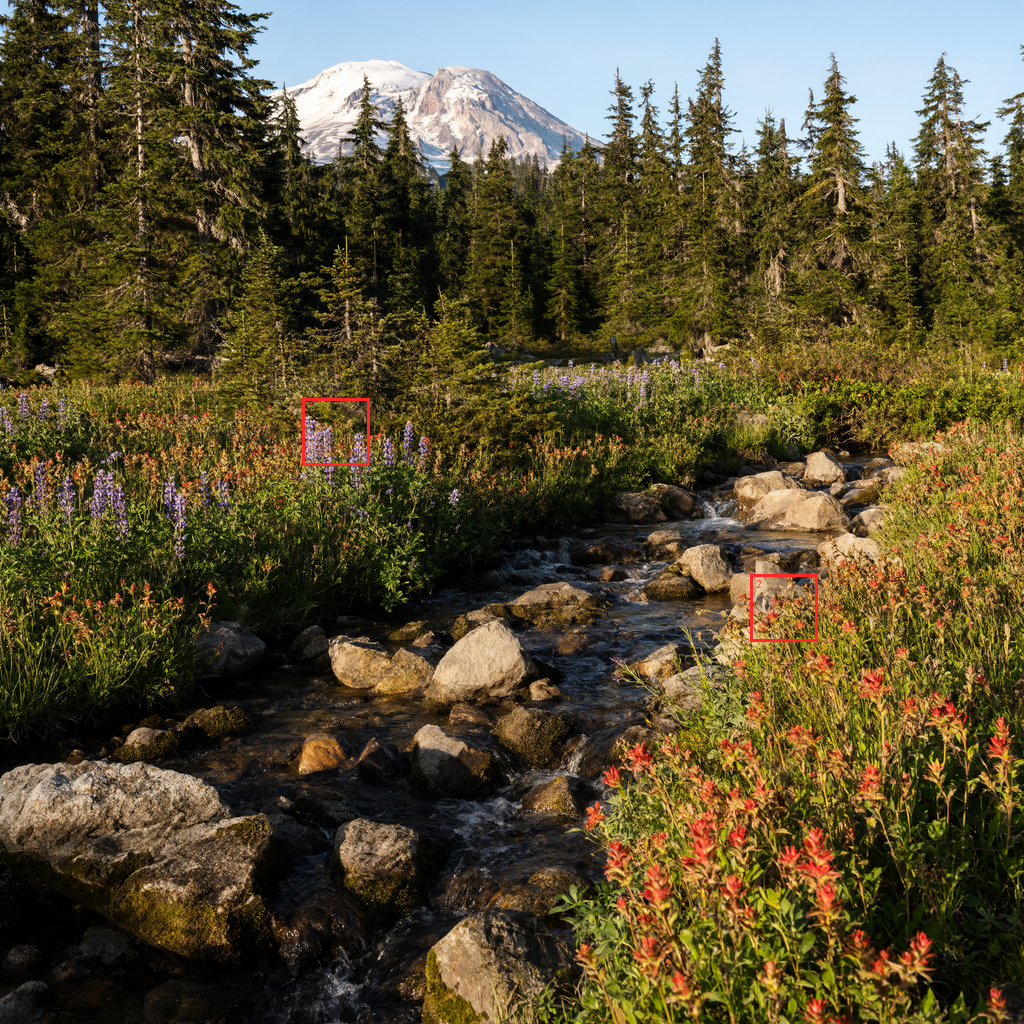 |
|---|---|
| VAE d'origine, décodage complet 1024 x 1024 | Texture-Fix-VAE, décodage complet |
Ce qui a changé en interne
Seul le décodeur a été finetuné, pendant environ 5 000 étapes avec un taux d'apprentissage de 3e-5. Les deux étages du décodeur à la plus haute résolution et la tête de sortie ont été laissés dégelés, ce qui représente environ 7,5 M de paramètres entraînables, et l'entraînement a utilisé la recette développée par l'auteur pour TAESD.
Cette recette mélange trois familles de pertes, chacune poussant la reconstruction dans une direction différente :
| Perte | Ce qu'elle favorise |
|---|---|
| MSE / MAE (axée PSNR) | Une moyenne prudente, qui floute les détails qu'elle ne sait pas placer |
| LPIPS | La plausibilité perceptuelle, qui sur les textures fines se traduit par du flou et un effet de damier |
| Adversariale (GAN) | Des détails nets et plausibles qui semblent réels au lieu d'être manifestement synthétiques |
C'est le terme adversarial qui fait la différence ici. Selon l'auteur, le VAE d'origine de Qwen-Image 2.1 a été entraîné sans terme de perte adversariale fonctionnel, ce qui expliquerait la grille : le terme perceptuel était libre de pousser vers l'effet de damier, car rien ne pénalisait une structure manifestement artificielle.
Métriques
| Métrique | VAE Qwen-Image 2.1 | Texture-Fix-VAE |
|---|---|---|
| rFID, plus bas c'est mieux (COCO val2017, 5 000 images en 256²) | 3,37 | 2,08 |
| PSNR, plus haut c'est mieux (COCO val2017 en 256²) | 33,30 | 32,86 |
| LPIPS, plus bas c'est mieux (COCO val2017 en 256²) | 0,0357 | 0,0373 |
| PSNR, plus haut c'est mieux (DIV2K valid, recadrages natifs en 1024²) | 32,86 | 32,46 |
| LPIPS, plus bas c'est mieux (DIV2K valid, recadrages natifs en 1024²) | 0,0460 | 0,0480 |
C'est le compromis habituel d'un décodeur de type GAN : la qualité perceptuelle (rFID) s'améliore d'environ un tiers, tandis que la précision de reconstruction (PSNR et LPIPS) recule très légèrement. L'auteur précise que l'amélioration est surtout visible sur les images détaillées de style photographique, plutôt que sur les illustrations uniformes.
Utilisation dans ComfyUI
Téléchargez texture_fix_vae_for_qwen_image_2.1_bf16.safetensors dans ComfyUI/models/vae/, puis sélectionnez-le dans le nœud Charger VAE à la place de qwen_image_2.1_vae_bf16.safetensors. Aucune modification de nœud, de flux de travail ou d'échantillonneur n'est nécessaire, et le fichier peut être remis en place à tout moment.
En dehors de ComfyUI, les mêmes poids se chargent comme un VAE diffusers classique :
import torch
from diffusers import QwenImage21Pipeline, AutoencoderKLQwenImage21

vae = AutoencoderKLQwenImage21.from_pretrained(
    "madebyollin/texture-fix-vae-for-qwen-image-2.1", torch_dtype=torch.bfloat16
)
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", vae=vae, torch_dtype=torch.bfloat16
).to("cuda")
Disponibilité
Poids : madebyollin/texture-fix-vae-for-qwen-image-2.1
Fichier ComfyUI : texture_fix_vae_for_qwen_image_2.1_bf16.safetensors
Modèle de base : Qwen/Qwen-Image-2.1
Travaux antérieurs de l'auteur : TAESD, sdxl-vae-fp16-fix
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.