Qwen-Image 2.1 Fun Acc LoRA : distillation officielle en 4 étapes
Alibaba PAI distille Qwen-Image 2.1 en 4 étapes avec un LoRA PDD de 346 Mo qui couvre la génération texte-image et l'édition par instruction, avec son propre calendrier sigma.
L'adaptateur suit la même recette qu'Alibaba PAI avait utilisée pour les MiniMax H3 PDD Acc LoRAs en août : prendre un modèle de base puissant, le distiller avec la distillation par décodage parallèle (PDD, arXiv 2607.26004), puis publier le LoRA extrait accompagné du code d'inférence nécessaire pour reproduire les résultats de référence. Qwen-Image 2.1 lui-même est sorti le 20 septembre 2026 et est déjà pris en charge dans ComfyUI ; il s'agit donc d'une variante d'accélération d'un modèle qui n'a que quelques jours.
Ce que contient le référentiel
| Adaptateur | models/Qwen-Image-2.1-Fun-Acc-4Step.safetensors, 346 Mo, rang 64 et network_alpha 64 en BF16 |
| Modèle de base | Qwen-Image 2.1 (Qwen/Qwen-Image-2.1), poids inchangés |
| Étapes | 4 NFE (pdd_num_steps: 4, pdd_block_size: 1) |
| Tâches | Génération texte-image et édition d'image par instruction |
| Cibles entraînées | img_in, modulation.1, norm_out.linear, les plongements de pas de temps, attn.to_q/to_k/to_v/to_out.0 et img_mlp des 32 blocs du transformer, plus txt_in.in_layer / txt_in.out_layer |
| Extras réservés à l'inférence | norm_q / norm_k de l'attention et txt_in.text_norm sont stockés comme paramètres complets plutôt que comme paires LoRA |
| Taille d'échantillon par défaut | 2048 x 2048 (pdd_sample_size) |
| Précision d'échantillonnage | native_time_fp32_state |
Le calendrier sigma fait partie de la publication et non d'un détail d'implémentation : pdd_config.json fixe le calendrier en quatre étapes à 1.0, 0.9169867, 0.7861579, 0.549491, 0.0, et le format exporté est qwenimage21_extracted_prefused_v1. C'est pour ces valeurs qu'il ne s'agit pas d'un simple LoRA à déposer tel quel. Un échantillonneur 4 étapes générique avec les sigmas par défaut ne reproduit pas le comportement distillé.
Comparaison
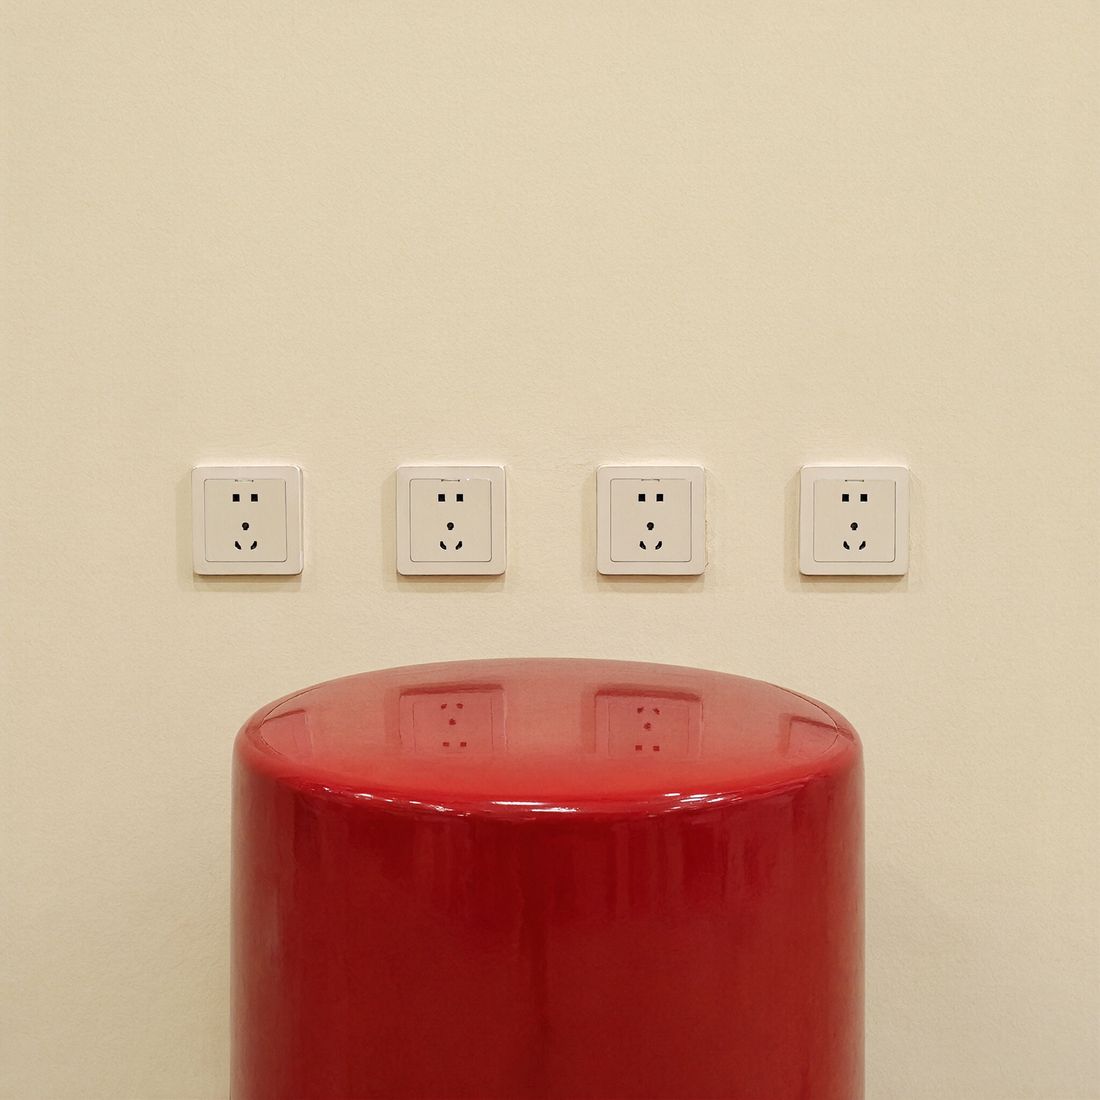
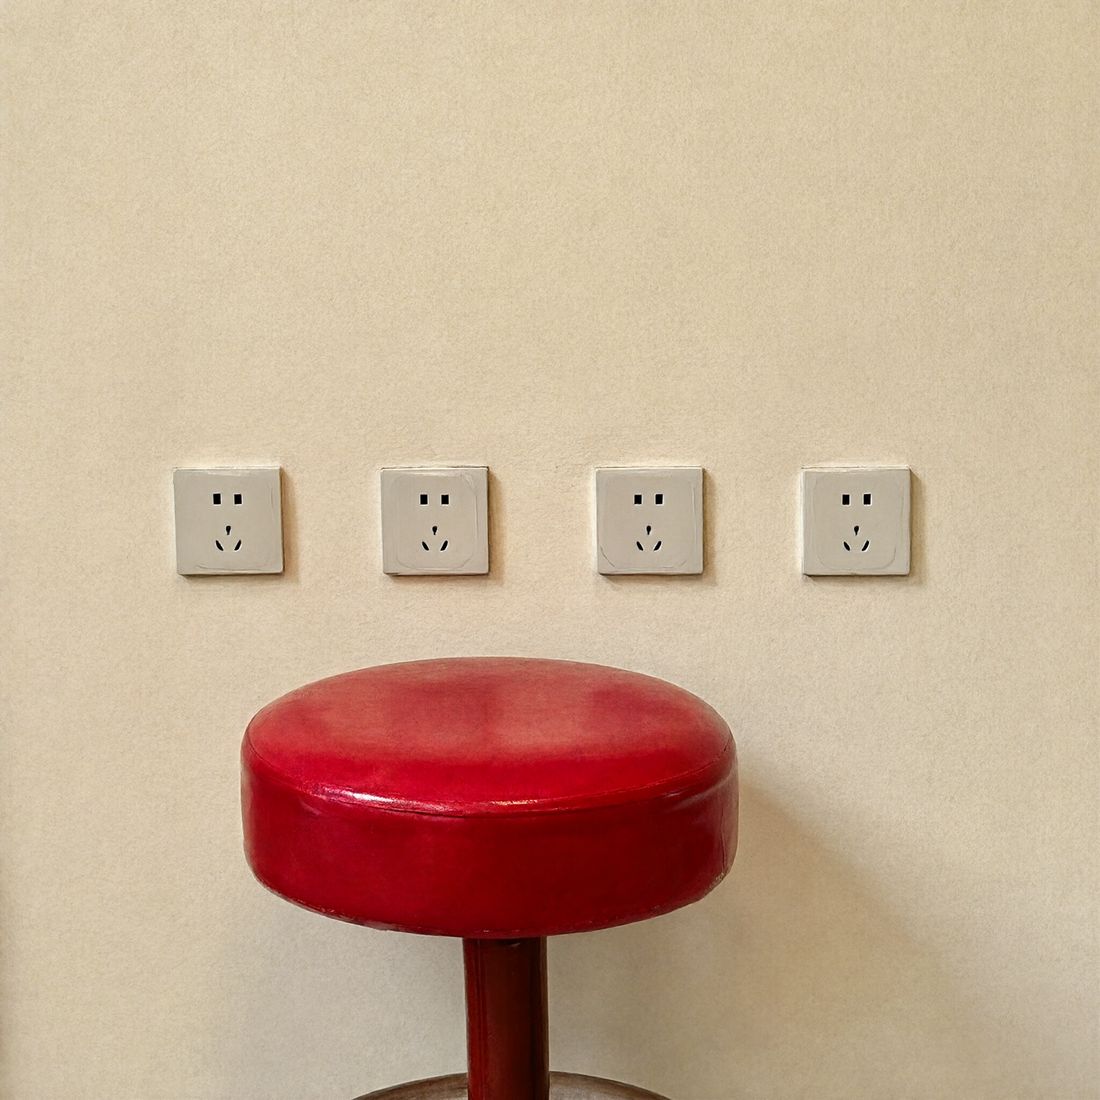
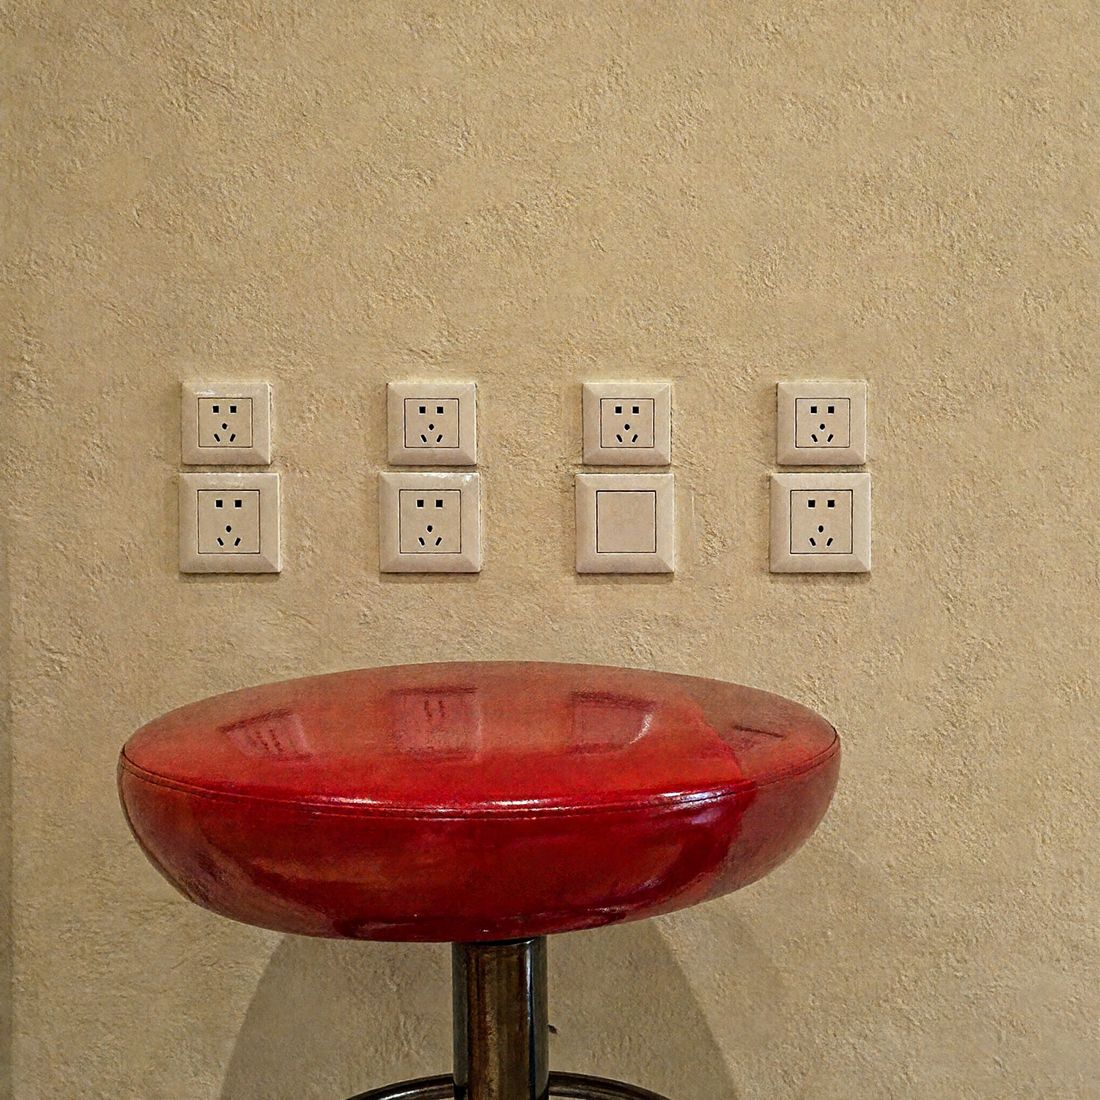
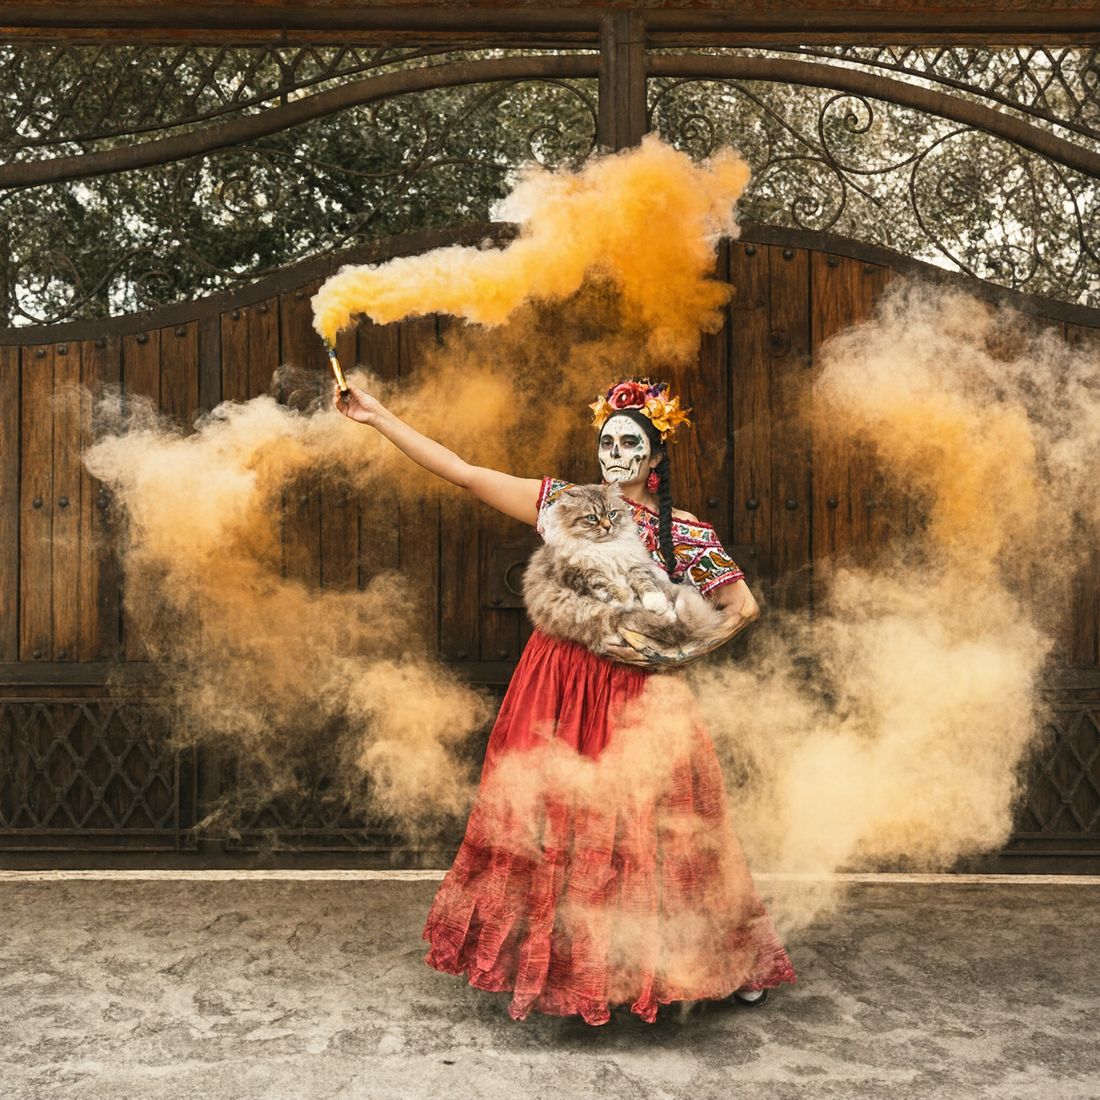
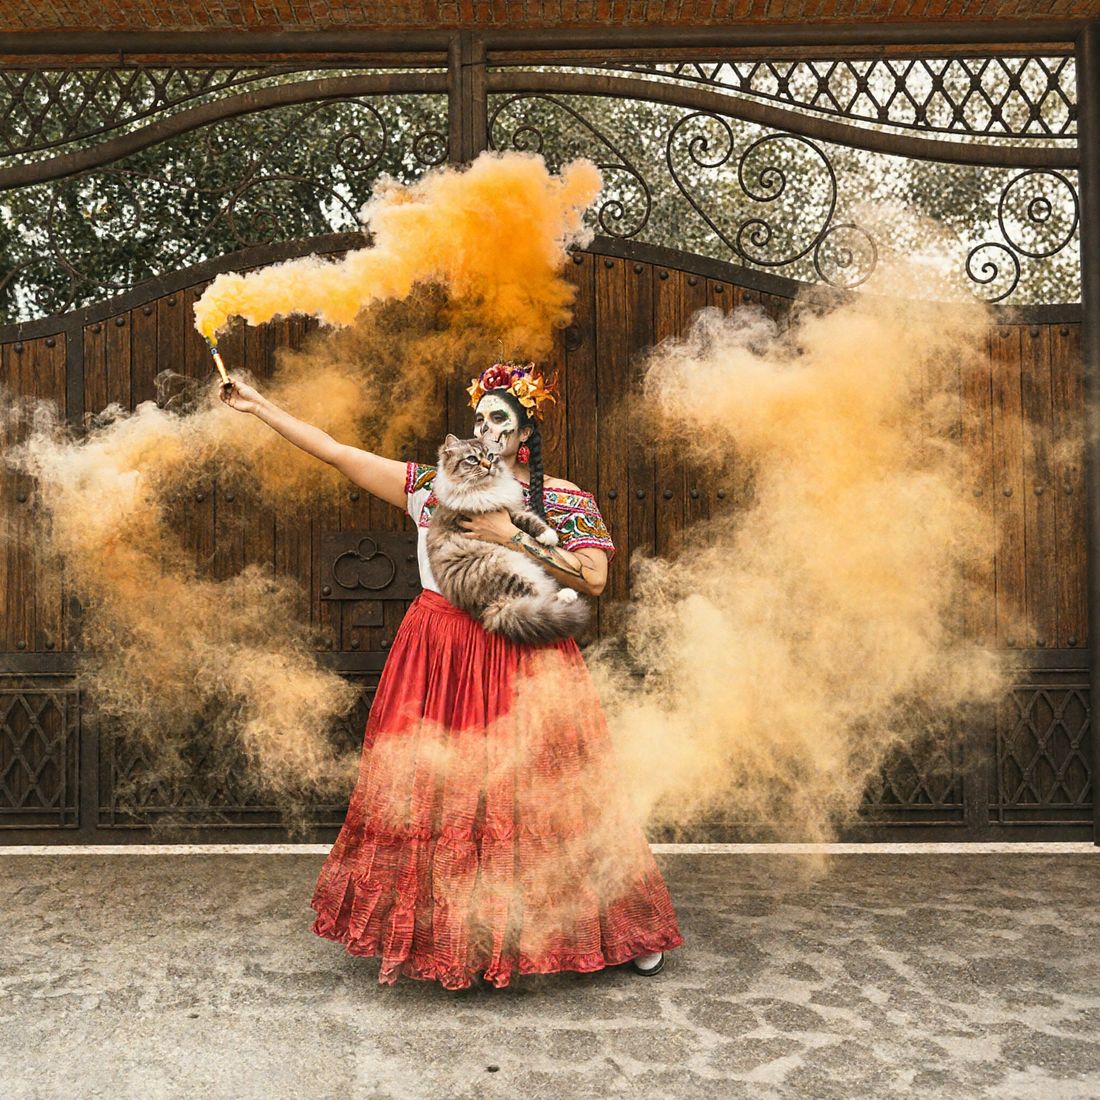
La carte du modèle publie des comparaisons à trois voies pour chaque exemple : le professeur (teacher) à 40 NFE, le LoRA PDD à 4 NFE et Viggle v0.1 full à 4 NFE. Le PDD n'est pas seulement comparé à son propre professeur, mais aussi à l'autre approche en 4 étapes pour ce modèle, à savoir le LoRA turbo Viggle publié plus tôt en septembre.
 |  |  |
|---|---|---|
| Professeur : 40 NFE | LoRA PDD : 4 NFE | Viggle v0.1 full : 4 NFE |
Échantillon texte-image, invite tirée de l'article PDD. Les trois panneaux utilisent la graine 42.
L'édition est couverte par le même adaptateur, y compris les éditions multi-références. L'exemple ci-dessous redessine le drapeau dans l'image de référence, et la troisième colonne correspond à la même approche en 4 étapes servie par le LoRA turbo Viggle.
 | 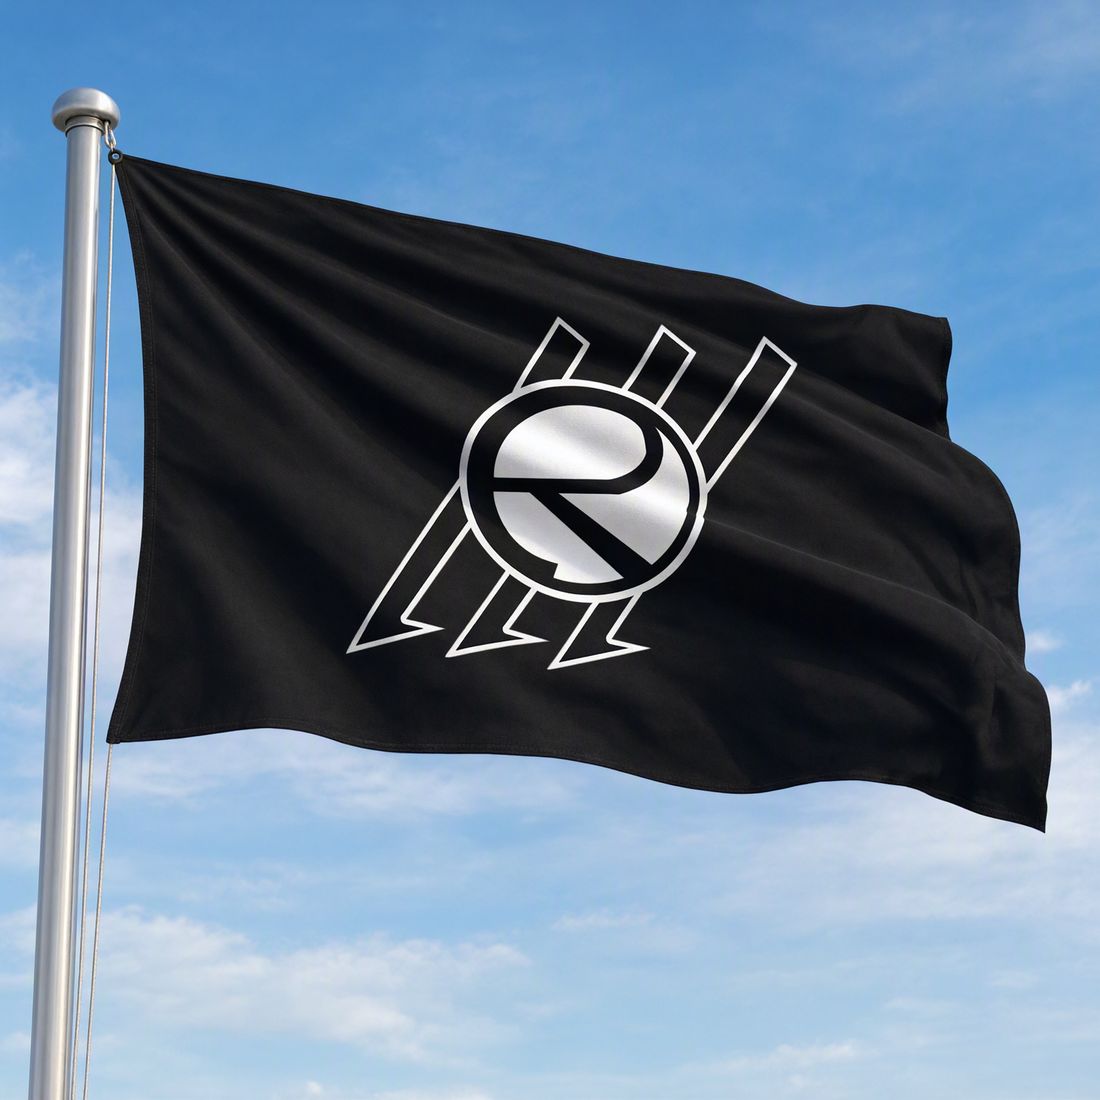 | 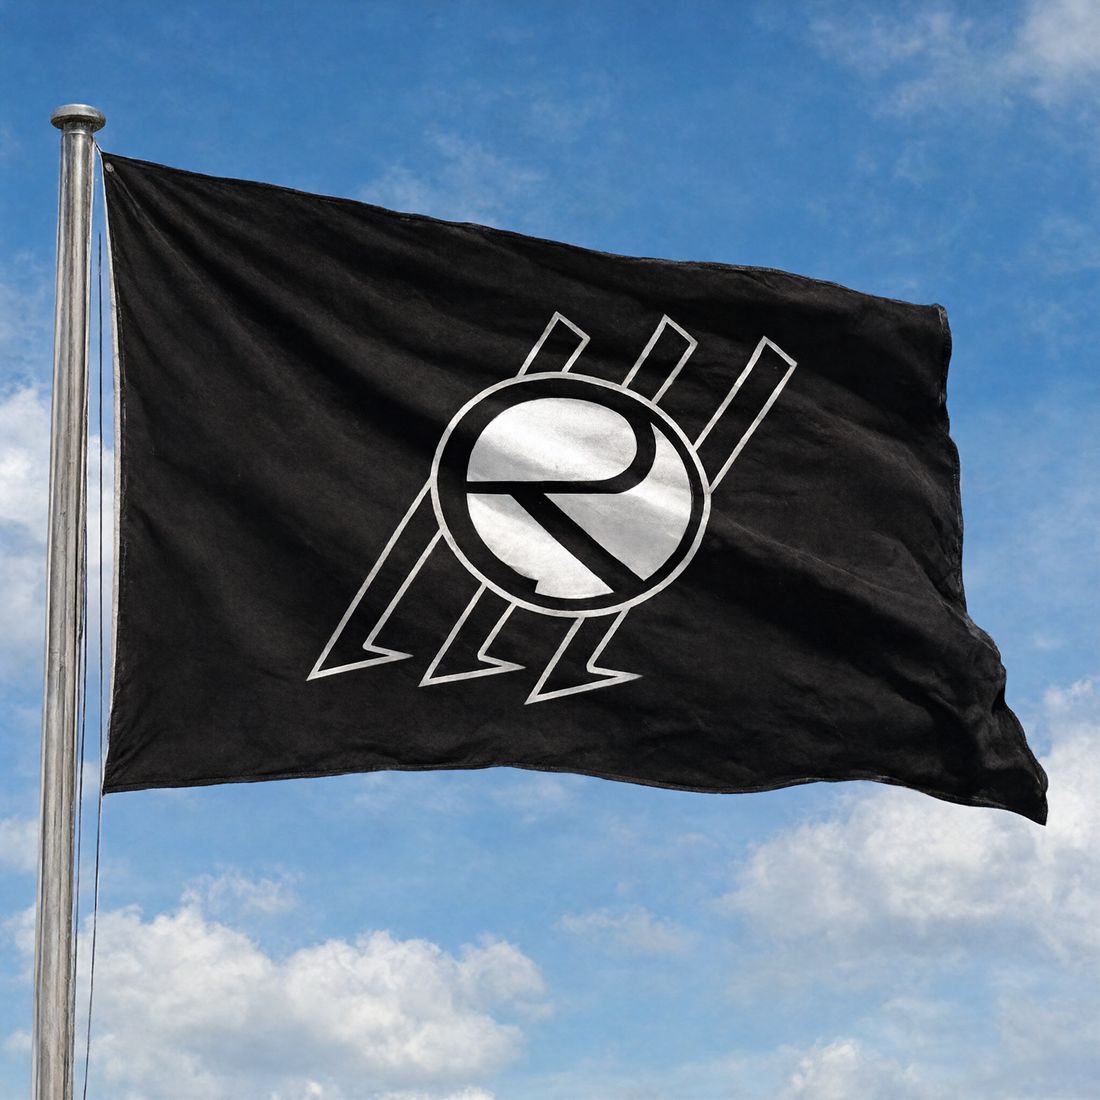 | 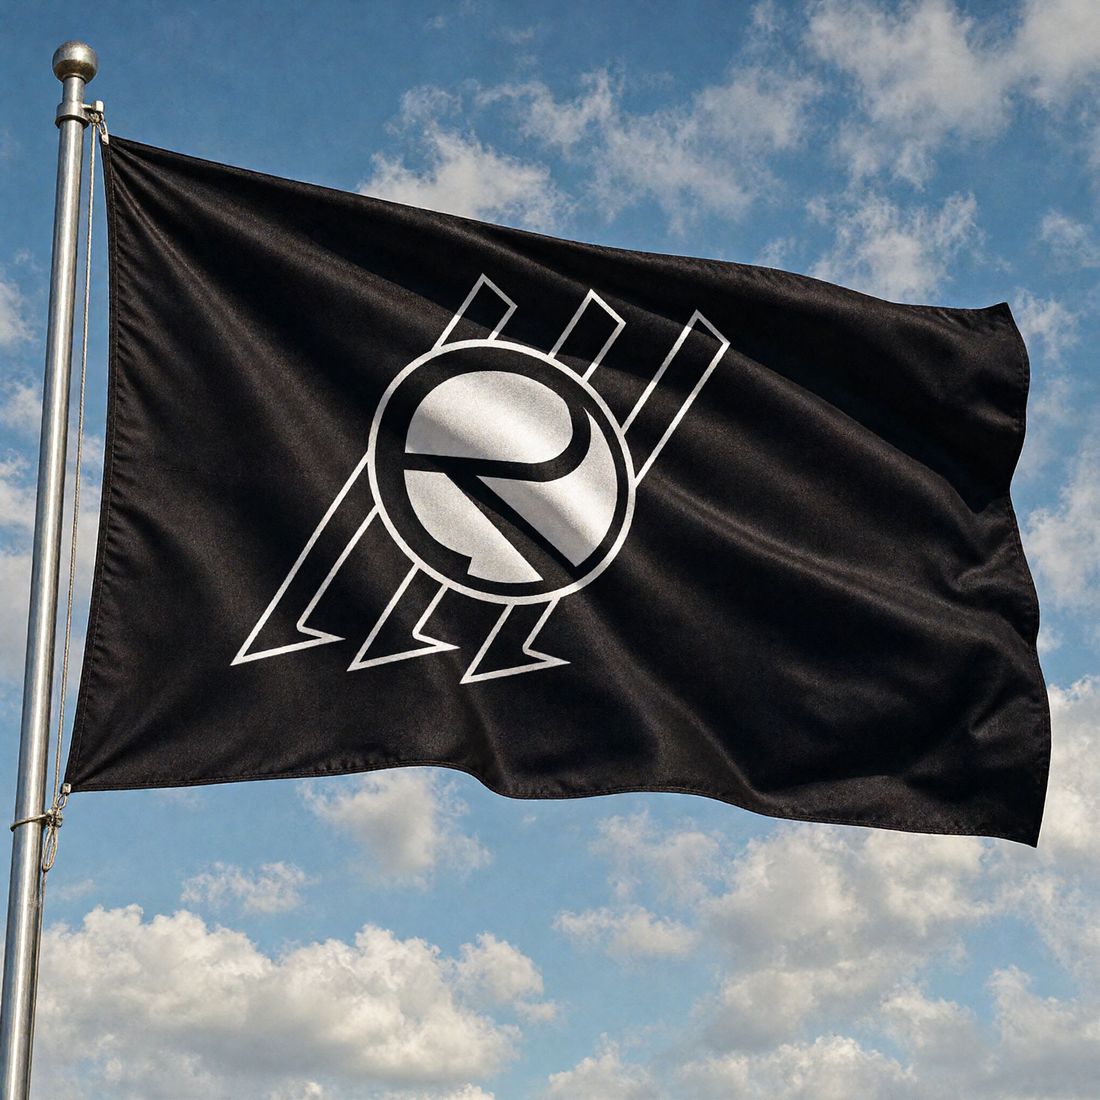 |
|---|---|---|---|
| Image de référence | Professeur : 40 NFE | LoRA PDD : 4 NFE | Viggle v0.1 full : 4 NFE |
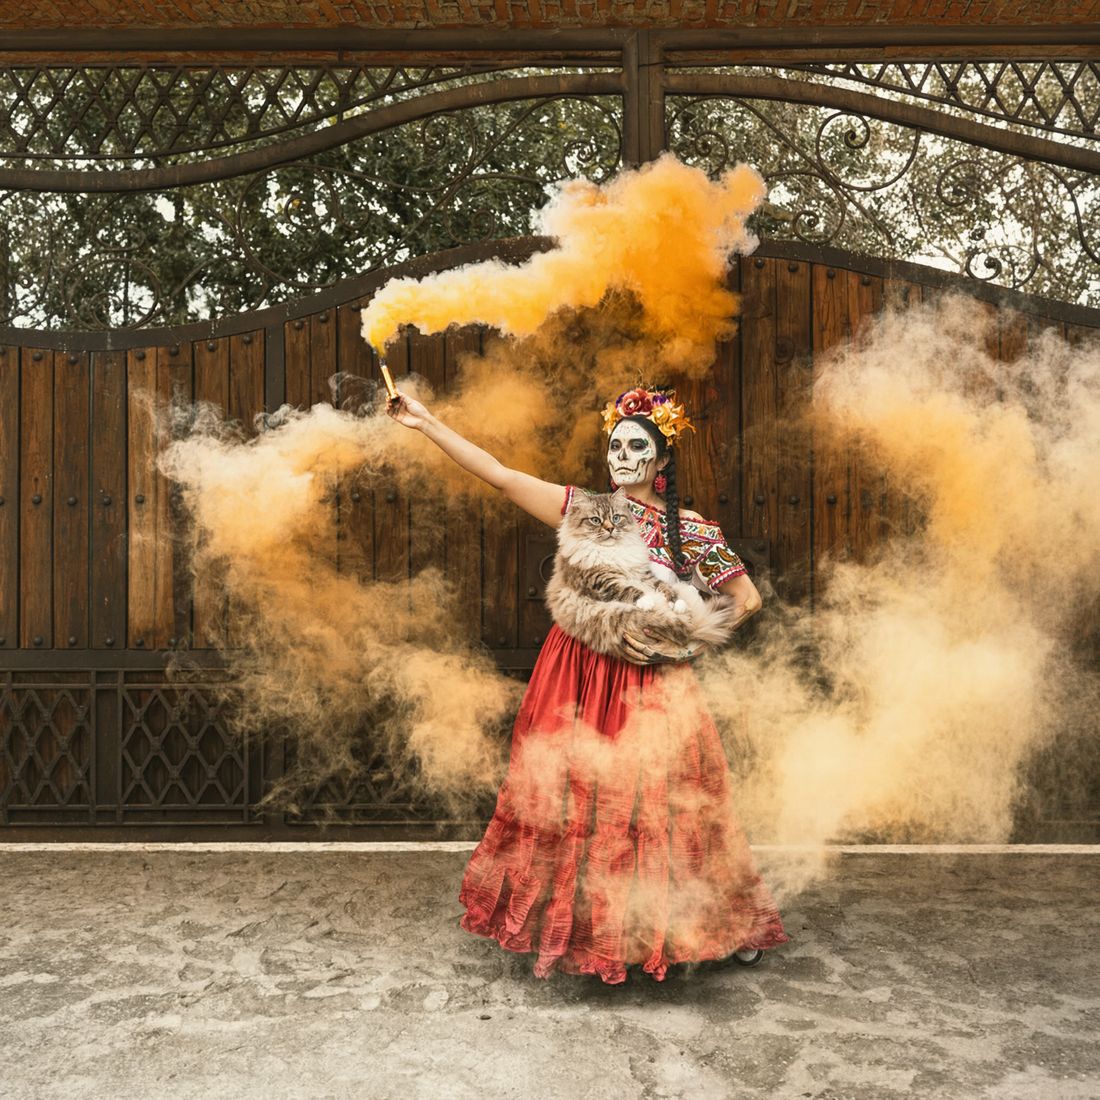 |  |  |
|---|---|---|
| Professeur : 40 NFE | LoRA PDD : 4 NFE | Viggle v0.1 full : 4 NFE |
Échantillon d'édition à deux références (personne et chat), graine 43.
Limites documentées
La carte du modèle signale deux lacunes connues par rapport au professeur plutôt que de laisser les utilisateurs les découvrir :
- Les textes denses et de petite taille peuvent se dégrader nettement, avec des traits de caractères déformés et une lisibilité réduite.
- Certaines sorties d'édition paraissent légèrement plus floues et plus sombres que celles du professeur, avec une netteté des détails réduite.
Disponibilité
Il n'existe aucune prise en charge officielle dans ComfyUI, et la publication est écrite pour le pipeline officiel :
- Diffusers uniquement : conservez les fichiers
qwenimage21_pdd.pyetlora_utils_pdd.pyfournis à côté des scripts et exécutezpython predict_t2i.py(génération) oupython predict_t2i_edit.py(édition). - VideoX-Fun : utilisez une copie du dépôt qui expose
QwenImage21Pipelinedepuisvideox_fun.pipelineet exécutezpredict_t2i_videox_fun.pyoupredict_t2i_edit_videox_fun.py.
Pour ComfyUI, il n'existe pour l'instant qu'une voie expérimentale : Kijai a publié une branche Qwen-Image 2.1 PDD du référentiel ComfyUI, et le LoRA doit être converti avant qu'un chargeur ComfyUI puisse l'utiliser. Comme le calendrier et les paramètres norm_q / norm_k / text_norm hors LoRA font partie de la distillation, considérez les conversions ComfyUI de cet adaptateur comme un travail de la communauté plutôt que comme une voie prise en charge.
Les adaptateurs d'accélération antérieurs de la même équipe pour MiniMax H3 constituent le point de référence le plus proche pour comprendre le fonctionnement de cette famille de publications : là aussi, le LoRA distillé était livré avec sa propre recette d'inférence plutôt que comme un LoRA standard pour le modèle de base.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.