Viggle Turbo v0.2 : Qwen-Image 2.1 en 5 étapes sur ComfyUI
La distillation DMD v0.2 de Qwen-Image 2.1 par Viggle réduit la génération à 5 étapes sans CFG, livrée sous forme de LoRA rank-256 avec des conversions ComfyUI communautaires.
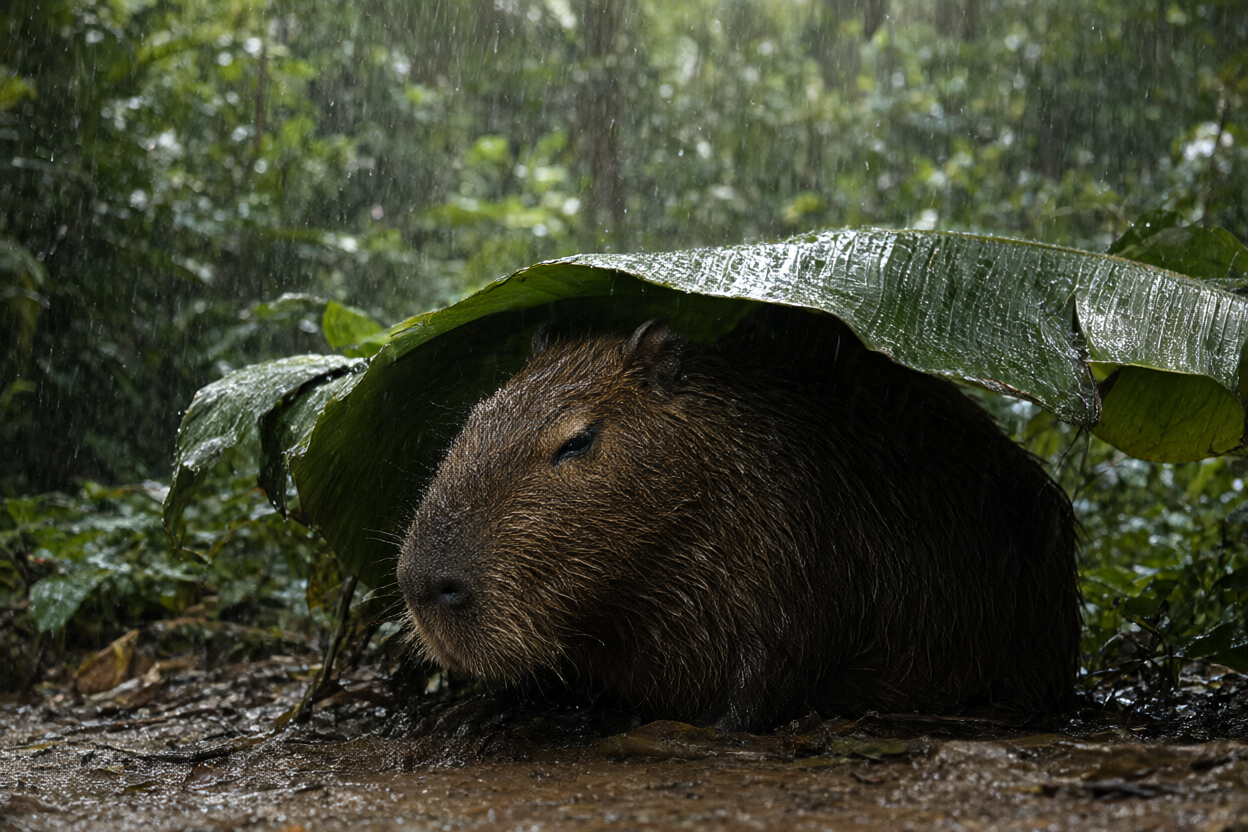
Un échantillon text-to-image en 5 étapes issu du Space de démonstration de Viggle.
Ce que change la v0.2
La première version publique, la v0.1, était un aperçu qui réduisait la diversité des sorties et déviait du modèle de base sur la composition. La v0.2 est un modèle étudiant plus grand, et Viggle l'a mesurée par rapport au modèle de base en 40 étapes accompagné de son amélioration de prompt officielle, sur un ensemble réservé de 96 requêtes utilisateur :
| Métrique | LoRA v0.1 r64 | fine-tune complet v0.1 | LoRA v0.2 r256, 5 étapes |
|---|---|---|---|
| Diversité des échantillons vs modèle de base | 0.75 | 0.72 | 0.93 |
| Dérive de composition vs modèle de base | -0.019 | -0.033 | +0.000 |
La diversité est la distance moyenne entre patchs DINOv2 au sein d'un même prompt sur 8 graines, exprimée en ratio par rapport au modèle de base, et la dérive mesure de combien le centroïde de l'image se déplace par rapport à la sortie du modèle de base pour le même prompt et la même graine. En pratique, cela signifie que la v0.2 conserve la dispersion du modèle de base entre les graines et place les sujets là où le modèle de base le ferait, alors que la v0.1 poussait chaque graine vers des compositions similaires. Les artefacts de la v0.1 restent dans le référentiel pour la reproductibilité, mais Viggle indique qu'il n'y a aucune raison de les préférer.
Comment ça fonctionne
Le modèle étudiant distillé est échantillonné selon un planning fixe plutôt qu'un nombre d'étapes : 5 étapes avec les nœuds sigma [1.0, 0.875, 0.75, 0.5, 0.25], true_cfg_scale=1.0, et sans prompt négatif. Ce sont les nœuds d'entraînement à quatre étapes avec le segment de plus fort bruit scindé en deux, ce qui, selon Viggle, élimine la majeure partie de la perte de détails et des images fantômes d'un simple déploiement en quatre étapes. Les autres nombres d'étapes et valeurs de CFG n'apportent rien.
Deux autres détails comptent pour quiconque veut le câbler :
- Utilisez la configuration de scheduler fournie, ou définissez
shift_terminal=None. Leshift_terminal: 0.02du modèle de base ruinerait la dernière étape. - Gardez l'échelle du LoRA à 1.0, car alpha est égal au rank dans l'adaptateur fourni.
Le text-to-image a été entraîné sur une aire de 1024 et 2048, l'édition sur une aire de 1024 et 1536, et l'édition accepte jusqu'à 3 images de référence dont l'ordre détermine à laquelle <image1>, <image2> et <image3> font référence dans le prompt.
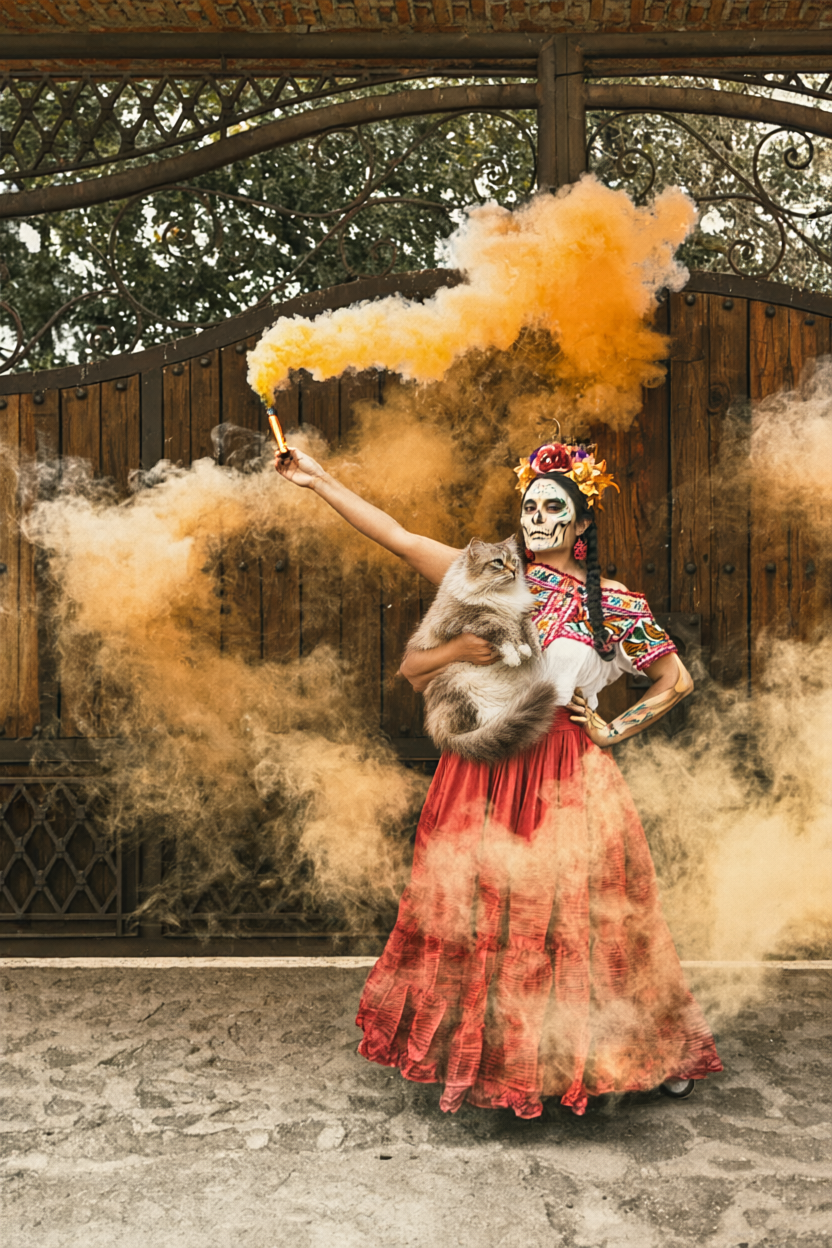
Une édition à deux références en 832x1248 en 5 étapes. Prompt : "The woman from image 1 is holding the cat from image 2 in her arms, keep the background of image 1".
Disponibilité dans ComfyUI
La publication officielle est fournie au format de clé diffusers, avec un adaptateur peft_v0.2 en parallèle, et non au format kohya monofichier que ComfyUI charge directement. Il n'existe donc pas encore de flux de travail ComfyUI officiel. La communauté a comblé ce vide dans la journée suivant la v0.1 :
t8star/Qwen-Image-2.1-viggle-turbo-4step-r64-comfyconvertit l'adaptateur v0.1 r64 en un LoRA chargeable par ComfyUI.- Des builds quantifiées de la lignée 4 étapes existent aussi sous forme de dépôts GGUF (Abiray, realrebelai), destinées aux mêmes configurations à faible VRAM que les autres quantifications de Qwen-Image 2.1.
Le transformer, l'encodeur de texte, le VAE et le processeur du modèle de base Qwen-Image-2.1 ne sont pas redistribués avec la distillation, il faut donc toujours les récupérer depuis le modèle de base, que ComfyUI prend déjà en charge nativement.
Ce qu'il ne fait toujours pas
Viggle précise explicitement que la v0.2 reste un aperçu. Le text-to-image se rapproche du modèle de base, mais les éditions complexes restent à la traîne : la composition multi-références, les échanges de visages et les modifications de documents d'identité peuvent produire des figures dupliquées ou fantômes, les demandes du type « garder tout identique » peuvent dériver sur l'identité, et les textes rendus petits ou longs se brouillent plus souvent qu'à 40 étapes. La sortie 2K n'est pas validée par rapport au professeur, et la sortie RGBA, plus de 3 références et l'édition locale basée sur masque ne sont pas testées.
Le modèle est déjà adopté dans la communauté ComfyUI, la publication circulant dans le canal #qwen-image de Banodoco et sur r/StableDiffusion.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.