Ming-Image 0.1 Design : modèle UI et poster 6B dans ComfyUI
Ming-Image 0.1 Design est le modèle texte-image 6B d'inclusionAI pour les UI, infographies et posters riches en texte, avec transparence RGBA et support ComfyUI officiel.
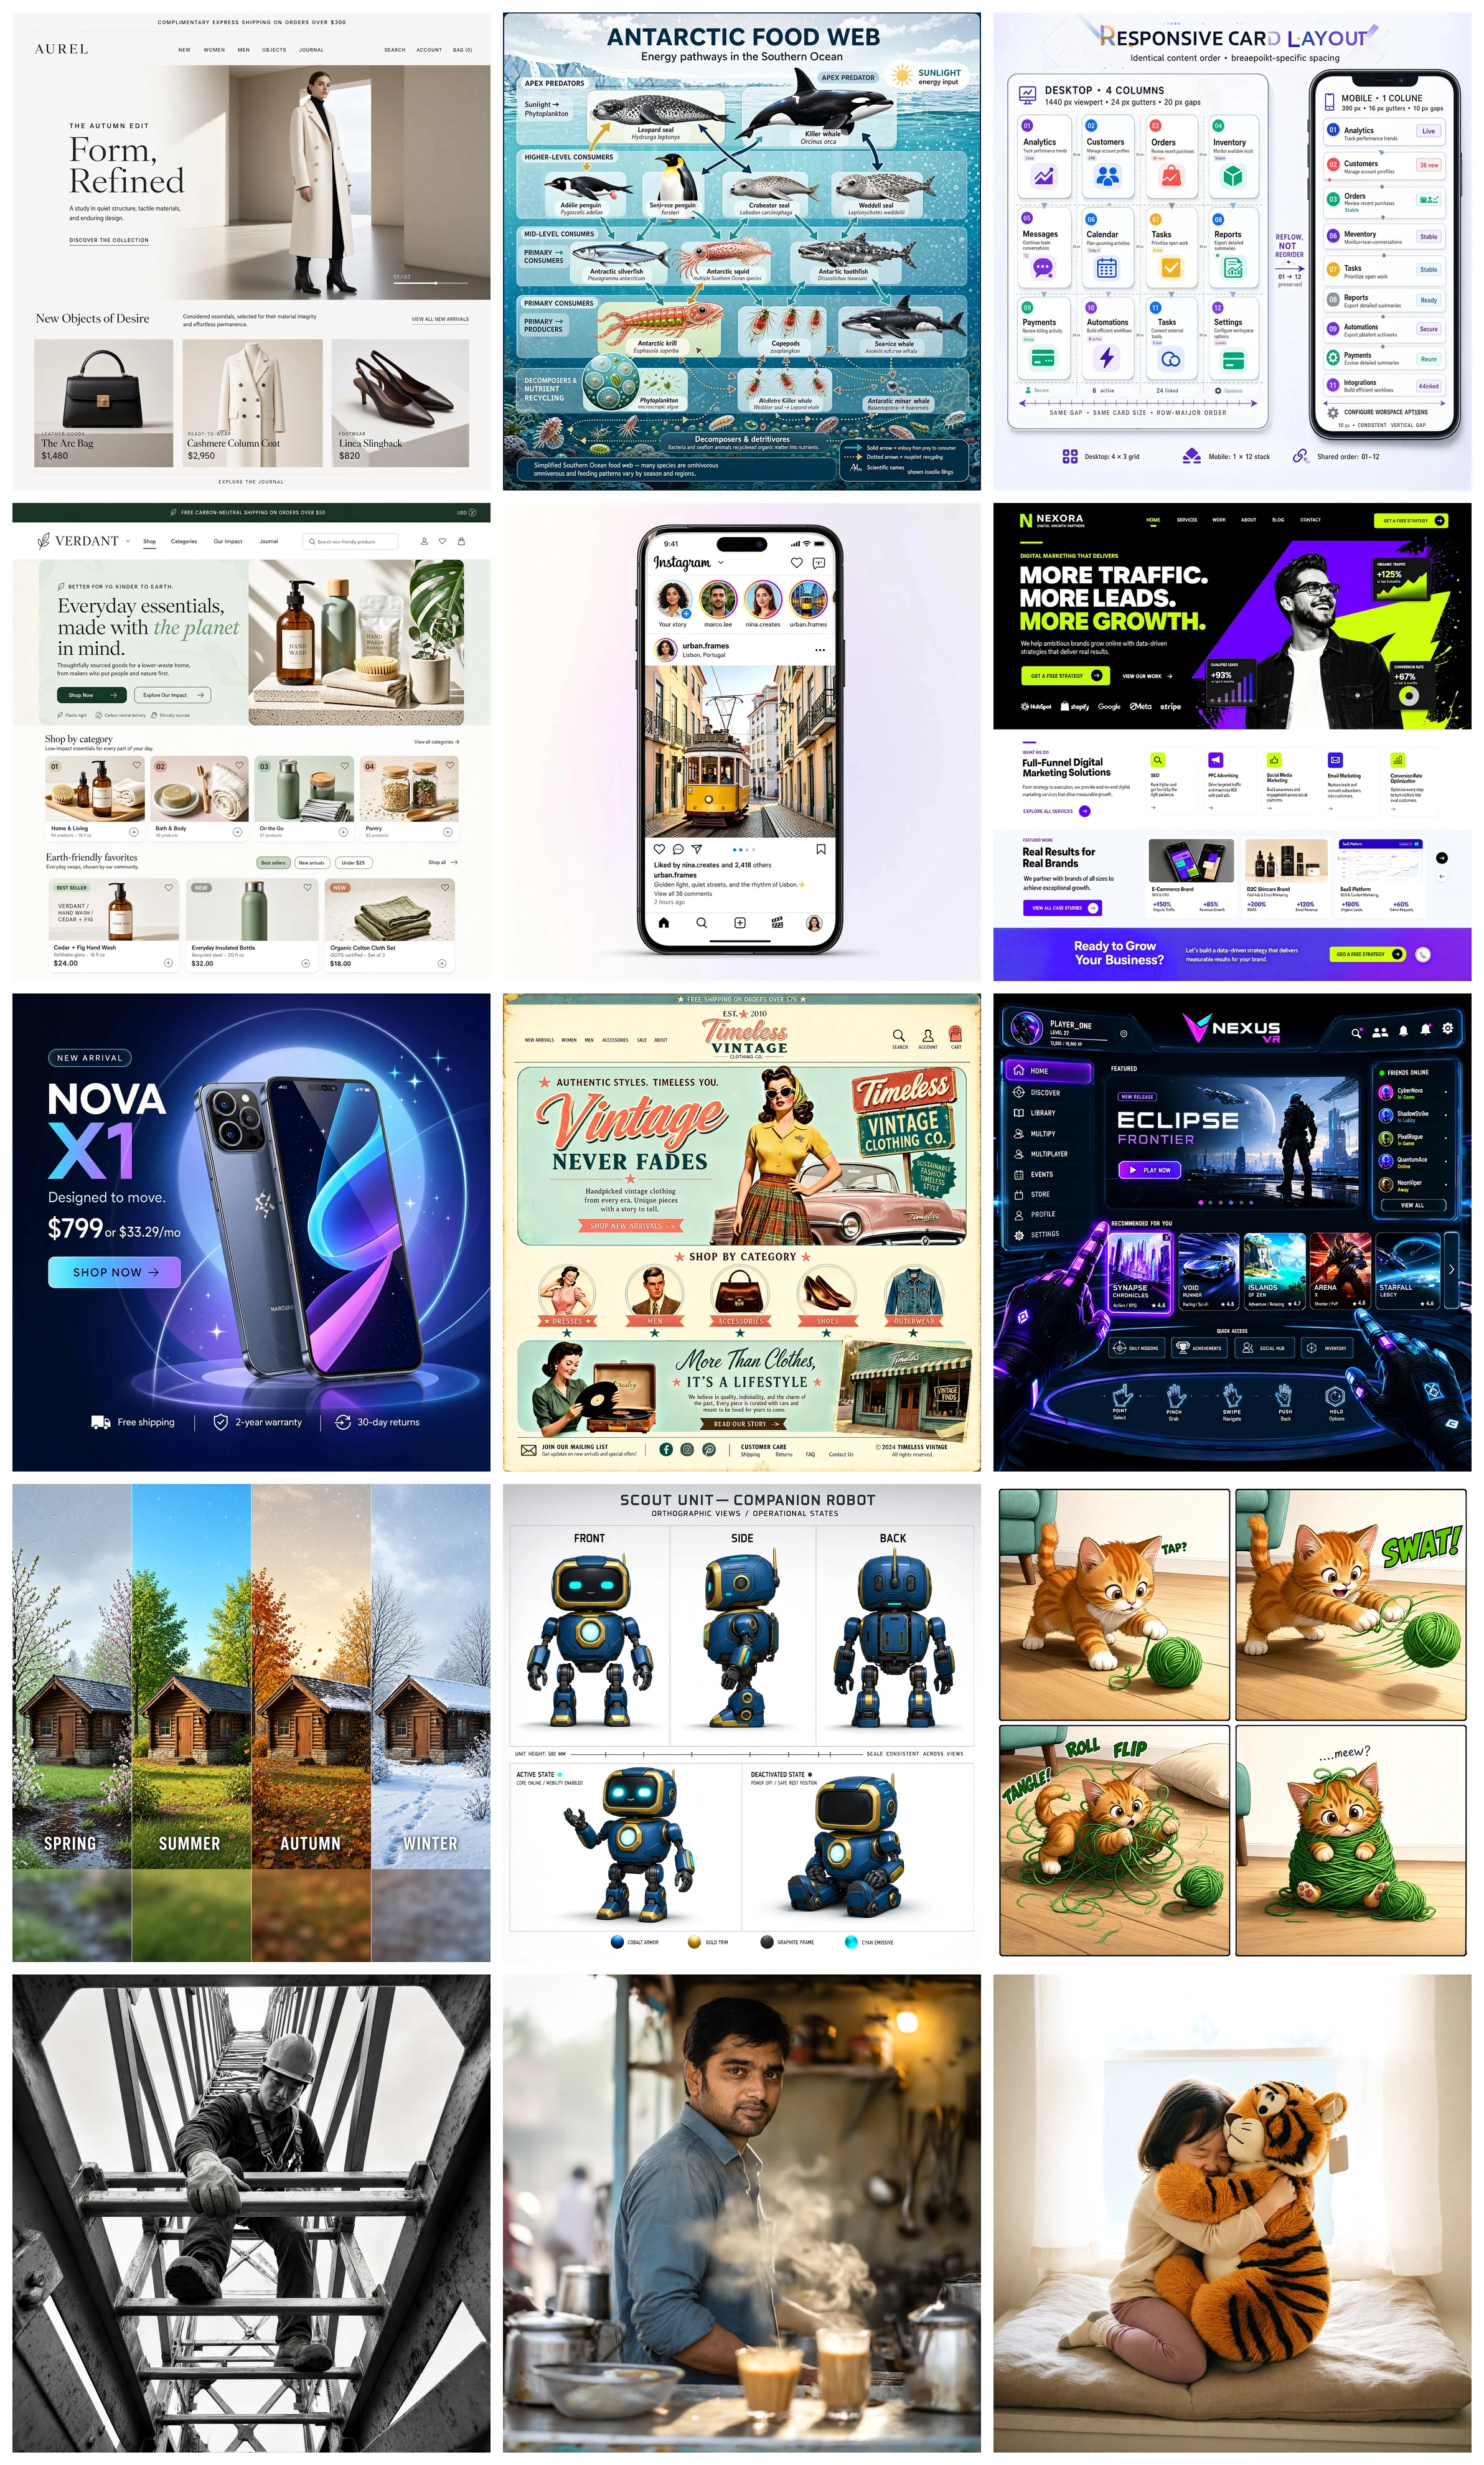
Exemples de design issus de la carte de modèle officielle.
Ce qu'est Ming-Image 0.1 Design
Ming-Image 0.1 Design vient d'inclusionAI, l'équipe derrière les familles de modèles Ling et Bailing, et il cible une tâche que les modèles d'image généraux gèrent mal : composer un design propre et lisible plutôt qu'une photographie. Les écrans, tableaux de bord, mises en page de cartes responsives, panneaux infographiques, affiches produit et planches de logos constituent le contenu cible, et les exemples officiels insistent fortement sur la lisibilité et la qualité typographique du texte rendu.
- Transformer de diffusion 6B. Le DiT est une architecture à 30 couches et 3840 dimensions, avec 16 canaux d'entrée et un patching 2x2, associé à un encodeur vision-langage distinct et à son propre connecteur. Kijai décrit la base comme dérivée de Z-Image avec un nouvel encodeur de texte.
- Des données d'entraînement orientées design plutôt qu'un corpus photographique général, ce qui explique que les sorties se lisent comme des mises en page composées avec de vrais blocs de texte.
- Deux buckets de sortie natifs, 1024 et 2048, le 2048 étant recommandé pour les mises en page complètes.
- Les valeurs d'échantillonnage par défaut sont courtes : 12 étapes à CFG 1.0, un design est donc produit en un petit nombre de passes.
- L'amélioration du prompt fait partie du flux prévu. Le pipeline officiel recommande de réécrire le prompt avec
Ling-3.0-flash-VLouqwen3.8-27Bavant la génération, ce qui compte surtout pour les mises en page denses comportant beaucoup de texte à placer.
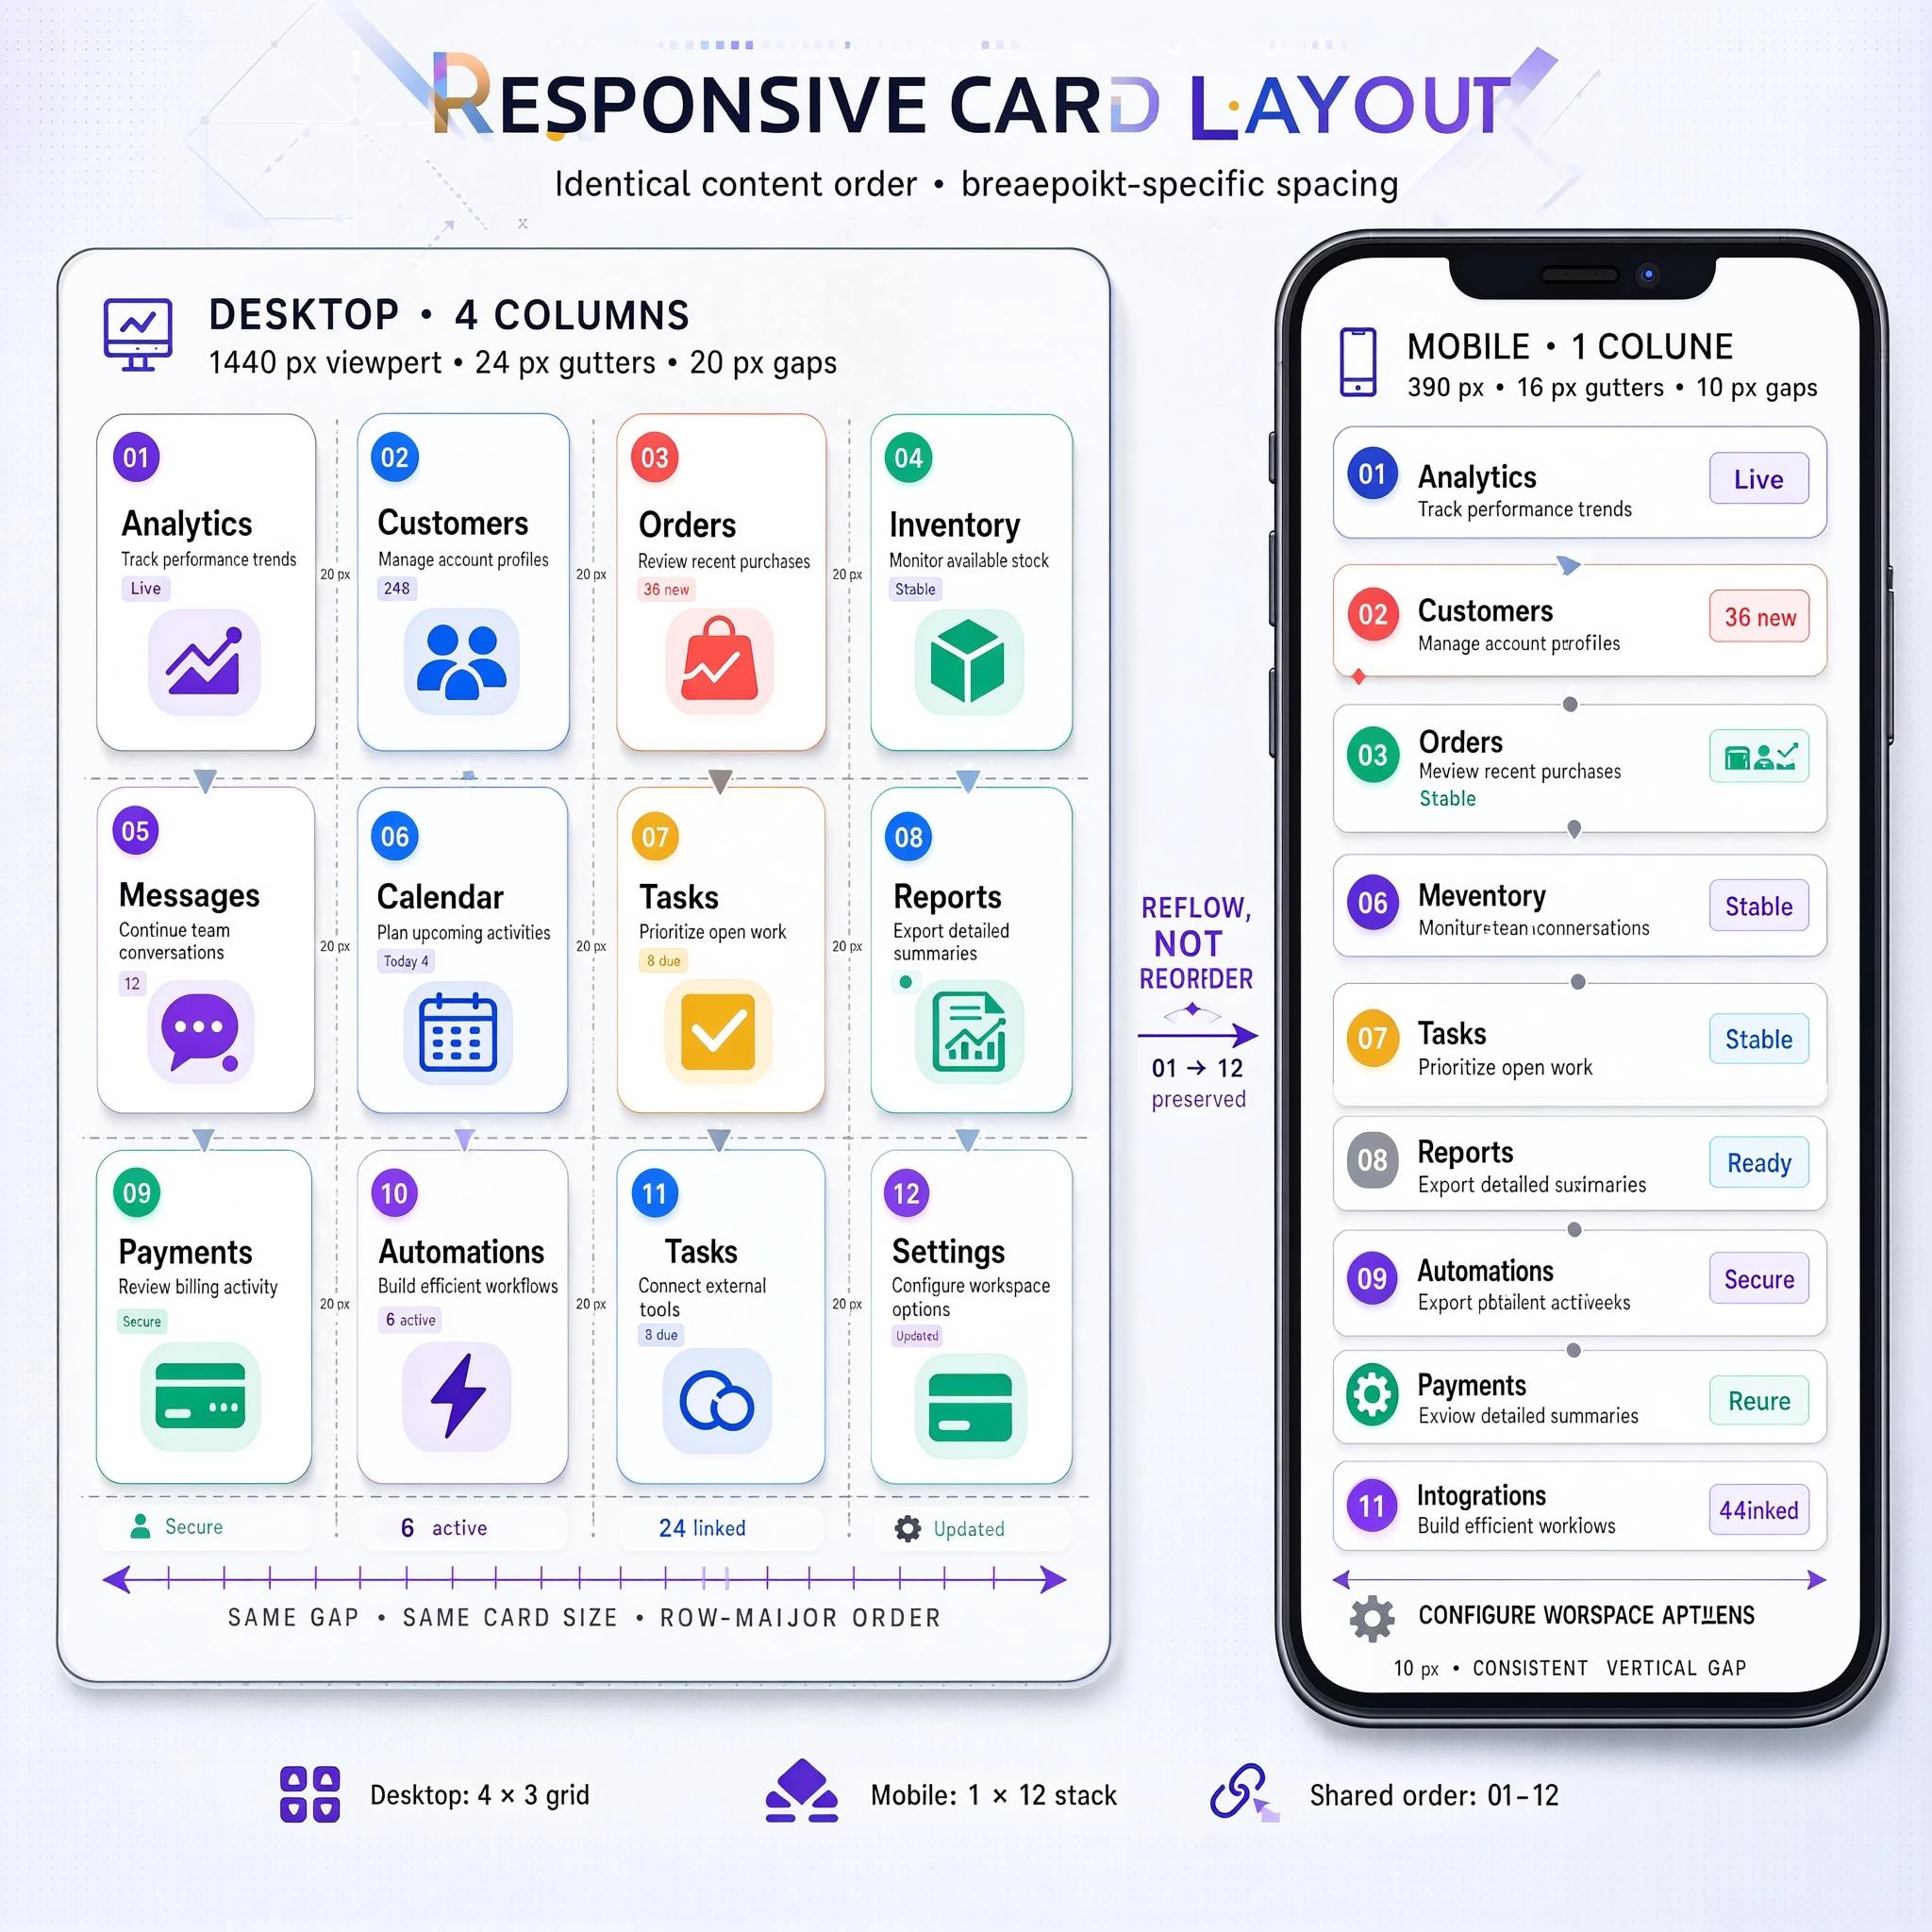
Une mise en page de cartes responsive, l'un des exemples officiels de génération texte-image.
Les arrière-plans transparents comme sortie de premier ordre
En plus des images ordinaires, Ming-Image 0.1 Design peut produire une image RGBA avec un véritable canal alpha : un élément d'affiche généré, un détourage produit ou un asset d'interface arrive prêt à être composé, sans passer par une étape de détourage distincte. La carte de modèle fournit un ensemble de phrases déclencheuses recommandées et demande d'en préfixer exactement une, le même schéma que celui utilisé par Qwen-Image 2.1 pour son mode transparence.
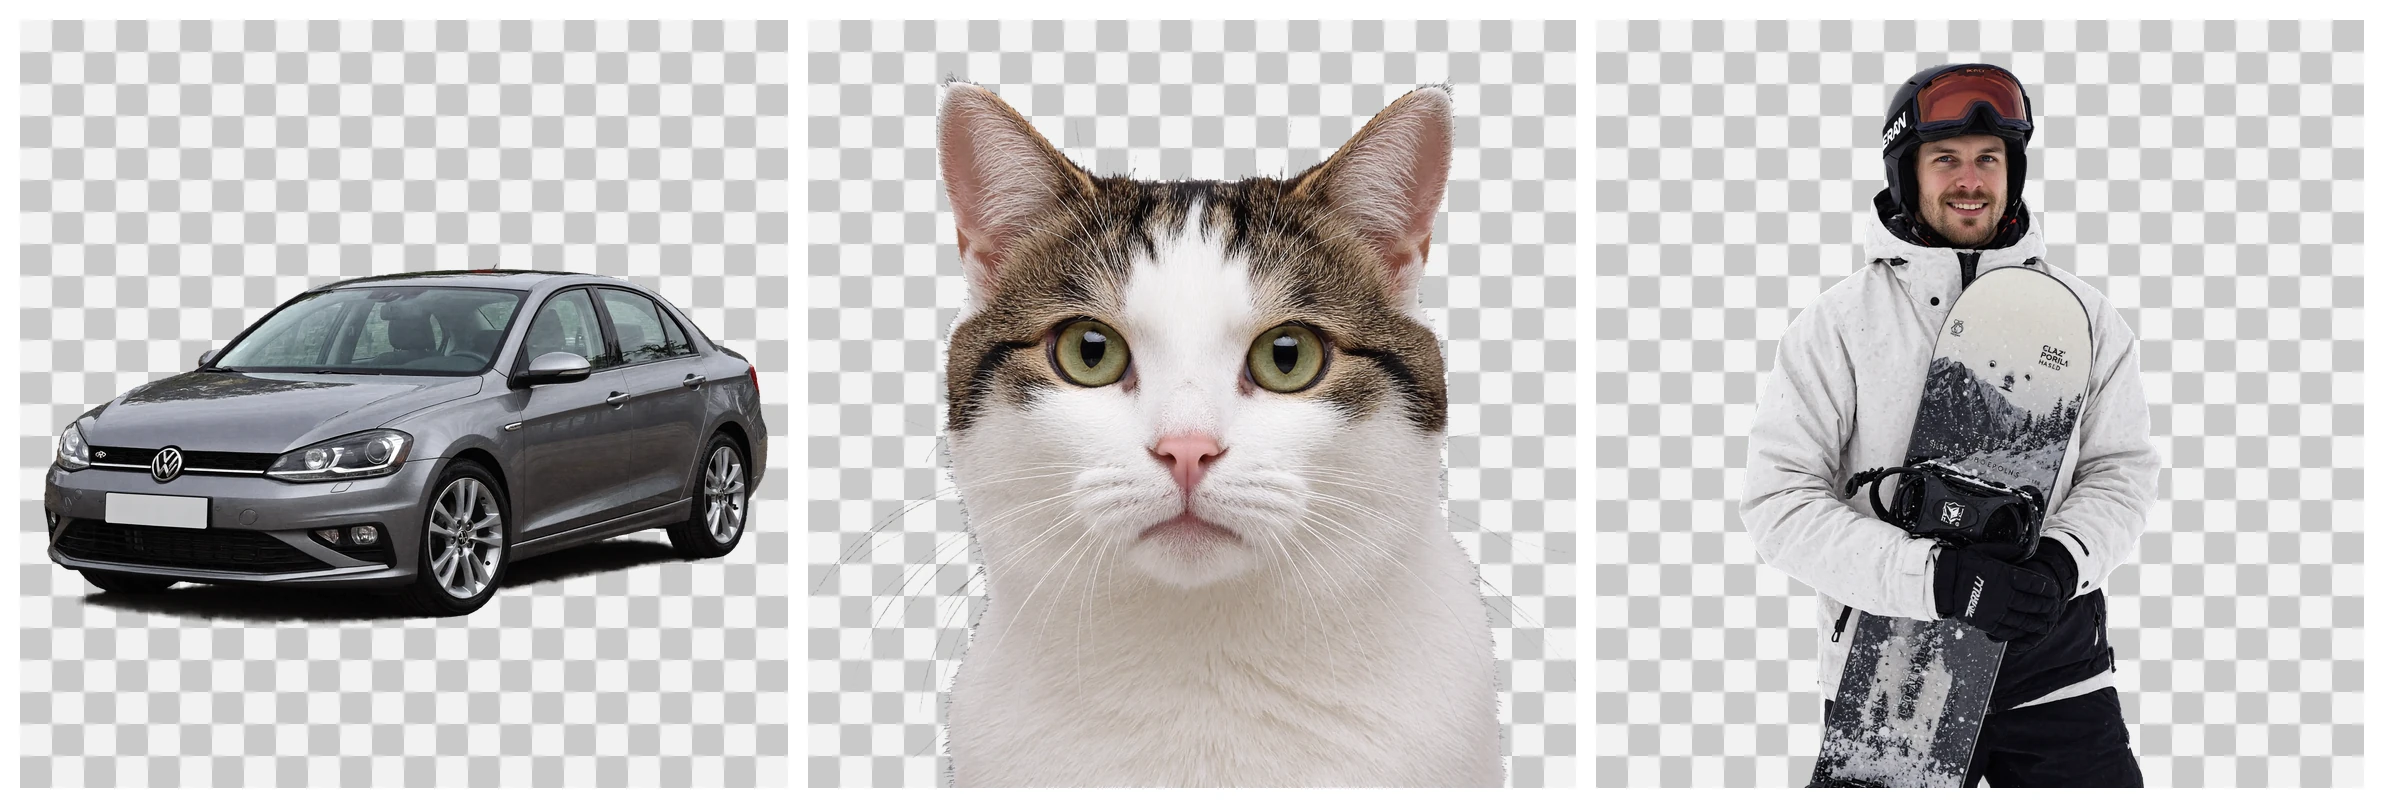
Sorties à arrière-plan transparent. Le damier prévisualise le canal alpha et ne fait pas partie de l'image générée.
Le frère Layer : du design aux calques modifiables
La série comporte un second checkpoint 6B, Ming-Image 0.1 Design Layer, qui traite le problème en sens inverse : il prend une image de design aplatie et la décompose en calques transparents modifiables séparément. C'est l'étape qui transforme une maquette générée en quelque chose sur quoi vous pouvez réellement travailler dans un outil de design, et inclusionAI l'accompagne de deux flux de travail d'agents publiés : une compétence Ling UI Design qui utilise des références générées et la décomposition en calques pour construire et vérifier visuellement du code d'interface, et une compétence image-to-editable-PPT qui recrée une page générée sous forme d'éléments PowerPoint natifs.
Le checkpoint Layer utilise des valeurs d'échantillonnage par défaut différentes de celles du modèle de design : 12 étapes à CFG 2.0, avec des buckets de travail de 512 et 1024.
Sa place dans le classement UI/UX
inclusionAI a publié le modèle sur le classement UI/UX Design d'Artificial Analysis en même temps que la sortie, ce qui constitue le signal le plus clair des concurrents du modèle.
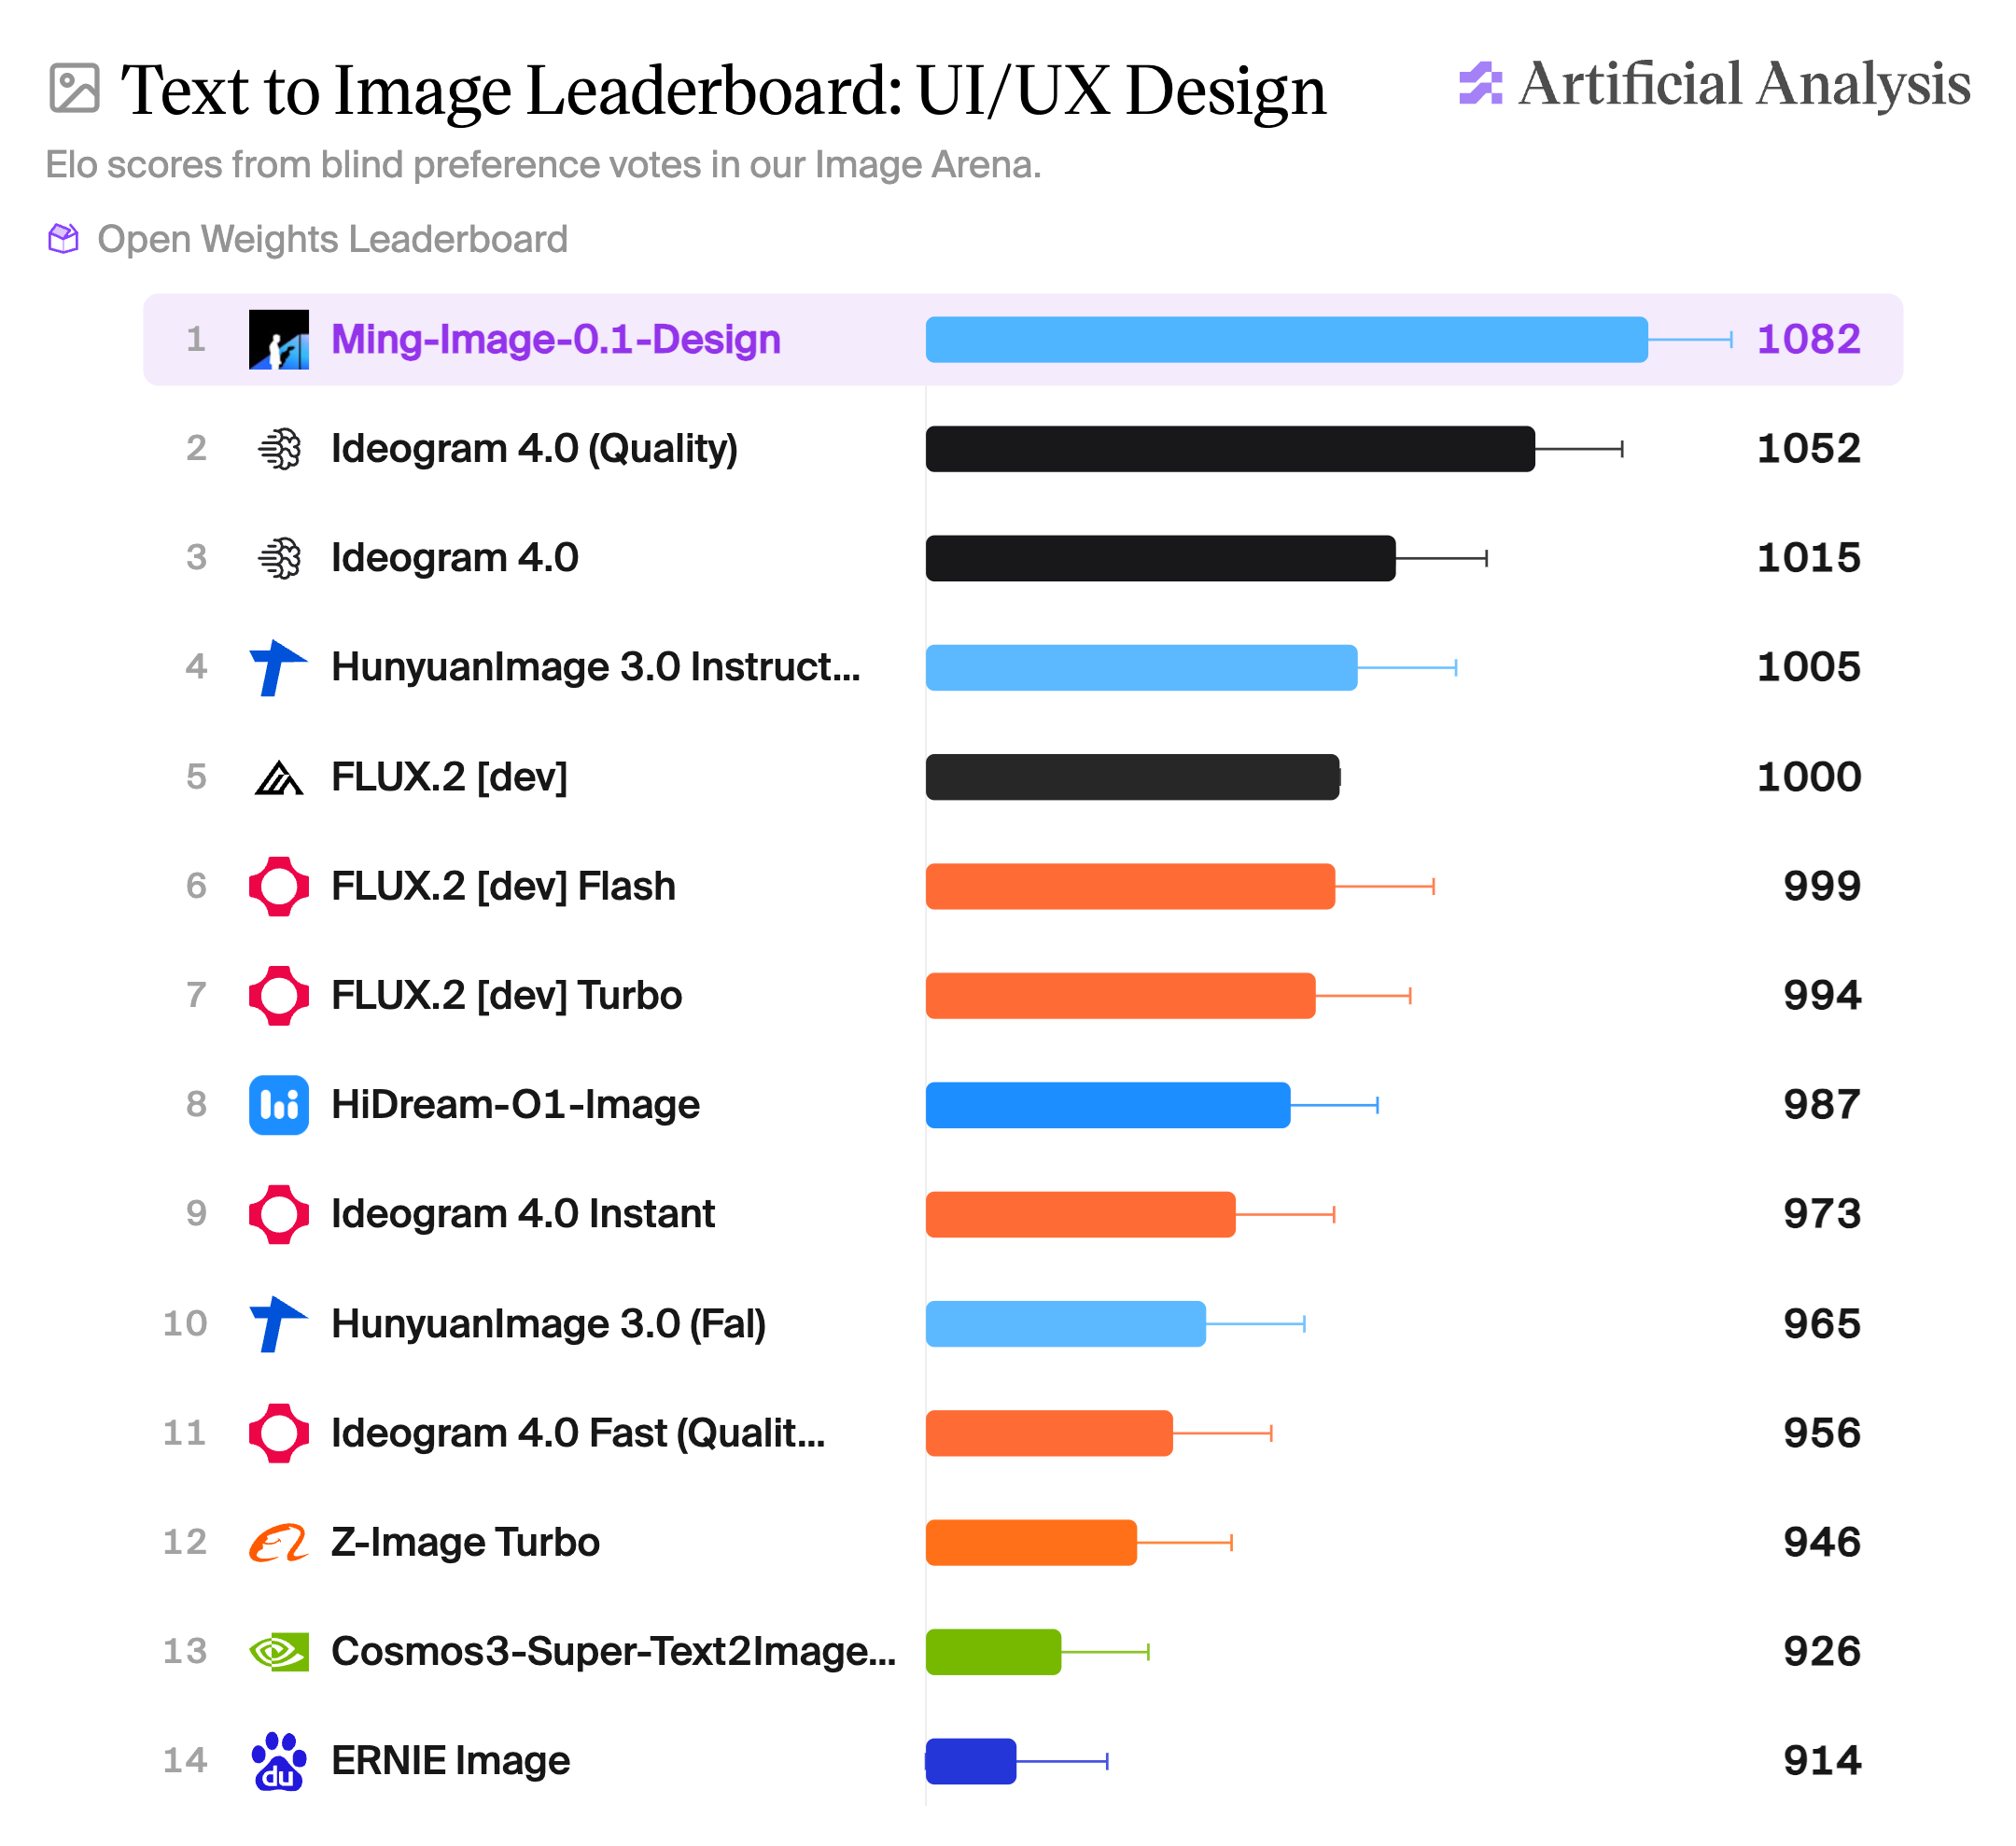
Positionnement de Ming-Image 0.1 Design dans le classement UI/UX Design, d'après le référentiel officiel.
Disponibilité dans ComfyUI
La prise en charge de Ming-Image dans le cœur de ComfyUI a été fusionnée le 24 septembre 2026 dans la PR ComfyUI #16482, les deux checkpoints se chargent donc désormais dans une installation non modifiée :
- Les poids repackagés sont publiés sous
Comfy-Org/Ming-Image: builds BF16 etint8_convrotdes transformers Design et Layer, l'encodeur de texte Ling-Mini-2.0 (ainsi qu'un buildw4a8et des variantes propres à Layer) et le VAE, organisés dans les dossiers habituelsdiffusion_models/text_encoders/vae. Le repack antérieur de Kijai,Kijai/Ming-Image-ComfyUI, couvre la même chose. - L'implémentation dans le cœur ajoute un nœud
Text Encode Ming Image Edit(TextEncodeMingImageEdit) qui prend le clip, jusqu'à 8 images de référence et un VAE optionnel. Sans le VAE, les références n'atteignent l'encodeur de texte que par sa tour de vision ; avec lui, elles sont encodées et ajoutées à la séquence latente comme images de référence propres. ComfyUI distingue Design et Layer à partir des métadonnées du repack, Layer se charge donc par le même chemin. - Aucun modèle de flux de travail officiel n'est encore fourni, le graphe doit donc toujours être construit à la main autour des chargeurs de checkpoint.
Les premiers tests dans le canal #ming-image de Banodoco suggèrent que les échantillonneurs comptent ici plus que d'ordinaire : Kijai note que la sortie LCM est propre mais trop lisse et que des échecs de texte aléatoires restent fréquents en INT8, tandis que RuneX rapporte que le modèle répond à des prompts de style boîte englobante et s'édite rapidement compte tenu de sa petite taille.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.