Les modèles Prompt Enhancer Qwen-Image 2.1 s'exécutent dans ComfyUI
Les modèles PE-T2I et PE-I2I de Qwen développent les requêtes courtes et les instructions d'édition, et un pack de nœuds les exécute dans ComfyUI via Load CLIP.
Deux réécrivains, un pour chaque tâche
Les checkpoints PE sont des modèles Qwen3.5-VL 9B affinés, publiés le 2026-09-20 en même temps que le modèle de base, et le README officiel de Qwen-Image 2.1 les recommande comme méthode par défaut pour préparer les prompts : « Pour de meilleurs résultats, nous recommandons d'utiliser les modèles officiels de réécriture de prompt afin de développer les prompts courts en descriptions détaillées et de haute qualité. »
- PE-T2I transforme une requête brève, dans n'importe quelle langue, en un long prompt anglais accompagné d'un format d'image recommandé. Sa réponse revient sous forme de JSON après un bloc
think:{"rewritten_prompt": ..., "wh_ratio": "16:9"}. - PE-I2I prend une instruction d'édition accompagnée de jusqu'à 10 images de référence, désignées par
<image1>,<image2>, etc., et renvoie un prompt d'édition précis. Sa réponse JSON ajouteratio_follow, qui nomme l'image d'entrée dont la sortie doit hériter du format d'image.
Les deux sont conçus pour être échantillonnés avec le mode thinking activé : l'exemple officiel utilise temperature 1.0, top_p 0.95, top_k 20, avec max_new_tokens 16256 pour le checkpoint text-to-image et 24000 pour celui d'édition.
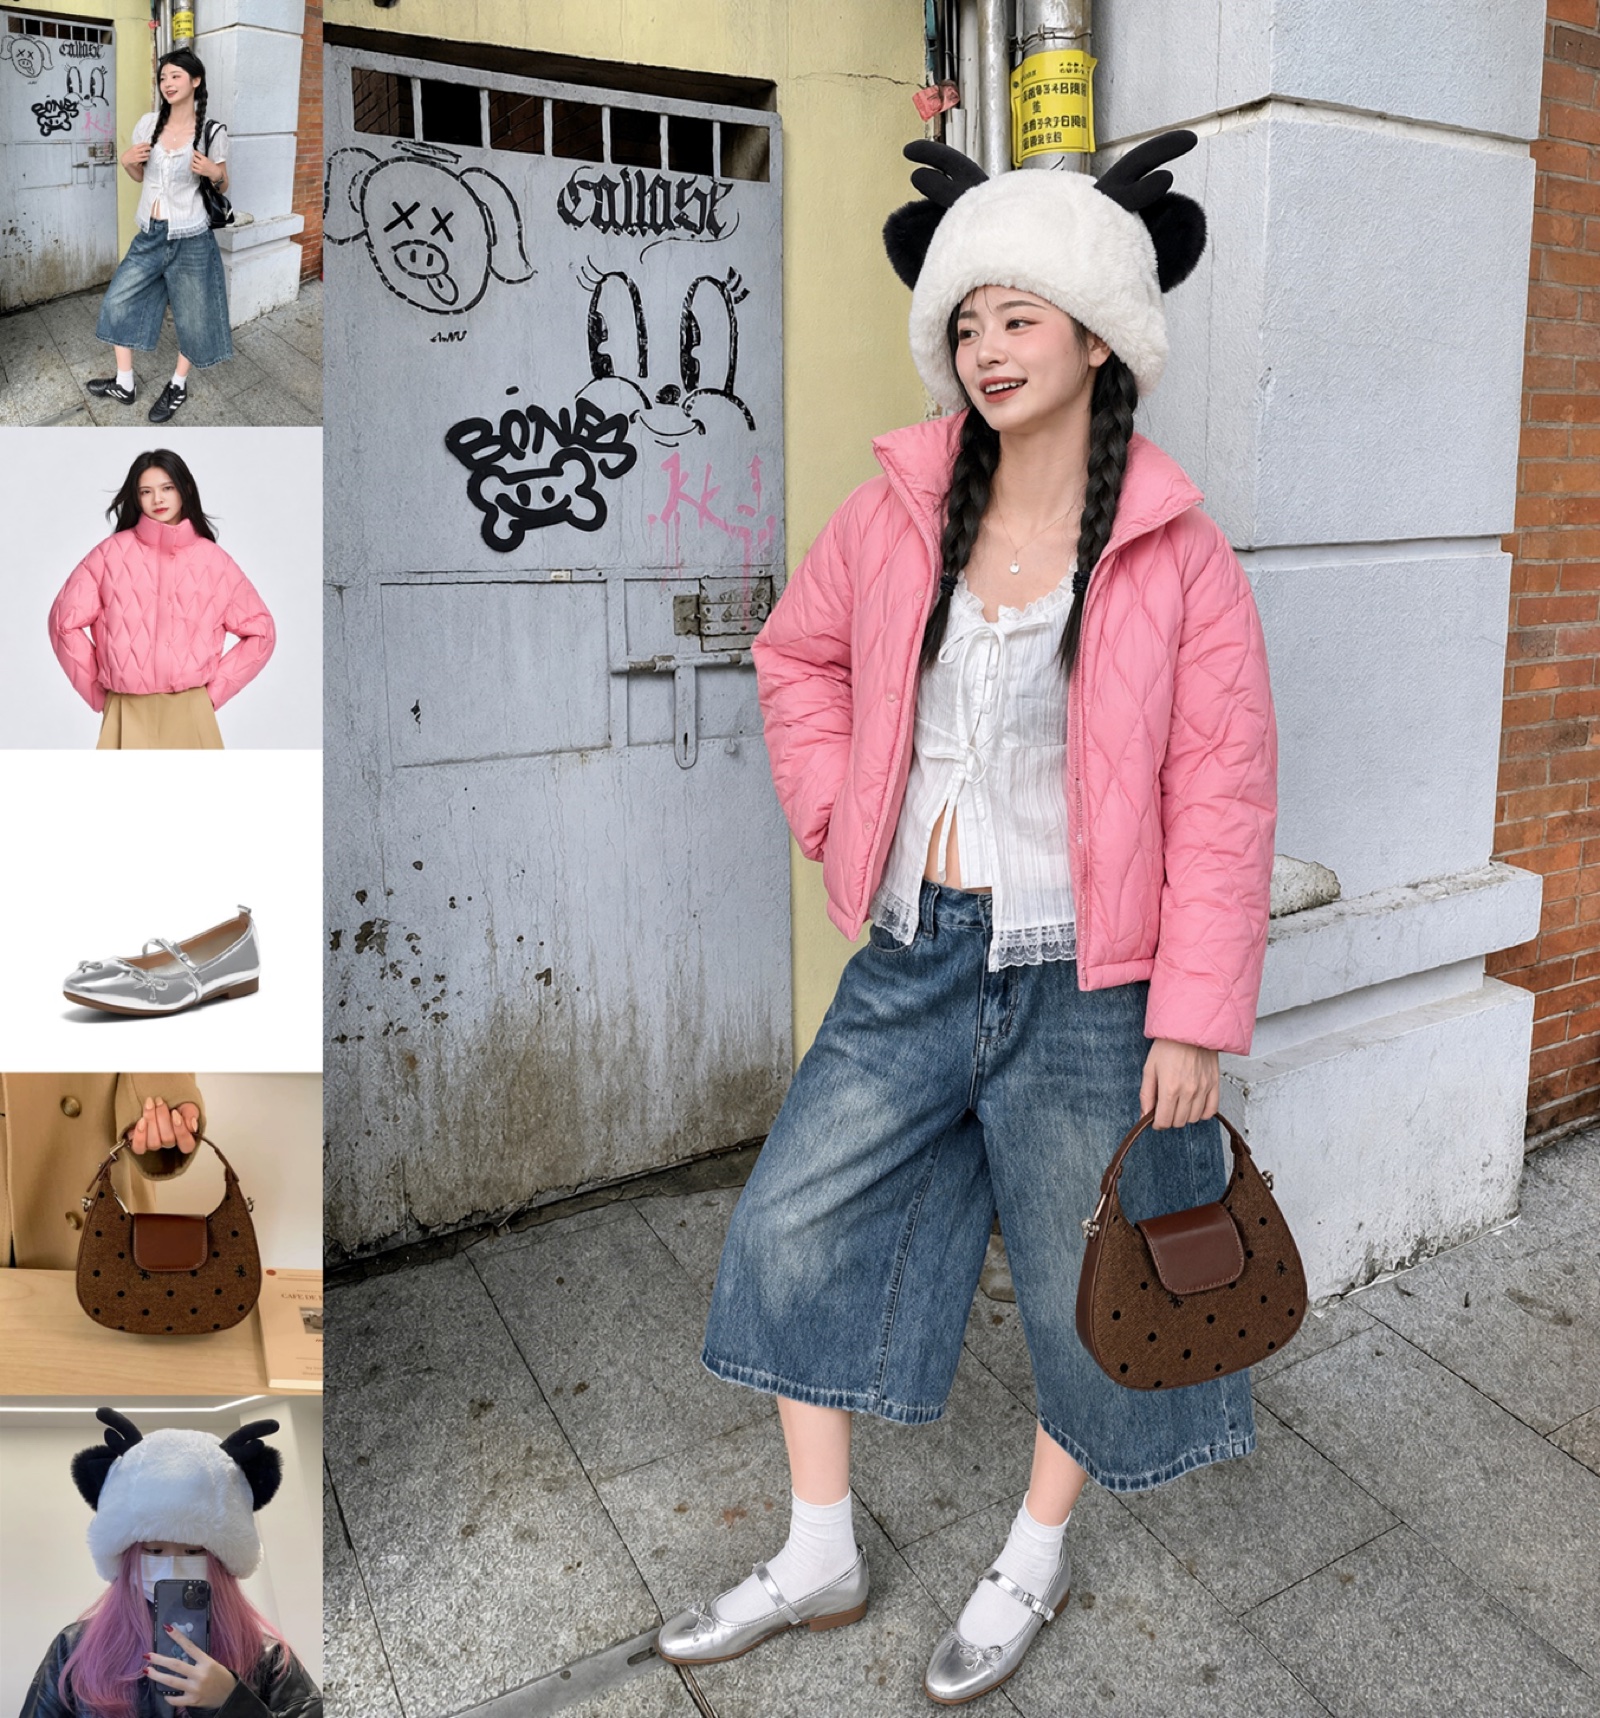
Exemple officiel de Qwen-Image 2.1 : une tenue assemblée à partir de cinq images de référence, le type d'instruction multi-image que le réécrivain PE-I2I est entraîné à transformer en prompt explicite.
Les exécuter dans ComfyUI
Les trois gabarits officiels Qwen-Image 2.1 de ComfyUI couvrent le text-to-image, l'édition d'image et la suppression de l'arrière-plan, et aucun d'eux ne fait appel aux réécrivains. Comfy-Org a bien reconditionné les deux poids PE en fichiers int8 convrot dans Comfy-Org/Qwen-Image-2.1 (text_encoders/qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors et ..._pe_i2i...), mais les charger ne représente que la moitié du travail : il faut encore construire le prompt de chat, relire le JSON et exposer le résultat à un sampler.
Le pack de nœuds fait exactement cela avec deux nœuds, tous deux enregistrés sous la catégorie Qwen Image :
| Nœud | Entrées | Sorties |
|---|---|---|
QwenImage21_T2IPromptRewrite | CLIP, prompt, contrôles d'échantillonnage | positive_prompt, negative_prompt, wh_ratio, thinking, parse_ok |
QwenImage21_EditPromptRewrite | CLIP, prompt, image_1 … image_10 | les mêmes, plus ratio_follow |
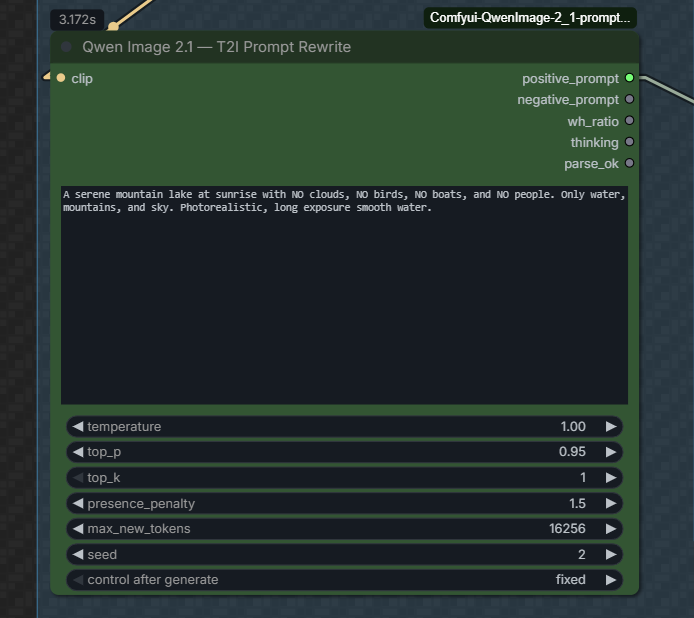
Le nœud de réécriture T2I : un prompt court en entrée, le prompt développé, le format d'image et la trace de raisonnement en sortie.
Le fichier PE est chargé par le nœud ordinaire Charger CLIP avec type = qwen_image, et la génération passe par le chemin clip.tokenize() → clip.generate() → clip.decode() propre à ComfyUI, le même mécanisme que celui du nœud TextGenerate intégré. Aucun serveur externe, aucun pipeline transformers distinct.
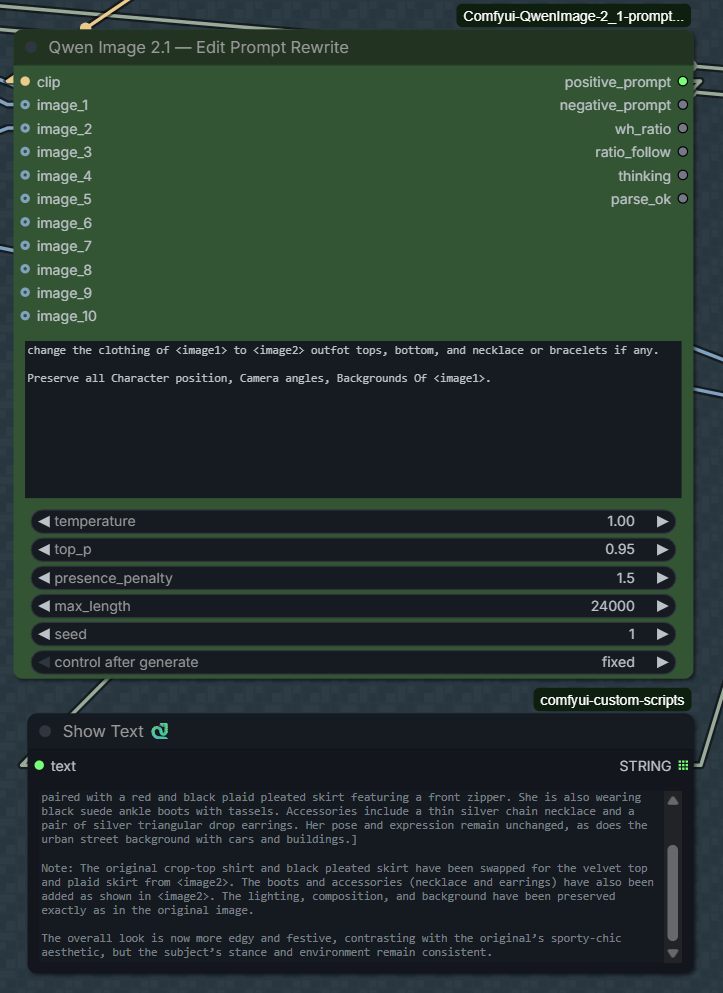
Le nœud d'édition expose dix emplacements d'image et renvoie l'instruction réécrite ainsi que le ratio à hériter.
Quelques paramètres méritent d'être repris du README, car les deux checkpoints ne les partagent pas :
| Paramètre | T2I | Édition |
|---|---|---|
presence_penalty | 1.5 | 0 |
max length | 16256 | 24000 |
thinking | on | on |
Cette pénalité élevée empêche le réécrivain text-to-image de se répéter, tandis que le réécrivain d'édition est censé fonctionner sans elle. Les deux modèles ont été entraînés avec des blocs think, le pack sépare donc la trace de raisonnement de la réponse avant d'analyser le JSON et signale parse_ok lorsque la réponse s'analyse correctement. L'installation du paquet optionnel json_repair lui permet de récupérer des réponses légèrement malformées au lieu d'échouer.
L'intégrer dans un graphique
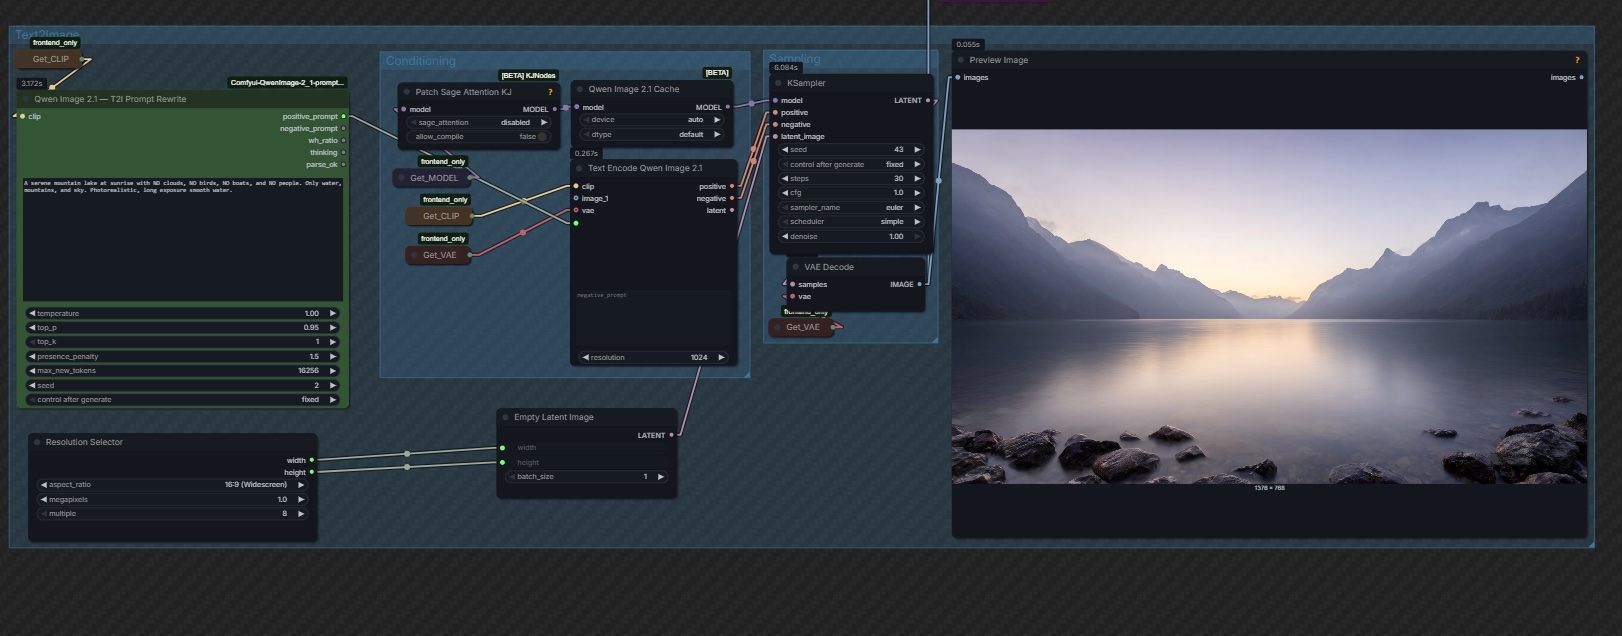
Le graphique du README : Charger CLIP sur le checkpoint PE alimente le nœud de réécriture, et son positive_prompt se poursuit vers Text Encode Qwen Image 2.1.
Pour une exécution text-to-image, la chaîne réécrite remplace ce que vous auriez saisi dans le nœud d'encodage de texte, et wh_ratio peut piloter un sélecteur de résolution au lieu d'une largeur et d'une hauteur choisies manuellement. Pour une exécution d'édition, les images de référence vont dans les emplacements d'image du nœud, l'instruction les référence sous la forme <image1> et <image2>, et ratio_follow détermine à quelle entrée la toile de sortie doit correspondre.
Disponibilité
- PE-T2I : Qwen/Qwen-Image-2.1-PE-T2I sur Hugging Face
- PE-I2I : Qwen/Qwen-Image-2.1-PE-I2I sur Hugging Face
- Copies prêtes pour ComfyUI : Comfy-Org/Qwen-Image-2.1 sous
text_encoders/, int8 convrot - Pack de nœuds : benjiyaya/ComfyUI-Qwen-Image-2.1-Prompt-Enhancer, cloné dans
ComfyUI/custom_nodes/ - Code de réécriture officiel :
prompt_rewrite/dans le référentiel Qwen-Image 2.1, avec des points d'entrée transformers, vLLM et serveur vLLM
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.