MiniMax H3 TRT VAE : décodage H3 1,7x plus rapide dans ComfyUI
Un pack de nœuds ComfyUI compile le VAE vidéo de MiniMax H3 en TensorRT et réduit jusqu’à 1.7x le décodage du VAE, avec un décodeur w4a16 pour faible VRAM.
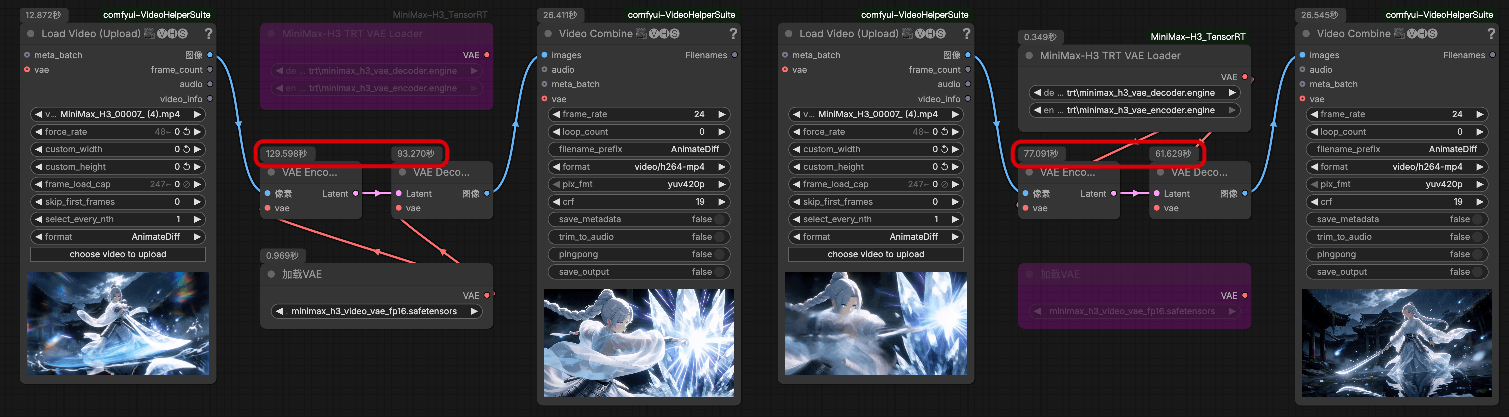
Aperçu tiré du README du projet : les nœuds de compilation et de chargement du VAE TRT dans un graphique ComfyUI.
Le décodage VAE est un coût fixe à chaque exécution H3. Les kernels intégrés de ComfyUI ont déjà réduit ce coût côté PyTorch ; ce nœud prend l'autre voie et confie le VAE à un moteur TensorRT compilé.
Ce que fait le nœud
Le pack fournit deux nœuds et une voie ONNX vers le moteur :
- MiniMax-H3 TRT VAE Compiler prend l'encodeur et le décodeur ONNX et construit les moteurs TensorRT. C'est une étape unique, et les moteurs compilés sont réutilisés par la suite.
- MiniMax-H3 TRT VAE Loader charge les moteurs compilés afin qu'ils puissent être utilisés à la place du VAE habituel.
Les poids sont publiés sous forme de fichiers ONNX sur Hugging Face et vont dans ComfyUI/models/vae. Le pack inclut également un compile.py autonome pour construire les moteurs en dehors de ComfyUI, ce qui est utile lorsque l'étape de compilation ne doit pas bloquer l'interface.
Installation
| Étape | Action |
|---|---|
| 1 | git clone https://github.com/lihaoyun6/ComfyUI-H3VAE_TRT dans ComfyUI/custom_nodes puis installez requirements.txt |
| 2 | Téléchargez l'encodeur et le décodeur ONNX dans ComfyUI/models/vae |
| 3 | Exécutez MiniMax-H3 TRT VAE Compiler une fois pour construire les moteurs |
| 4 | Basculez le VAE du flux de travail vers MiniMax-H3 TRT VAE Loader |
Le référentiel ONNX contient aussi une variante de décodeur w4a16_awq, que le README recommande lorsque le GPU ne dispose pas de 12 Go de VRAM ou plus.
Notes du suivi des problèmes
Les problèmes du référentiel valent la peine d'être lus avant de compiler, car les builds TensorRT sont sensibles à la pile installée :
- La compilation des moteurs est lente. Un signalement a mesuré plus de cinq heures pour une seule compilation, donc la première compilation est mieux réalisée à l'avance plutôt qu'en pleine session.
- Les versions de TensorRT et de CUDA doivent correspondre. Des signalements ouverts concernent TensorRT 11.2 avec CUDA 13.0, ainsi qu'une erreur d'utilisation de l'API
IBuilder::buildSerializedNetworksur une autre configuration. - Un motif de grille laissé par l'encodeur compilé sur les premières, dernières et images de référence a été signalé et corrigé début septembre, donc une compilation depuis le
mainactuel l'évite.
Disponibilité
Le pack de nœuds et les poids ONNX sont tous deux publics :
Pack de nœuds : lihaoyun6/ComfyUI-H3VAE_TRT
Poids ONNX : lihaoyun6/MiniMax-H3-VAE-ONNX
Modèle de base : MiniMaxAI/MiniMax-H3
Le pack n'inclut aucun flux de travail d'exemple : le compilateur et le chargeur s'insèrent dans un graphique H3 existant à la place du nœud VAE standard.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.