Le LoRA MiniMax H3 VFX Edit apporte l'édition vidéo dirigée par prompt
Le pack LoRA MiniMax H3 d'Alissonerdx ajoute VFX Edit dirigé par prompt, ainsi que des adaptateurs Style Transfer et Head Swap documentés, avec des flux de travail ComfyUI.
Le référentiel est le même que celui du LoRA de netteté H3 présenté plus tôt en septembre, et il s'agit de l'un des packs LoRA H3 les plus utilisés, avec environ 239 likes et 26 600 téléchargements au moment de la rédaction. Tous les modèles sont entraînés sur les poids ref2va de H3 et partagent la même astuce de conditionnement : le clip source est injecté comme guide aligné via le nœud central MiniMaxH3AddGuide à frame_idx = 0, de sorte que le modèle voit la prise originale alignée image par image plutôt que comme une simple référence vidéo.
Contenu du pack
| Modèle | Ce qu'il fait | Déclencheur | Flux de travail |
|---|---|---|---|
minimax_h3_vfx_edit_v1.0_r128 | Édition VFX dirigée par prompt sur un clip source aligné | vfx_edit: | minimax_h3_vfxedit_wokflow.json |
minimax_h3_vfx_edit_v1.0_r128_ffp | Édition VFX en plus haute résolution avec propagation expérimentale de la première image | vfx_edit: | même flux de travail |
minimax_h3_style_transfer_v1.0_r64 | Restyliser un clip entier à partir d'une image ou d'une description textuelle | style_transfer: | minimax_h3_style_transfer_workflow.json |
minimax_h3_head_swap_v1.0_r32 | Remplacement de tête expérimental sur un clip aligné | head_swap: | minimax_h3_head_swap_workflow.json |
minimax_h3_lms_v1.0_r64 | Récupération de netteté et de détails (l'adaptateur d'origine) | légende fixe | minimax_h3_lms_workflow.json |
Une expérience distincte d'upscaler latent accompagne les LoRA, et les poids de VFX Edit ont été mis en ligne le 21 septembre 2026.
VFX Edit
VFX Edit est l'ajout phare : donnez-lui un clip et une instruction d'une seule phrase, et il renvoie la même prise avec cette seule modification appliquée.
vfx_edit: Add fire effects to the man's hands while preserving his identity, pose, motion, clothing, framing, lighting and background.Le schéma recommandé par la documentation consiste à énoncer d'abord la modification, puis à lister ce qui doit rester intact, et à ne jamais demander au modèle de préserver exactement la zone qu'il est censé remplacer. Deux versions sont publiées :
- Standard (
r128) a été entraînée dans le regroupement de résolution 384 sur des clips de 73 images et ne nécessite aucune image de référence. - FFP (
r128_ffp, propagation de la première image) poursuit cet entraînement dans le regroupement 512 sur des clips de 124 images et ajoute la prise en charge expérimentale de la propagation d'une première image modifiée via le canal de référence d'image natif de H3. Si une image est fournie, le prompt doit nommer explicitement<Picture 1>et expliquer son rôle ; sinon, le prompt ne doit mentionner ni<Picture 1>ni<Subject 1>.
Pour l'utiliser, placez tout le clip source dans MiniMaxH3AddGuide plutôt que dans un emplacement de référence vidéo, faites correspondre le rapport d'aspect de la source et un nombre d'images pris en charge, et commencez avec une force de LoRA de 1.0. Les limitations publiées sont honnêtes sur ce que cet outil n'est pas : dérive d'identité, texte et logos réécrits, détails fins faibles et résultats moins bons sur les clips longs. Ce n'est pas un compositeur et cela ne garantit pas une préservation exacte au pixel près.
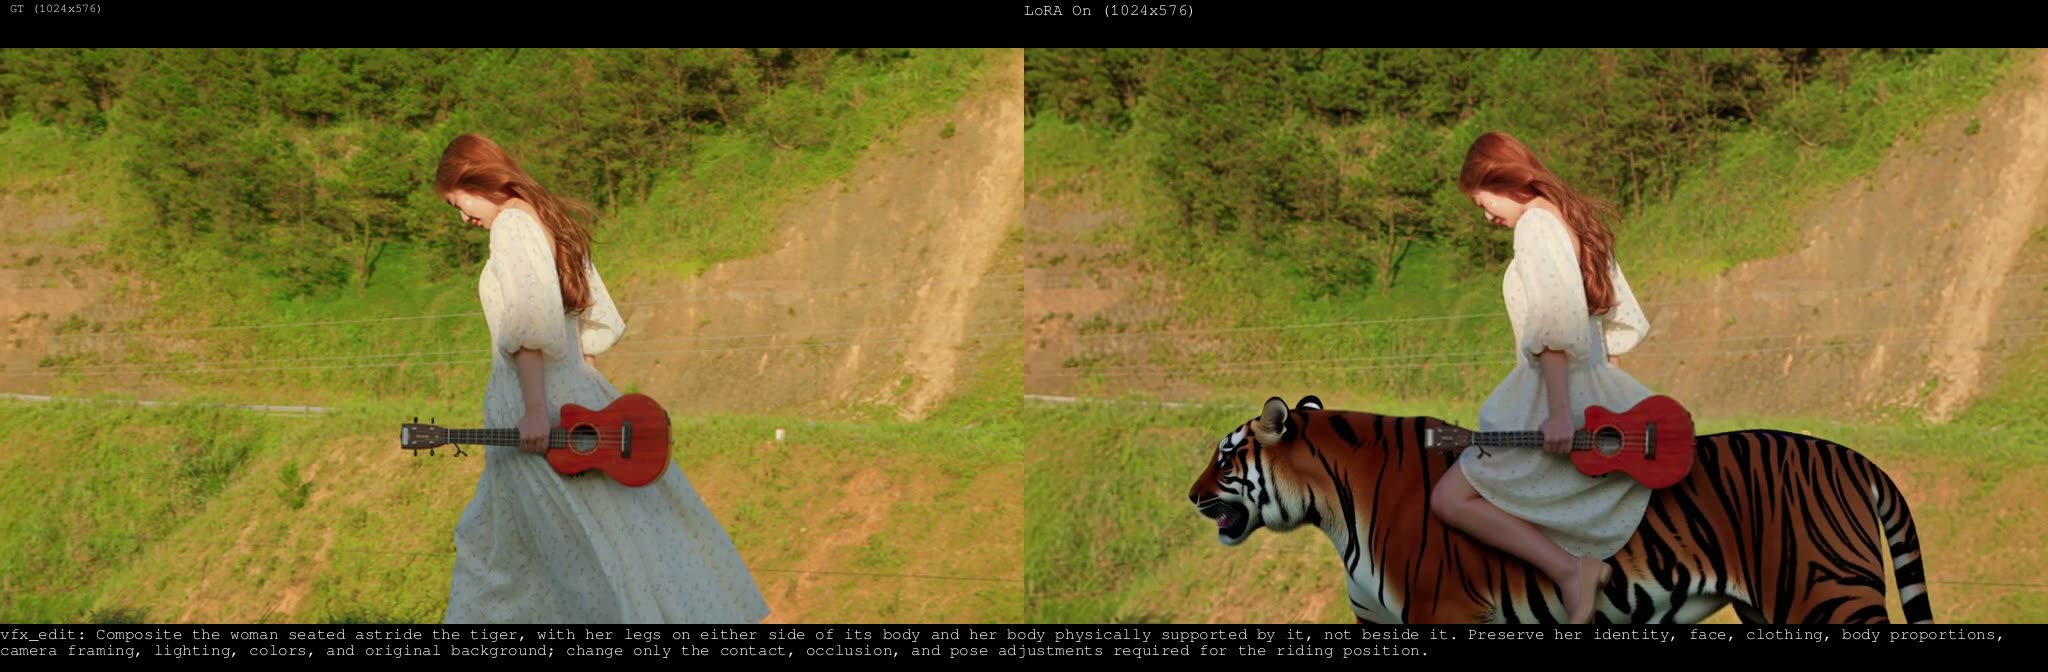 | 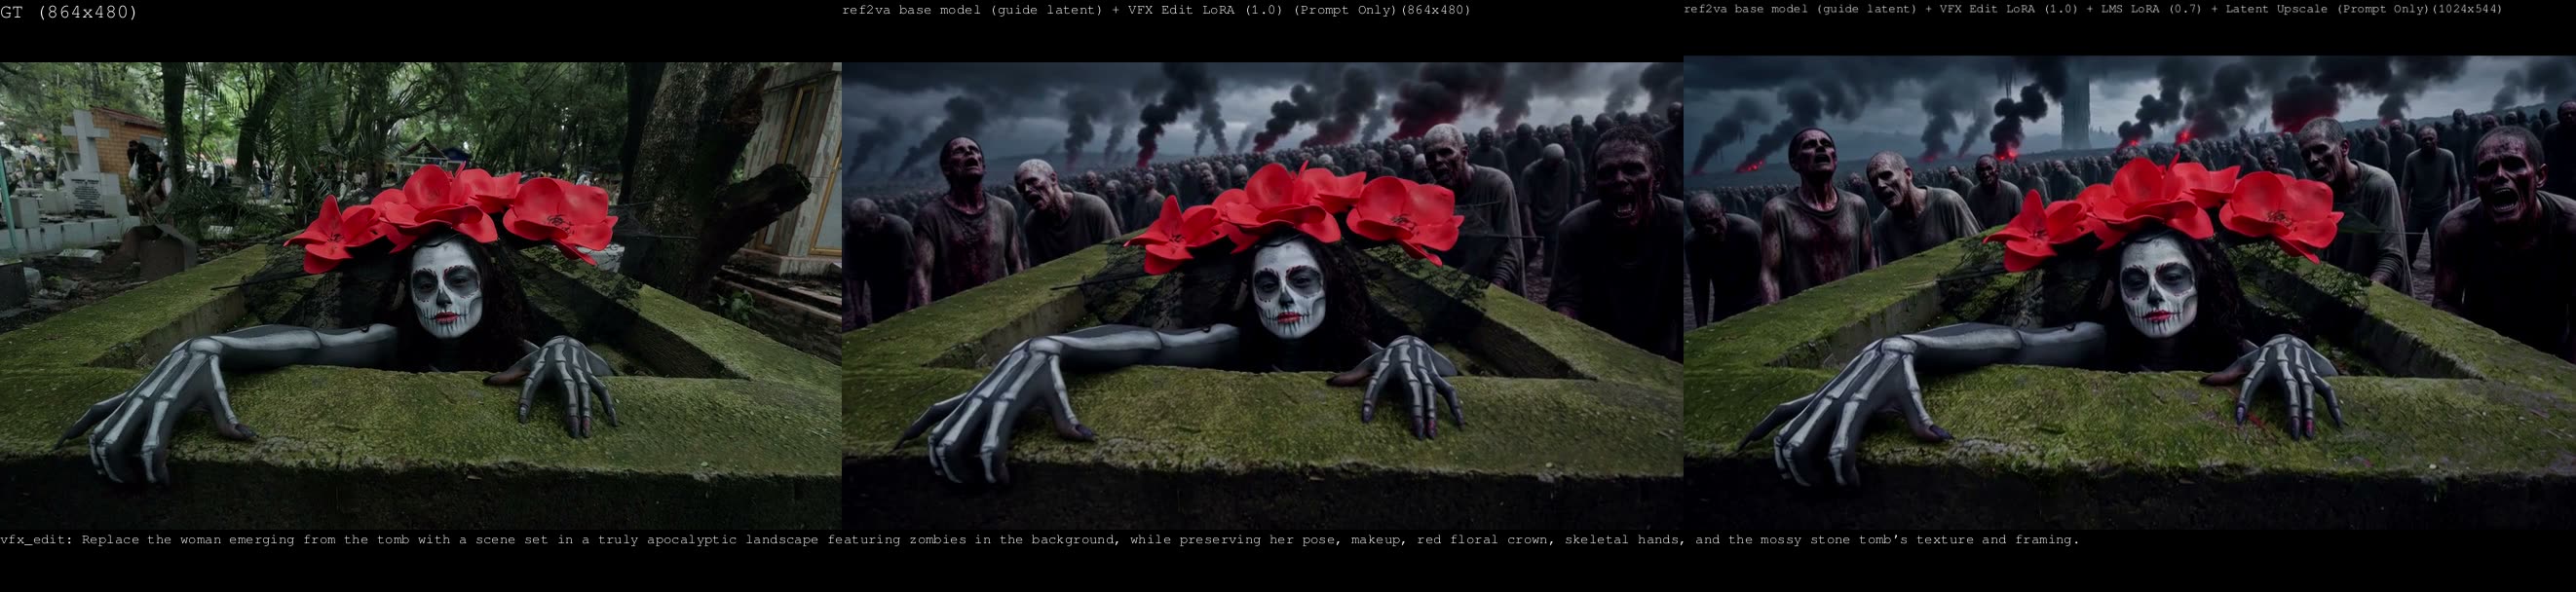 |
|---|---|
| Clips d'exemple de VFX Edit issus du référentiel | Un deuxième exemple de VFX Edit |
Style Transfer et Head Swap
Style Transfer restyle un clip entier tout en s'efforçant de conserver le mouvement, le cadrage et le rythme intacts. La vidéo source est placée dans MiniMaxH3AddGuide et l'image de style dans le canal de référence natif en tant que <Picture 1>, à une force de 1.0, réduite à environ 0.7 si le style commence à supplanter le mouvement original. Les prompts de style uniquement textuels fonctionnent pour des rendus que le modèle de base connaît déjà. La documentation déconseille de nommer un artiste en même temps qu'une image de référence, car le texte peut prendre le dessus sur l'image.
Head Swap est marqué comme expérimental et emprunte les deux chemins de conditionnement avec des rôles différents : le visage de remplacement passe par le canal de référence natif en tant que <Picture 1> / <Subject 1>, tandis que la vidéo de base complète passe par MiniMaxH3AddGuide à frame_idx = 0 en tant que <Video 1>. La vidéo de base ne doit pas être acheminée via le canal de référence vidéo natif. La documentation comporte également un avertissement explicite d'usage responsable : recherche et usage créatif uniquement, aucune usurpation d'identité, fraude ou tromperie.
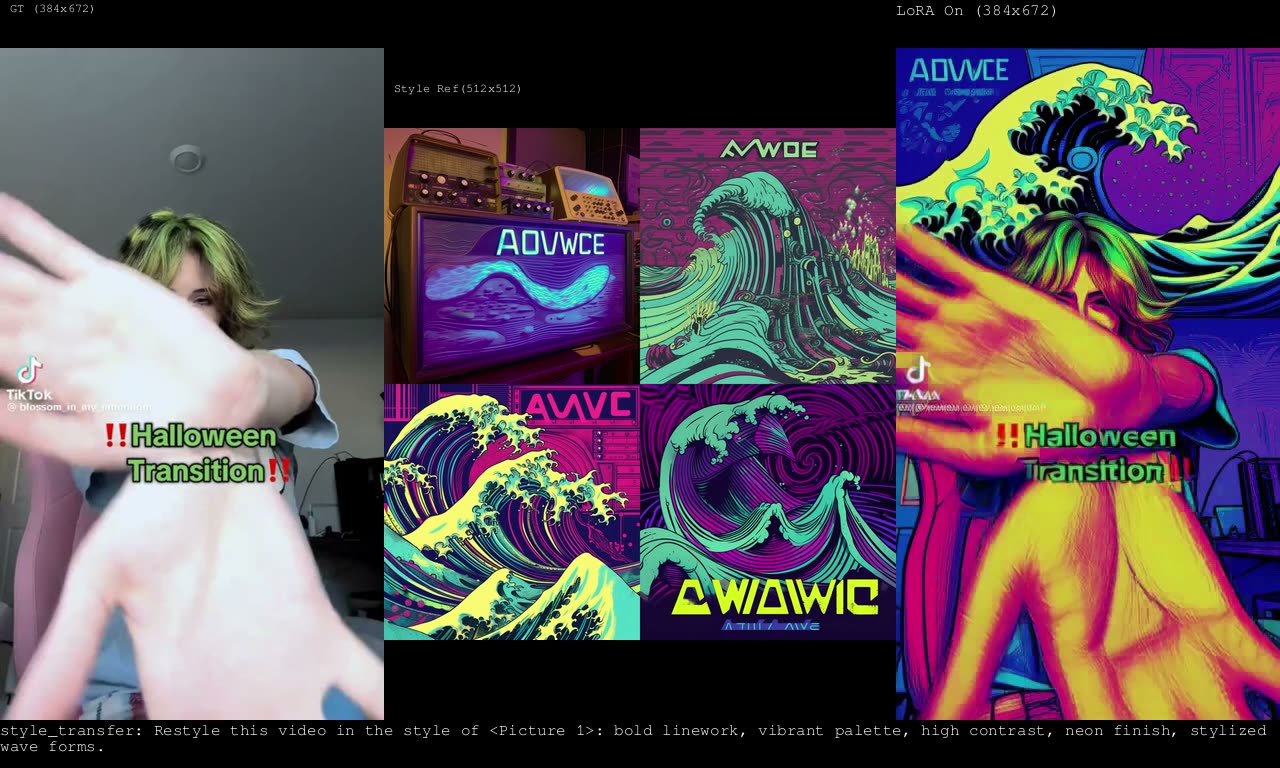
Un exemple de Style Transfer issu du référentiel
Expérience d'upscaler latent
Le pack documente aussi un checkpoint d'upscaler latent expérimental, h3_upscaler_lms_v0.1, parti de l'upscaler latent LBH-123-AI et affiné pendant 2 000 étapes sur le même jeu de données de netteté que celui utilisé pour le LoRA LMS. Les mêmes poids sont publiés deux fois, sous latent_upscaler/ et experiments/, et le guide indique clairement qu'aucune vidéo d'exemple ni flux de travail dédié n'a encore été mis en ligne pour lui.
Disponibilité
Téléchargez les LoRA depuis le référentiel, placez-les dans ComfyUI/models/loras/ et chargez le flux de travail correspondant depuis le dossier workflows/ : chacun liste les modèles dont il a besoin. Le chemin de conditionnement du LoRA utilise les nœuds MiniMax H3 de base (y compris MiniMaxH3AddGuide), mais les workflows d'exemple fournis chargent aussi la vidéo, redimensionnent les images et exécutent l'upscaler latent via des packs de nœuds tiers, donc installez ce que les notes de chaque workflow signalent comme manquant.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.