Viggle Meridian : re-caméra par géométrie dans ComfyUI
Viggle Meridian ajoute une re-caméra guidée par la géométrie à MiniMax H3 : un clip et un trajet de caméra donnent un nouveau point de vue. Deux LoRA, deux nœuds, graphes prêts.
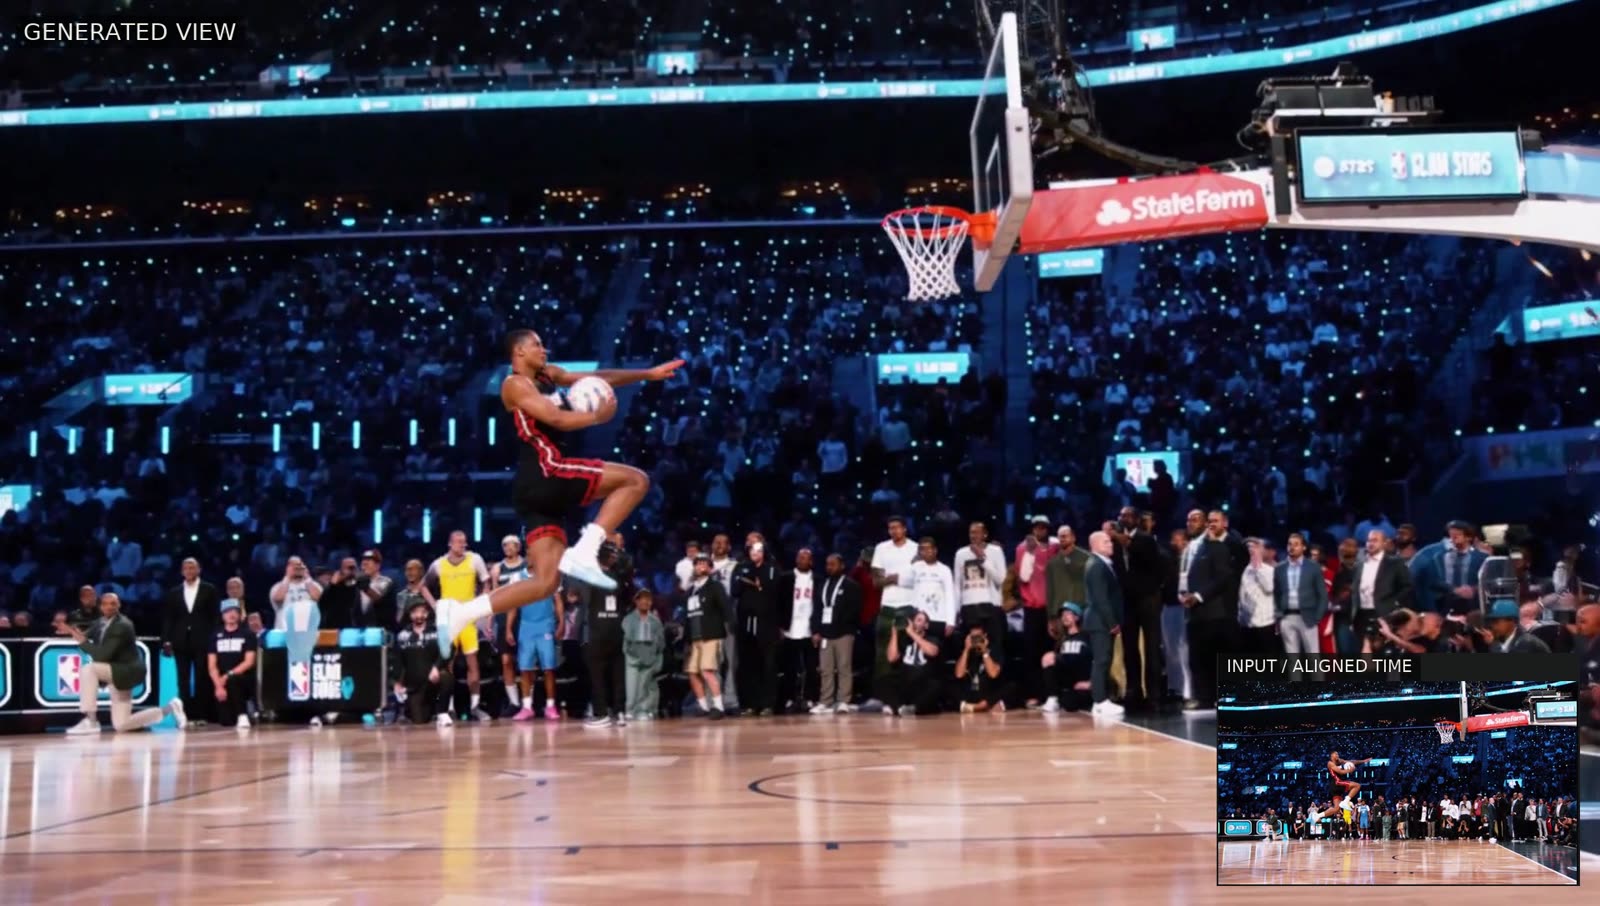
Un dunk vu sous de nouveaux angles. Le montage mélange des vues générées avec des images tirées de la séquence d'origine.
Comment ça fonctionne
Meridian scinde la tâche entre géométrie et génération plutôt que de demander à un modèle vidéo d'imaginer un mouvement de caméra à partir de rien :
- Construire la géométrie. VGGT-Omega estime la profondeur et les poses de caméra à partir de la vidéo d'entrée, et les images sélectionnées deviennent des points 3D colorés.
- Rendre la nouvelle vue. Pour chaque image de sortie, un moment de l'entrée est associé à un point de vue de caméra choisi, et les points sont rendus depuis cet angle. Les régions que la caméra d'origine n'a jamais vues apparaissent sous forme de trous gris.
- Générer le plan. La vidéo source et la vidéo rendue correspondante sont toutes deux fournies à Meridian comme références, ce qui comble les trous et affine le résultat.
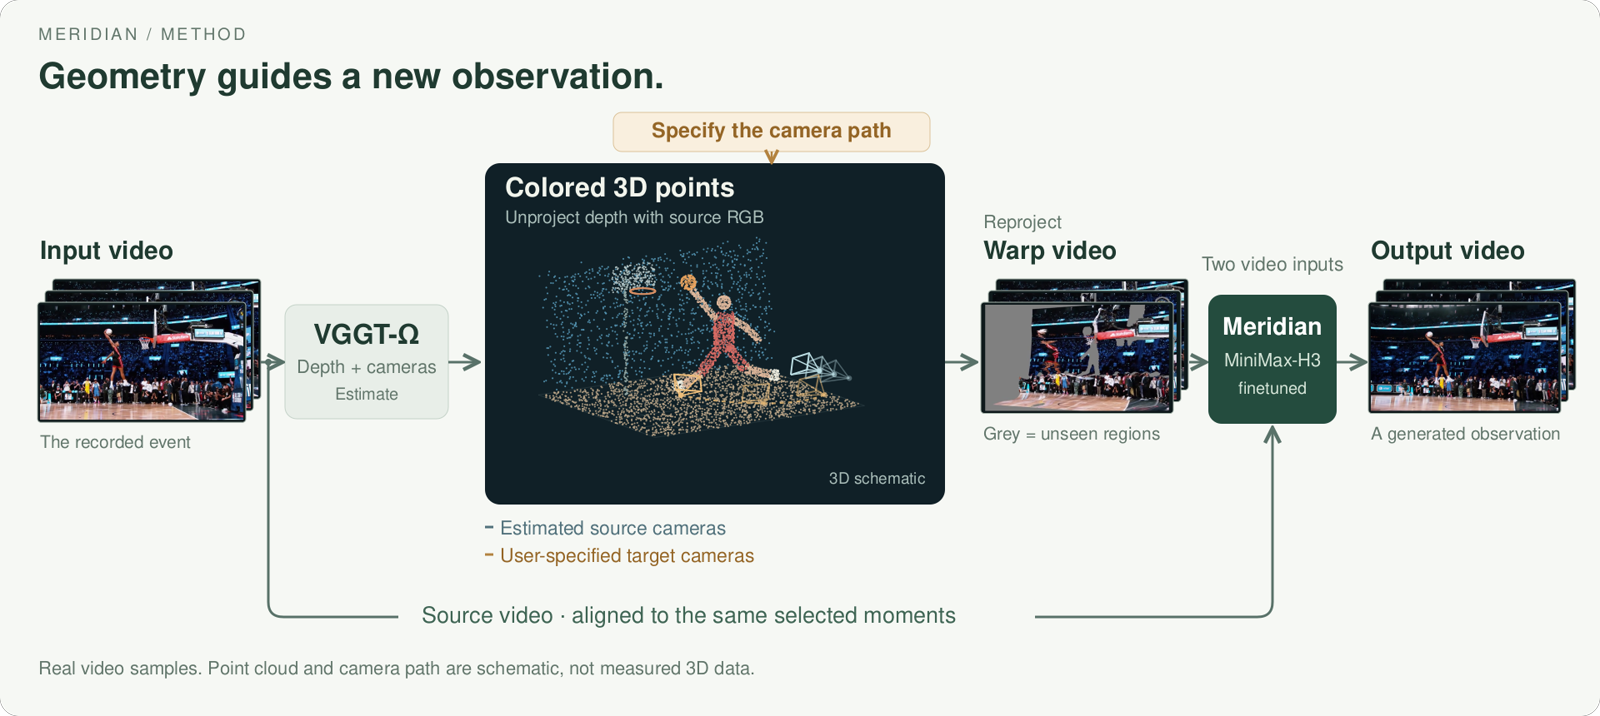
Profondeur et poses de caméra issues de VGGT-Omega, rendues le long d'un chemin choisi. Les images sont réelles ; les points et les caméras sont schématiques.
Comme le rendu géométrique est peu coûteux une fois les points créés, le cadrage peut être prévisualisé, les manques repérés et le chemin ajusté avant de lancer le modèle vidéo. L'espace et le temps sont contrôlés séparément : choisissez d'où regarder, choisissez quand regarder, et décidez comment les deux se rejoignent, ce qui rend possibles les mouvements de type bullet-time sans que ce soit le seul tour que le modèle sait faire.
Deux LoRA, aucun checkpoint fusionné
Meridian utilise le transformer et le VAE de MiniMax H3 sans charger d'encodeur de texte à l'inférence : les embeddings de texte de la tâche sont précalculés, et l'architecture du transformer reste inchangée.
| Composant | Rôle |
|---|---|
teacher_lora/ | L'adaptateur de re-camera qui lit un rendu géométrique. 2,5 GiB, sa propre grille est --steps 50 --flow-shift 12 |
turbo_lora/ | Une distillation du teacher en 3 passes avant. 2,5 GiB, par défaut --steps 4 --flow-shift 3 |
legacy/ | La première version : un transformer fusionné de 61,7 GiB plus son adaptateur, conservé pour la reproductibilité |
Les deux adaptateurs se chargent ensemble et aucun des deux ne doit être fusionné dans les poids de base. L'exécution par défaut les additionne à un poids de 1.0, ce qui correspond à la combinaison sur laquelle le turbo a été distillé : la fusion est avec perte en bf16 et, pour le turbo, elle efface pratiquement toute la mise à jour.
L'utiliser dans ComfyUI
Viggle publie les deux adaptateurs au format LoRA générique de ComfyUI sous comfyui/, à côté de deux fichiers de nœuds personnalisés et de deux graphiques au format API. Déposez l'un des graphiques sur la toile et le frontend le construit.
- Chargez
minimax_h3_fl2va_bf16.safetensorsdepuis Comfy-Org/MiniMax-H3. Meridian est entraîné sur la partitionfl2vade H3, le fichierref2vaest donc la mauvaise base. - Appliquez
comfyui/meridian_teacher_lora.safetensorspuiscomfyui/meridian_turbo_lora.safetensors, les deux à une force de 1.0. - Échantillonnez avec
eulersur le planificateursimpleàcfg1.0. Il n'y a pas de branche négative, donc connectez le même conditionnement aux deux entrées. - Le paramètre
stepsde ComfyUI vaut un de moins que le--stepsdu référentiel, car ses planificateurs ajoutent le zéro final : la paire turbo correspond àMiniMaxH3SigmaShift3.0 avecsteps3, et le teacher seul à un shift de 12.0 avecsteps49.
La sortie est en 24 fps sur une toile de classe 768 au format correspondant : 1344x768 pour une entrée 16:9. Les longueurs valides sont 73, 90, 107, 124, 141, 158, 175 ou 243 images, soit environ 3 à 10 secondes par prise. Le CLI lit les images par index, la séquence source doit donc être un plan continu exporté à 24 fps constants ; il ne normalisera pas la fréquence d'images et ne détectera pas les coupes.
Exemples
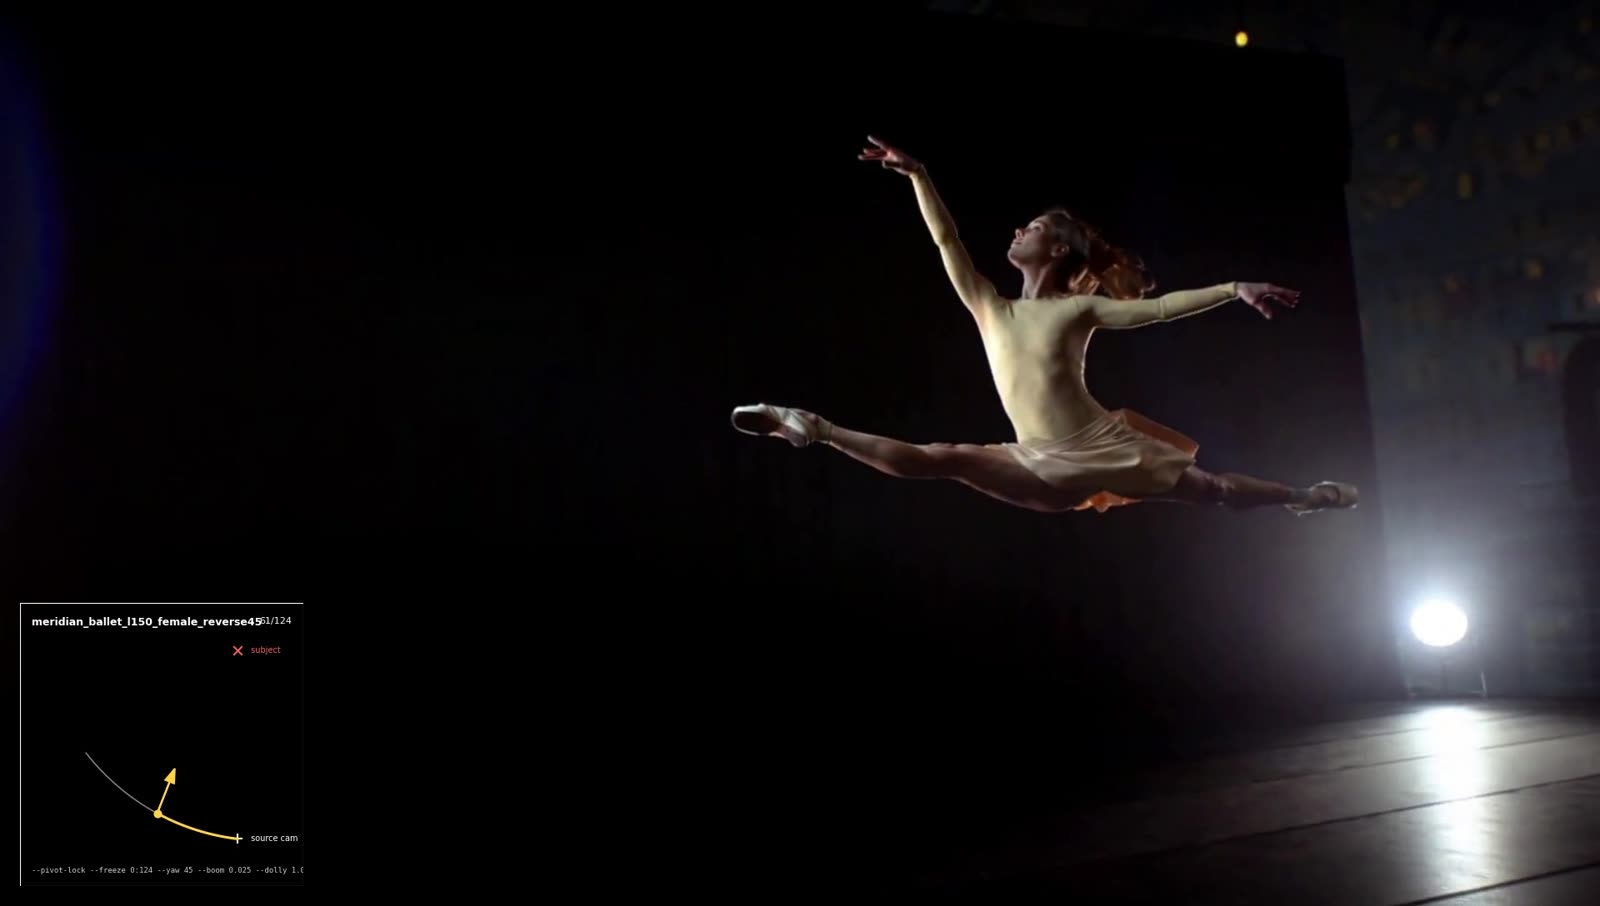
Un mouvement de caméra créé à partir d'une seule photographie fixe.
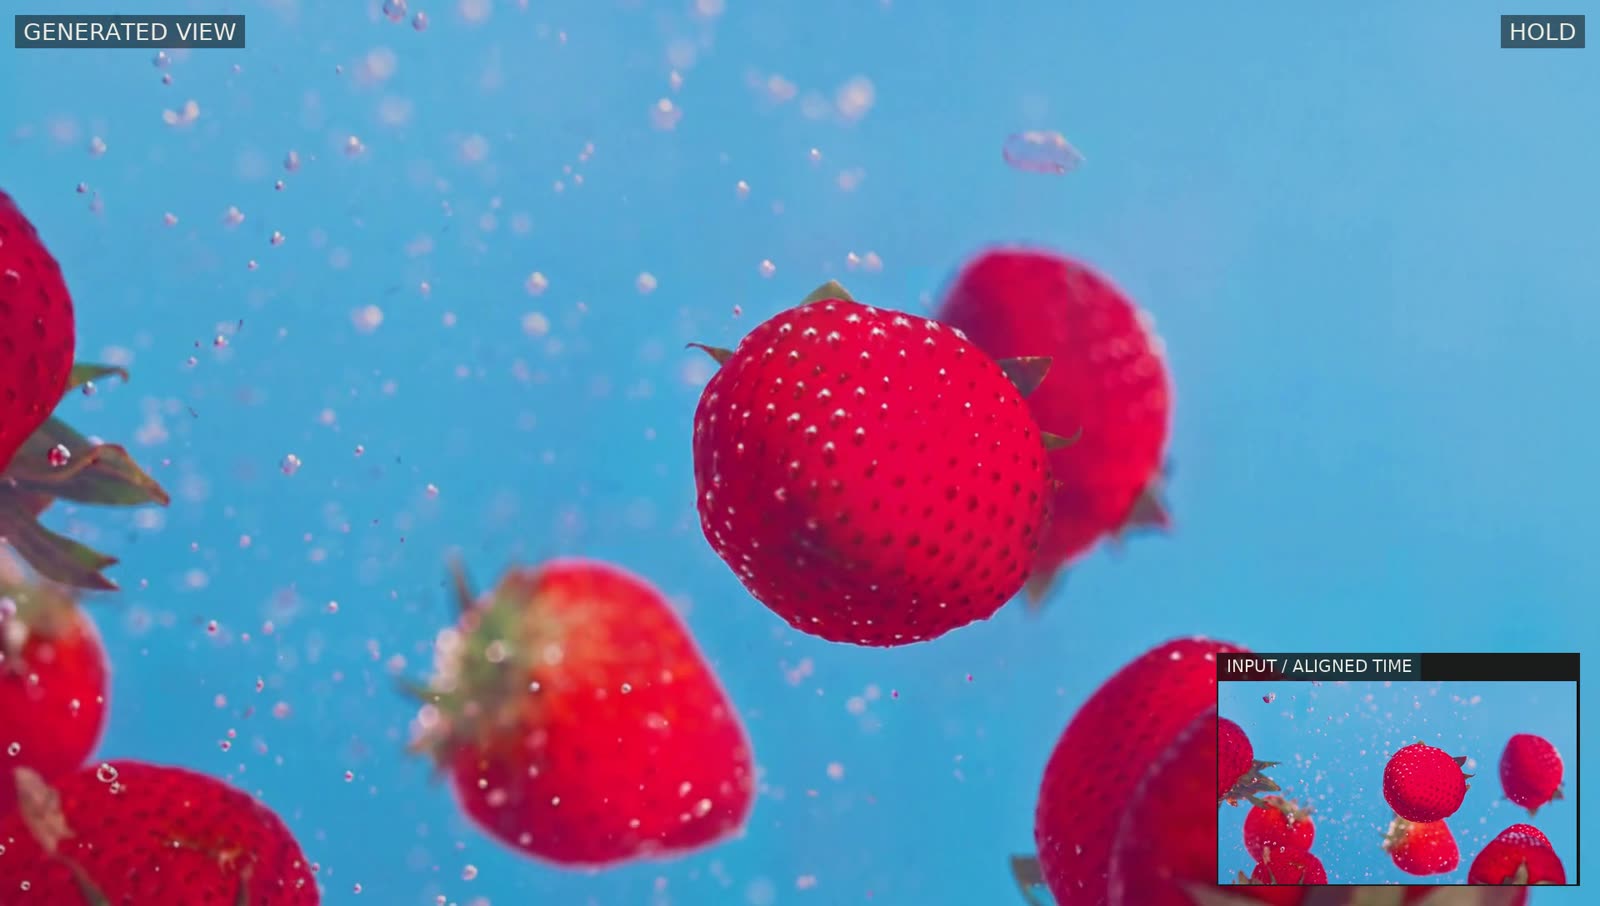
Le temps de la source avance, se met en pause pendant que la caméra bouge, puis reprend.
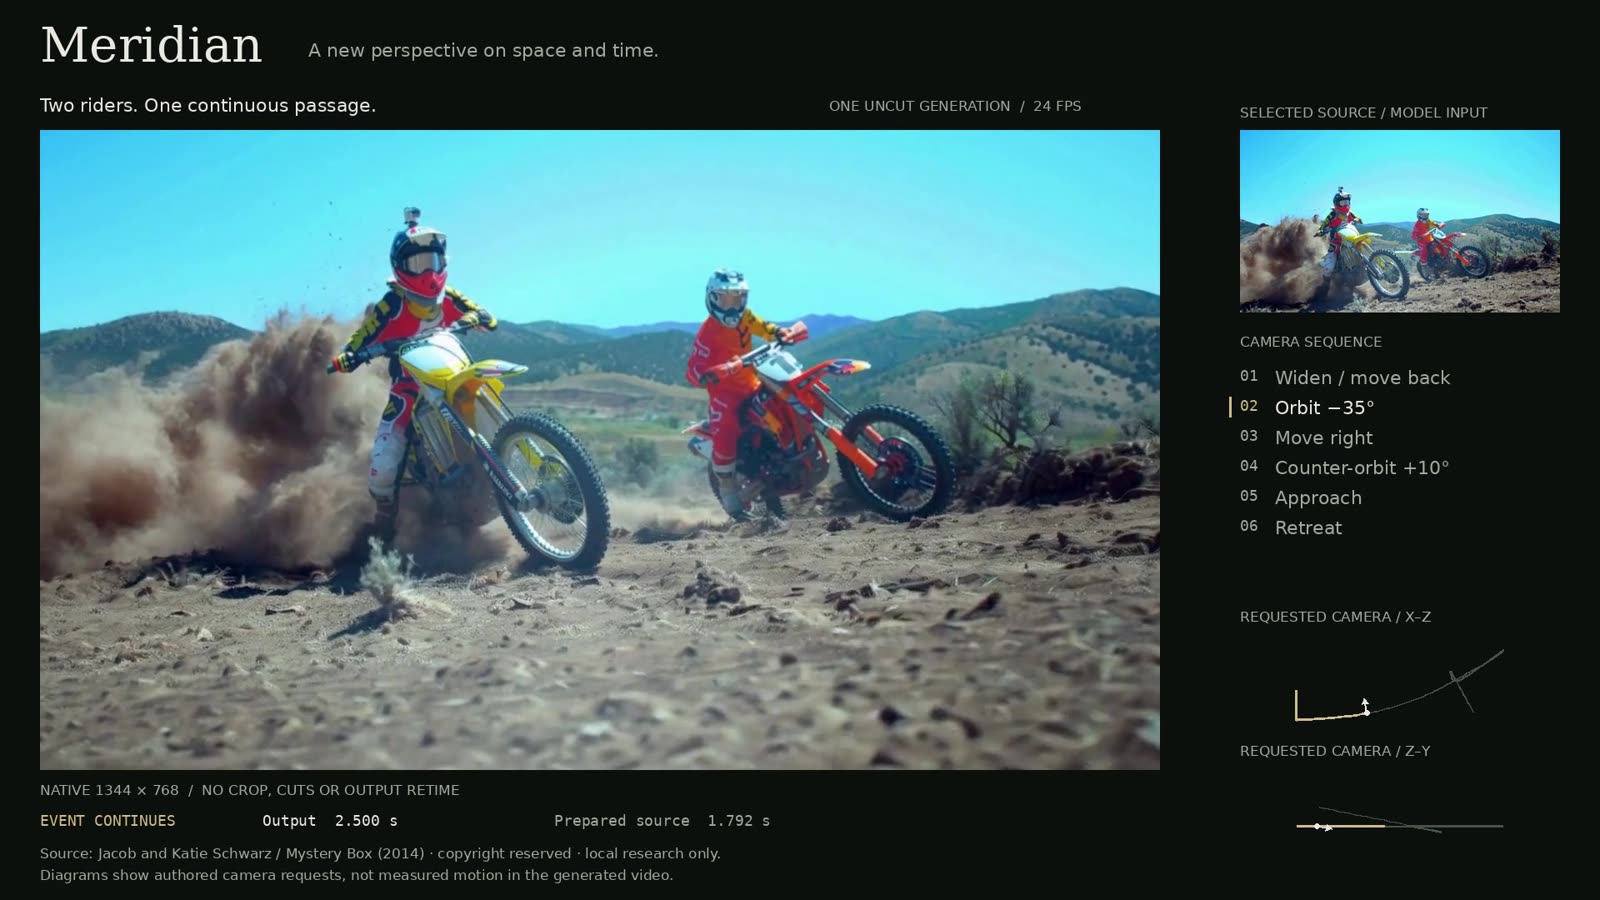
Orbitez, déplacez-vous latéralement et changez la distance dans un seul plan continu.
Exigences et limites
L'implémentation de référence tourne sur un seul GPU CUDA à grande mémoire et n'expose actuellement ni quantification, ni déchargement CPU, ni répartition multi-GPU, ce qui met pour l'instant les cartes grand public hors de portée. Viggle invite explicitement la communauté à porter Meridian sur des GPU plus petits comme la RTX 4090, en notant que conserver l'architecture de H3 et supprimer l'encodeur de texte constitue un bon point de départ pour un travail d'économie de mémoire. Le modèle de géométrie VGGT-Omega s'obtient séparément via son propre référentiel et n'est pas fourni avec les adaptateurs.
Disponibilité
Les poids, les adaptateurs, les nœuds ComfyUI, les graphiques et le CLI d'inférence sont sur Hugging Face. Le référentiel inclut également des clips d'exemple et un Studio prototype pour concevoir des chemins de caméra avec des commentaires 3D en temps réel avant de lancer une génération.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.