Supra2-IMG: un modèle texte-image de 100M entraîné en 10 heures
SupraLabs publie Supra2-IMG, un modèle texte-image DiT de 105M de paramètres entraîné de zéro en 10 heures sur un seul H100, avec des exemples en 256x256.
La bannière officielle Supra2-IMG issue du dépôt du modèle.
De quoi s'agit-il
Supra2-IMG est un DiT minuscule : 104,1M de paramètres générant des images 256x256 à partir de 128 tokens de contexte Flan-T5. Le conditionnement texte provient d'un encodeur Flan-T5-Base gelé et les latents sont décodés par SD-VAE-FT-MSE, ces deux composants sont donc récupérés depuis leurs propres dépôts plutôt que fournis dans le checkpoint.
| Composant | Valeur |
|---|---|
| Paramètres | 104,1M (D_MODEL 576, profondeur 14, 9 têtes, dimension de tête 64, ratio MLP 4.0) |
| Résolution | 256x256 (latent 32x32, taille de patch 2) |
| Encodeur de texte | Flan-T5-Base, gelé, contexte de 128 tokens |
| VAE | SD-VAE-FT-MSE |
| Checkpoint | model_final_ema.pt |
SupraLabs est le laboratoire indépendant derrière les modèles de langage Supra2 de 100M de paramètres, et Supra2-IMG applique la même approche « entraîner petit, entraîner de zéro » à la génération d'images. Le modèle est publié sous forme de code PyTorch brut accompagné des poids : inference.py, config.json et model_final_ema.pt.
Entraînement
L'exécution est volontairement modeste, c'est tout l'intérêt de cette publication :
- Jeu de données : 10 époques sur l'intégralité du jeu de données LucasFang/FLUX-Reason-6M, soit 5,6M d'images après préparation.
- Sélection des légendes : chaque image prend la première légende disponible dans la chaîne
caption_compositionpuiscaption_entitypuiscaption_textpuiscaption_stylepuiscaption_imaginative, en conservant l'annotation de la plus haute qualité pour chaque échantillon. - Matériel : un Nvidia H100 SXM 80GB sur RunPod, 9 heures préparation des données comprise, sur un disque de 2,5 To.
Comme le modèle entier tient dans quelques centaines de mégaoctets, il constitue une base pratique pour étudier le pré-entraînement à petite échelle et pour des expériences de fine-tuning qui seraient bien trop coûteuses à l'échelle 8B.
Exemples
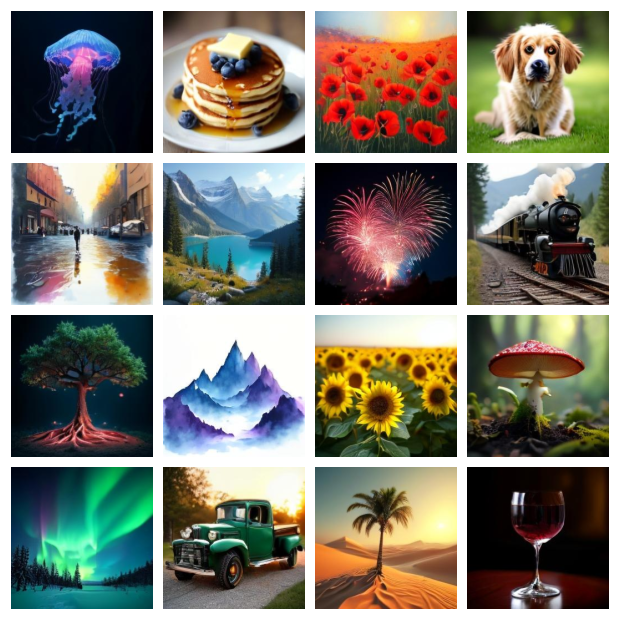
Exemples officiels du dépôt du modèle, tous aux paramètres recommandés plutôt que des exécutions triées sur le volet.
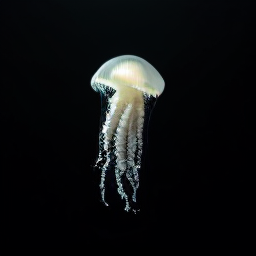
Exemple de sortie 256x256 produite par le script d'inférence fourni.
Disponibilité
Il n'y a aucun support ComfyUI : Supra2-IMG est une simple publication PyTorch dotée d'une architecture SupraDiT personnalisée, ce n'est donc pas un pipeline diffusers et aucun template ni nœud ComfyUI n'est publié. Pour l'exécuter, il faut le script fourni ainsi que les deux composants externes :
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" \
  --seed 0 --cfg 3.0 --steps 50 --n 1 --out jellyfish.png
Les paramètres d'échantillonnage recommandés sont la graine 0, CFG 3.0 et 50 étapes.
- Poids et code : SupraLabs/Supra2-IMG
- Encodeur de texte : google/flan-t5-base
- VAE : stabilityai/sd-vae-ft-mse
- Laboratoire : supra-labs.com
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.