Qwen-Image 2.1 : modèle T2I et d'édition 7B dans ComfyUI
Qwen-Image 2.1 est le modèle d'image 7B d'Alibaba : transparence RGBA native, édition depuis 10 images de référence et prise en charge de ComfyUI dès le jour 0.
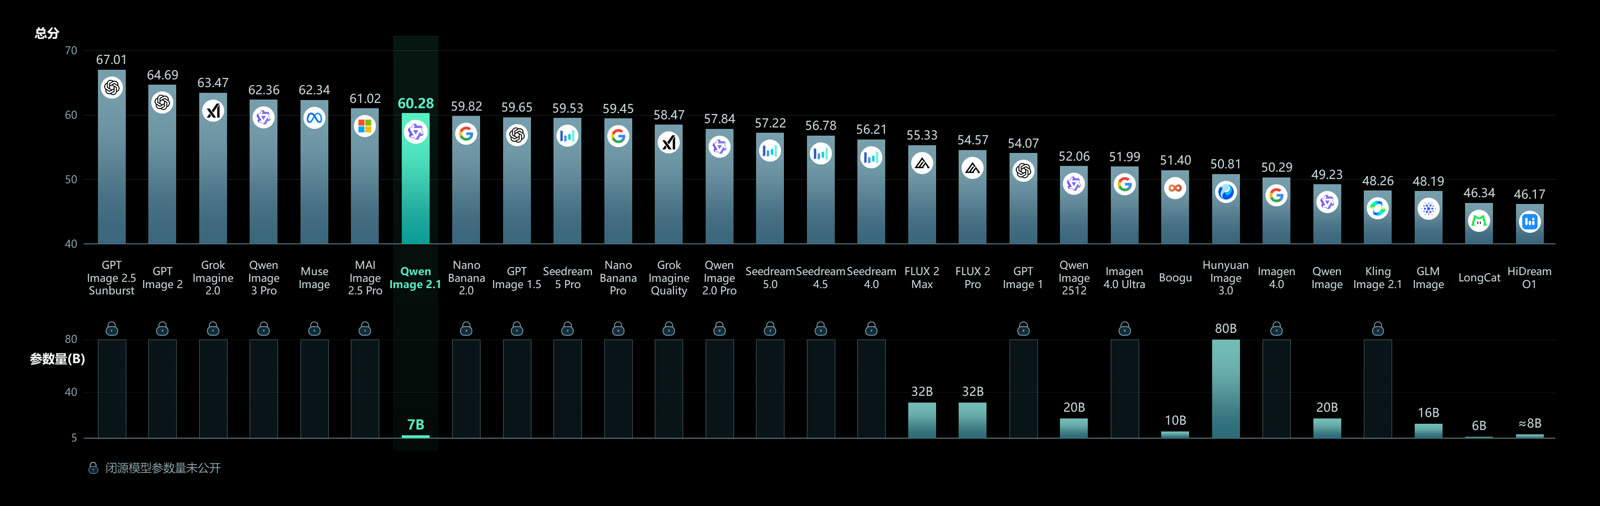
Exemples issus de la carte du modèle officiel Qwen-Image 2.1.
Ce qui est nouveau dans Qwen-Image 2.1
La génération précédente de Qwen-Image utilisait un backbone MMDiT de 20B avec un encodeur de texte Qwen2.5-VL-7B. Qwen-Image 2.1 remplace la partie génération visuelle par un composant de 7B composé de 32 couches DiT single-stream, et les quatre changements phares sont les suivants :
- Compact et efficace. L'attention à granularité mixte et la réutilisation du cache KV de préfixe maintiennent une qualité élevée pour un coût de calcul bien inférieur à celui de la gamme 20B.
- Transparence native, génération et édition unifiées. Un seul modèle écrit des images normales ou transparentes (RGBA) à partir de texte, édite des calques transparents et extrait des sujets de photographies.
- Édition polyvalente. Jusqu'à 10 images de référence par requête, des éditions locales désignées par des cercles, des annotations peintes ou un masque séparé, et la préservation de l'identité des personnes et des produits.
- Textures réalistes et esthétique raffinée. Meilleure typographie, meilleur éclairage de portrait et détails fins.
Les tailles de sortie natives sont plus larges que le carré de la classe 1024 utilisé par les flux de travail antérieurs : 2048x2048 en 1:1, 2400x1792 en 4:3, 2528x1696 en 3:2 et 2752x1536 en 16:9, avec les ratios portrait correspondants.
Des images transparentes avec un véritable canal alpha
La fonctionnalité phare est un alpha qui survit jusqu'au fichier. Au lieu de générer sur un fond plat puis de détourer le sujet avec un modèle de matting séparé, Qwen-Image 2.1 écrit lui-même la transparence : un sticker, un rendu produit ou une ressource d'interface sort prêt à être composé. La carte du modèle recommande un format de prompt explicite pour la déclencher :
This is an RGBA image with transparency. <your subject description>.
The image has alpha channel and the background is transparent.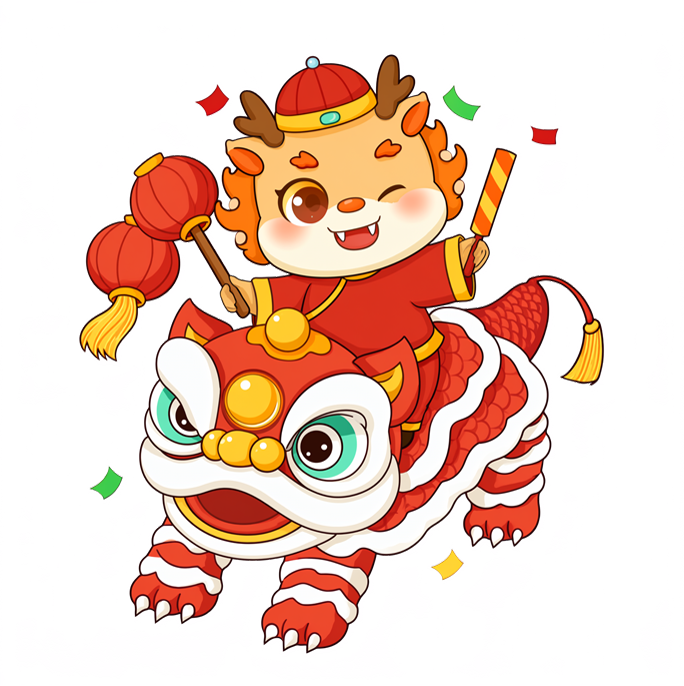
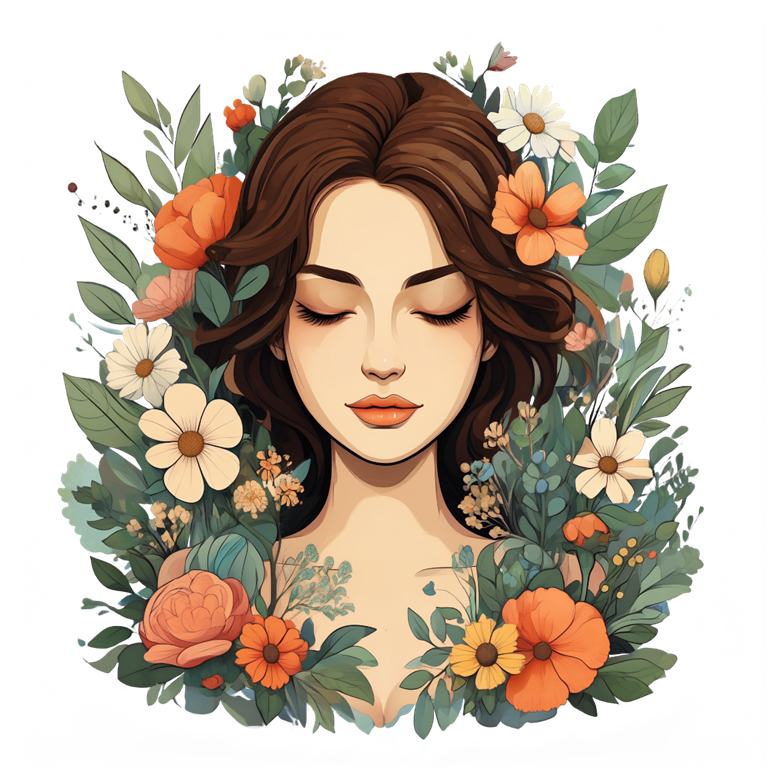
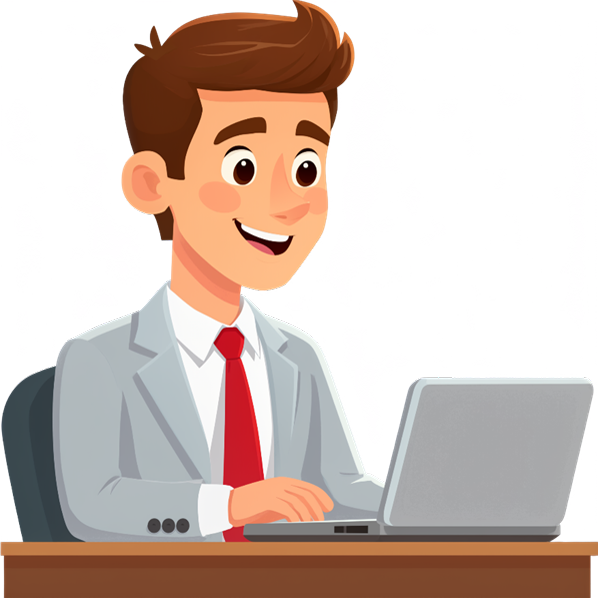
Génération d'images transparentes natives, directement issue de la vitrine officielle. Les fichiers portent un canal alpha, et non un damier peint.
Édition à partir de jusqu'à dix références
C'est en édition que le budget de références compte. Qwen-Image 2.1 accepte jusqu'à dix images en une seule passe, ce qui rend possibles les compositions de groupe, les scènes multi-produits et les planches de personnages sans assembler des générations séparées. Les éditions locales peuvent être ciblées avec un cercle, une annotation peinte ou un nœud de masque.
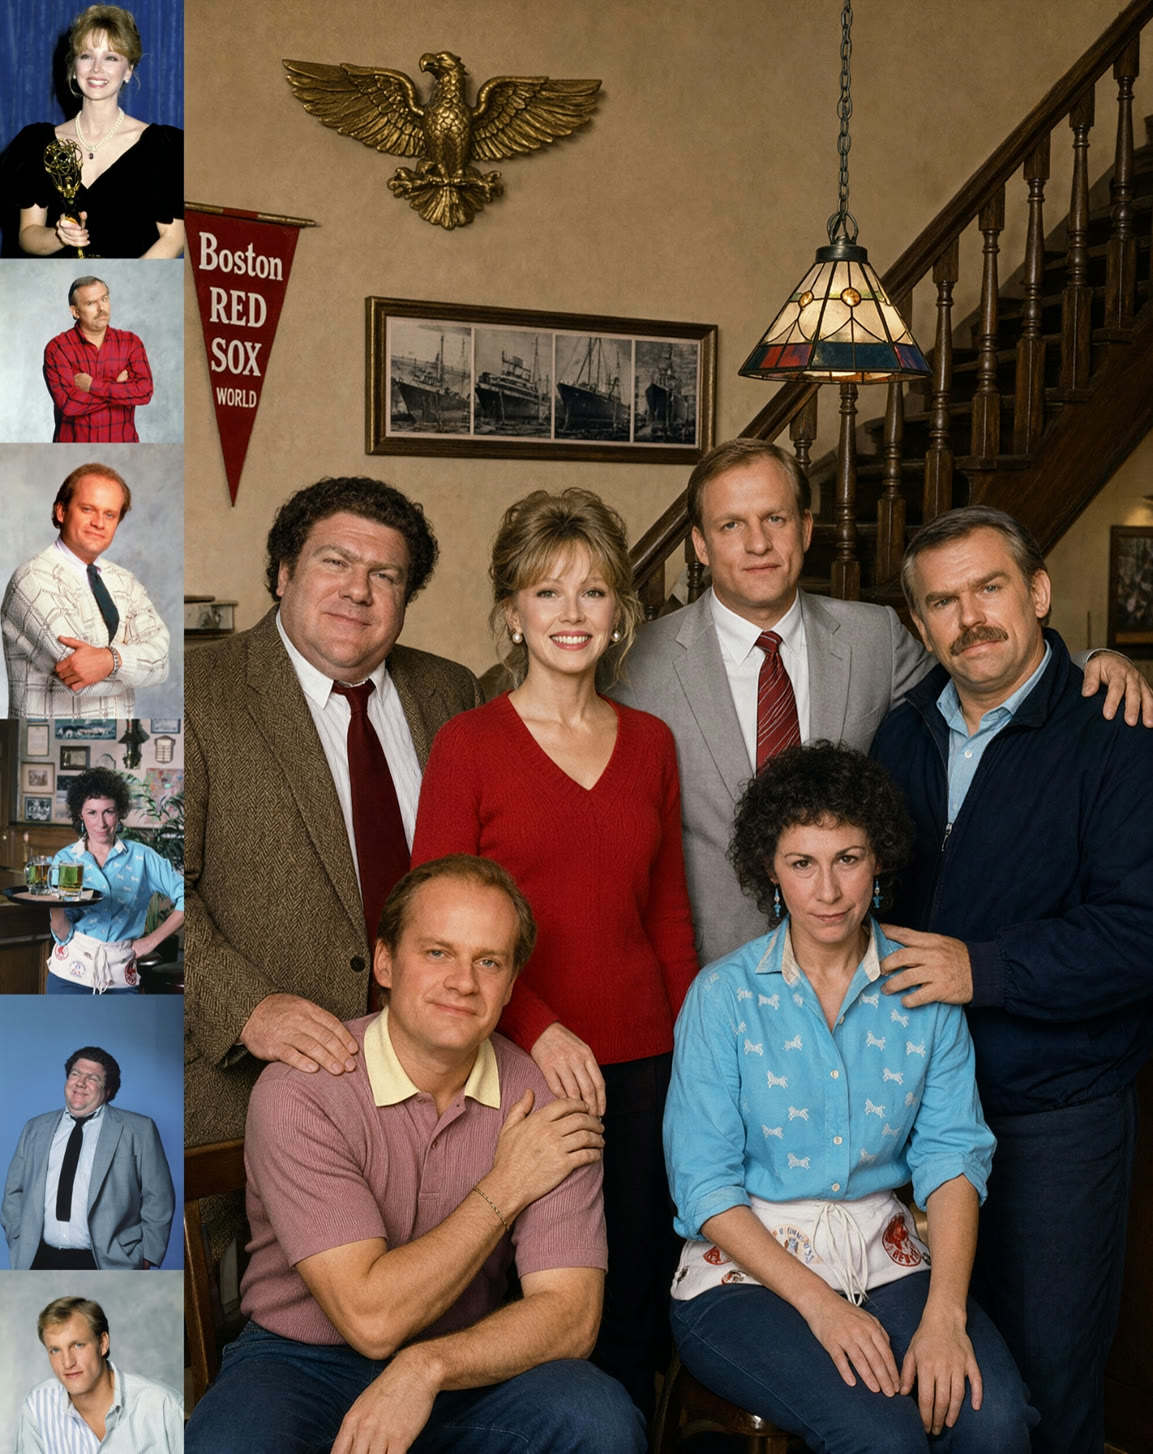
Une photographie de groupe générée à partir de six références de portrait.
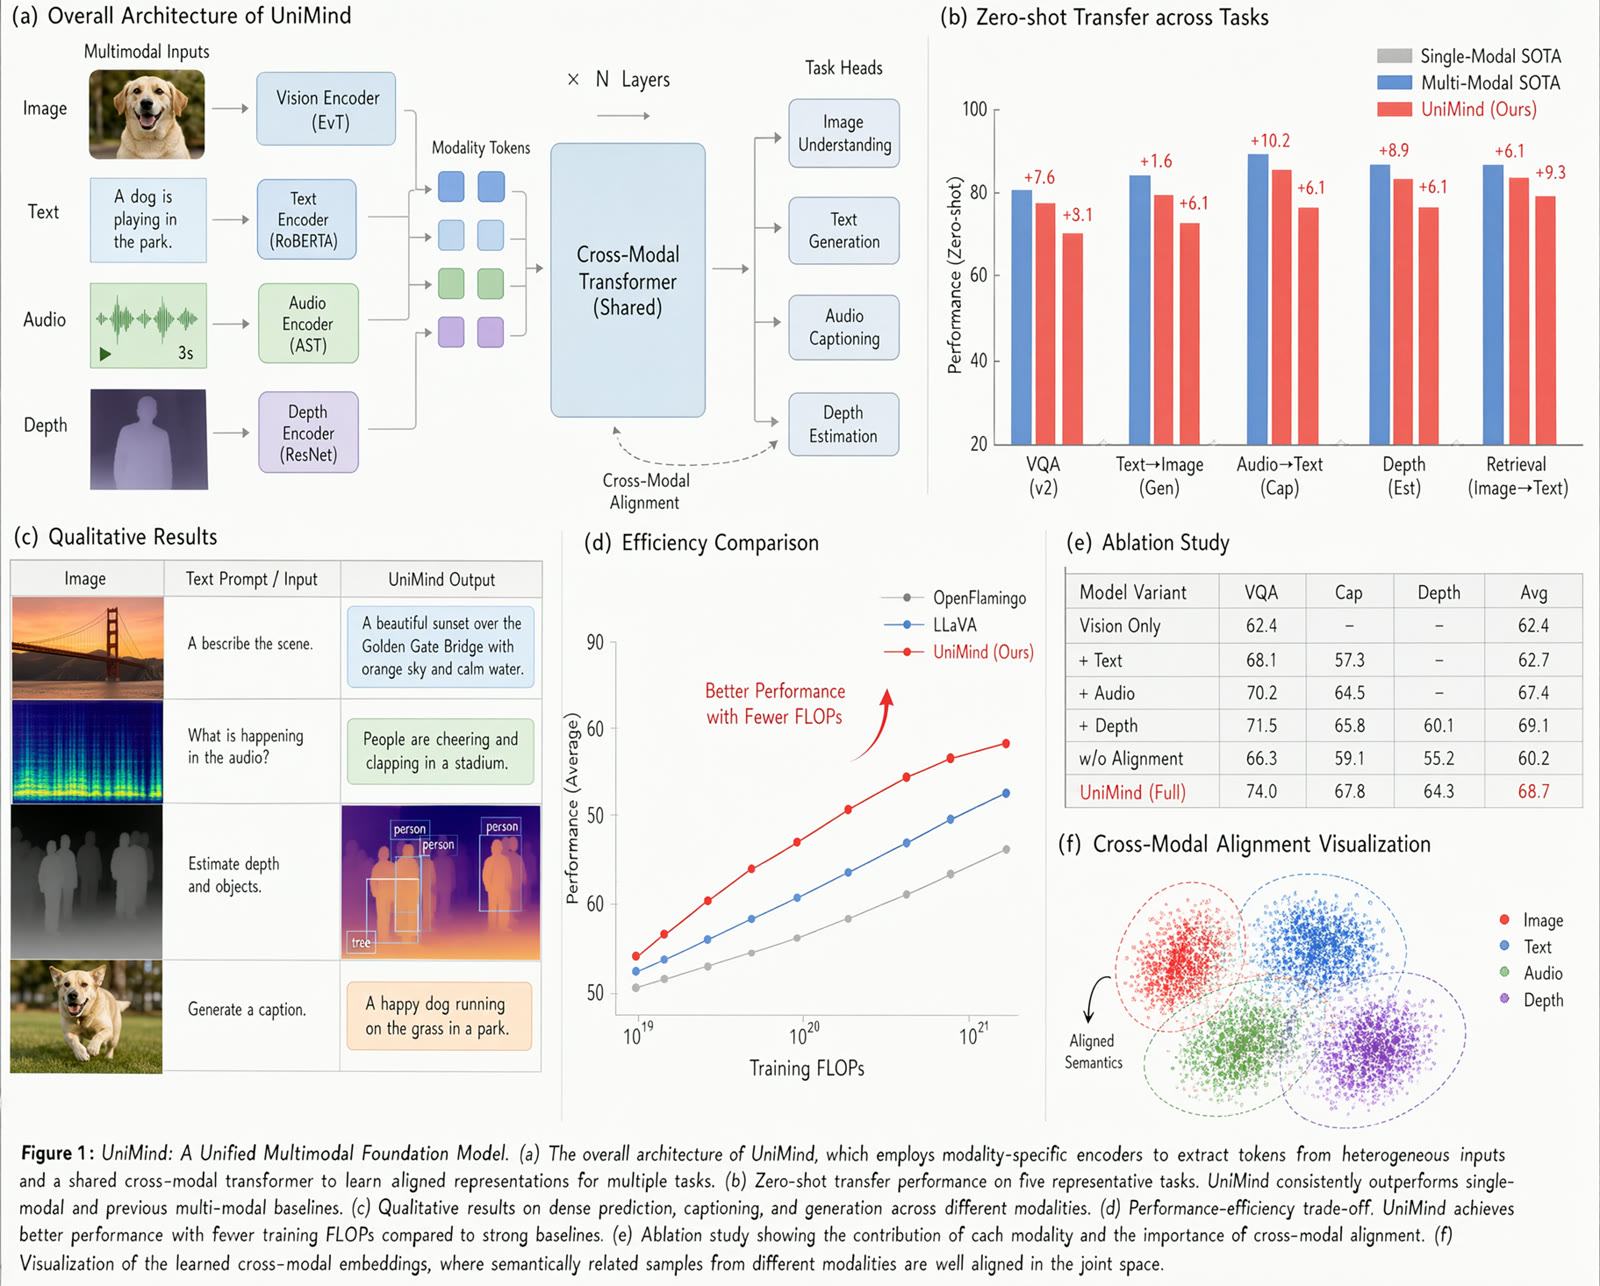
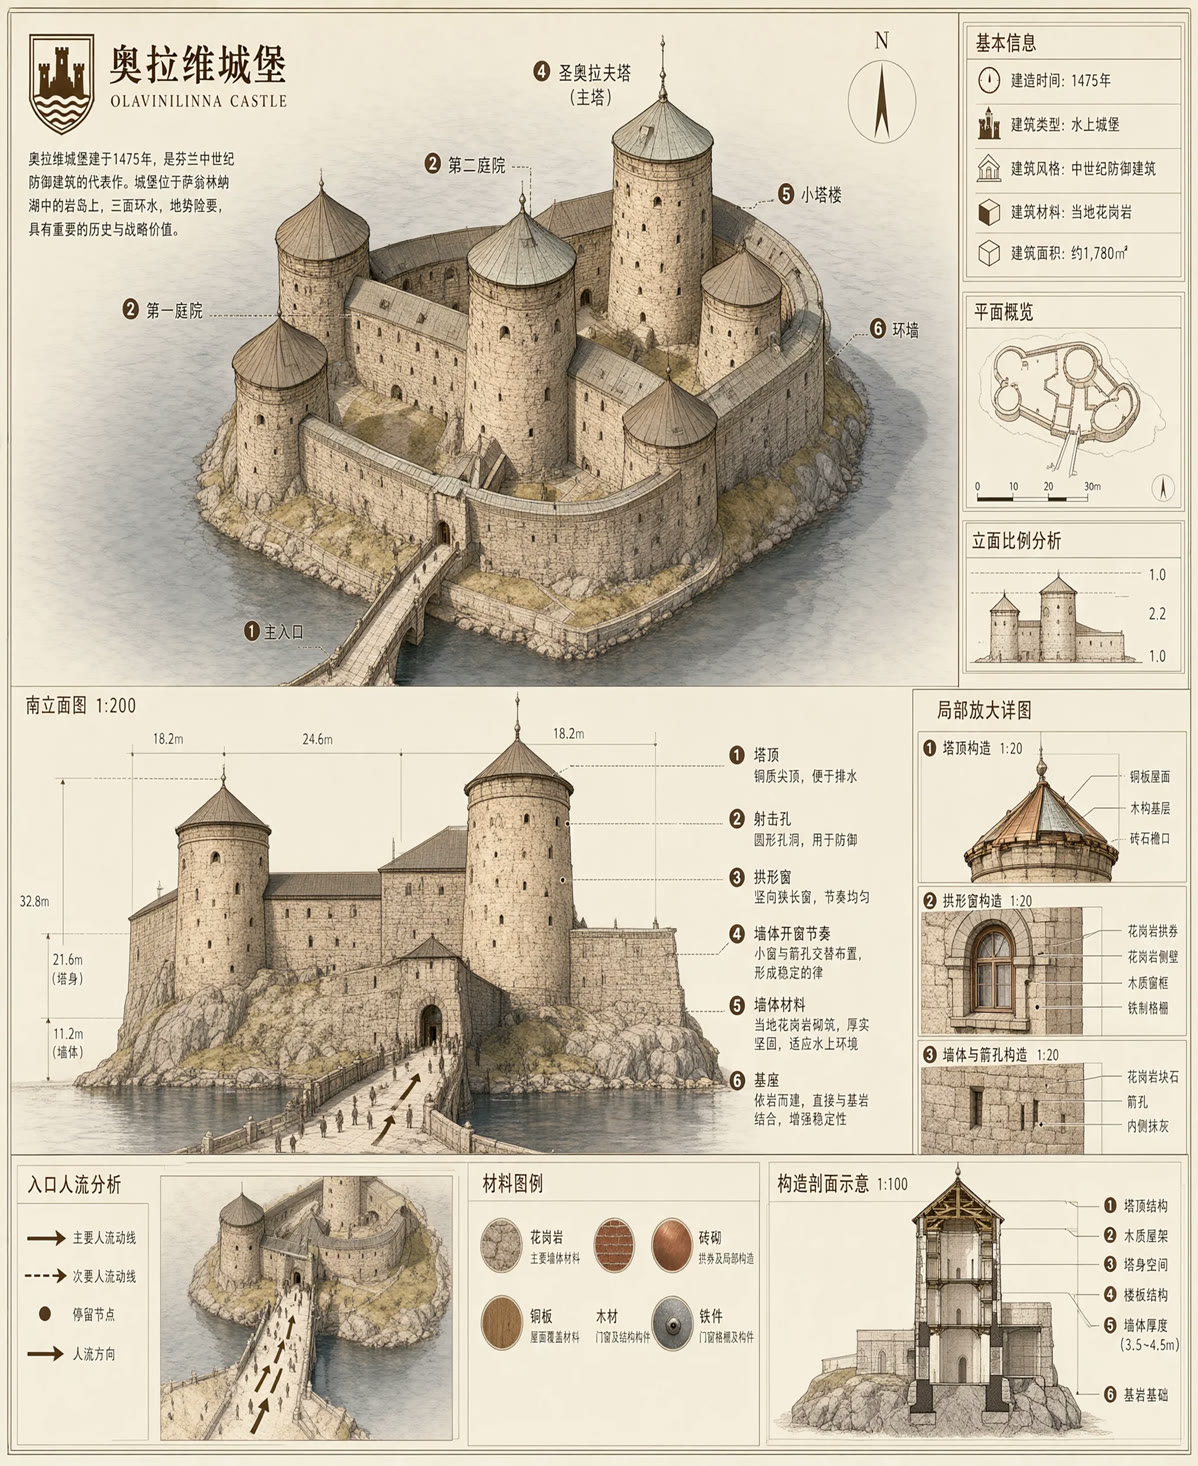
Exemples de typographie et de mise en page issus de la carte du modèle.
Prise en charge de ComfyUI dès le jour 0
ComfyUI a fusionné la prise en charge de Qwen-Image 2.1 dans Comfy-Org/ComfyUI #16400 (CORE-423, par Kijai), et les trois modèles officiels ci-dessous nécessitent ComfyUI 0.37.0 ou une version plus récente. Des commits ultérieurs ont ajouté la compilation des blocs transformer et amélioré le placement du cache KV pour le modèle.
Les poids reconditionnés en fichier unique se trouvent dans Comfy-Org/Qwen-Image-2.1, et les modèles font partie de la galerie de flux de travail intégrée : ils peuvent donc aussi être ouverts depuis le navigateur de modèles au lieu de glisser un JSON.
| Modèle | Ce qu'il fait |
|---|---|
| Texte vers image | Une image 1024x1024 sur 25 étapes d'échantillonnage, sortie native 2K, prise en charge de la typographie et de l'alpha |
| Édition d'image | Deux images de référence via le checkpoint unique de génération et d'édition, utile pour les éditions cohérentes de personnages et les détourages de produits |
| Supprimer l'arrière-plan | Une image en entrée, un résultat transparent en sortie, grâce à la sortie RGBA native du modèle |
Fichiers du modèle
Le reconditionnement Comfy-Org se répartit dans les dossiers habituels :
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   ├── qwen_image_2.1_bf16.safetensors
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── 📂 text_encoders/
    │   ├── qwen3vl_8b_bf16.safetensors
    │   ├── qwen3vl_8b_int8_convrot.safetensors
    │   └── qwen3vl_8b_w4a8.safetensors
    └── 📂 vae/
        └── qwen_image_2.1_vae_bf16.safetensors
À côté de ceux-ci, le reconditionnement contient aussi des encodeurs de texte prompt enhancer, qwen3.5_9b_qwen_image_2.1_pe_t2i et qwen3.5_9b_qwen_image_2.1_pe_i2i en forme INT8 convrot. Ce sont les LLM que Qwen a affinés pour développer une requête courte dans le format de modèle que préfère le modèle d'image, et ils sont optionnels : n'importe quel LLM compétent peut remplir le même modèle de prompt, et le modèle d'image lui-même fonctionne sans eux.
Ce que rapportent les premiers utilisateurs
Le modèle est entre les mains des utilisateurs depuis le jour du lancement, et les mêmes quelques remarques pratiques reviennent sans cesse :
- La taille native compte. Dépasser largement la résolution d'entraînement de la classe 2048 déstabilise l'exposition, tandis que des références d'entrée surdimensionnées ralentissent fortement la génération. Redimensionner une référence avant de la charger coûte moins cher que de laisser l'échantillonneur la traiter.
- Un CFG inférieur à 1 n'est pas utilisable. Un guidance autour de 1 se comporte comme celui de la gamme Qwen-Image précédente, et un petit CFG accompagné d'un prompt négatif axé sur la qualité est ce vers quoi les utilisateurs se tournent lorsque le texte dans l'image doit être plus net.
- Le transfert de style reste aléatoire. Les instructions textuelles changent le style de manière fiable, alors que le style fourni via des images de référence s'est révélé moins fiable, ce qui fait écho aux difficultés rencontrées par les utilisateurs sur les modèles Qwen-Image Editing antérieurs.
Disponibilité
Les poids sont sur Hugging Face et ModelScope, avec l'article de lancement sur le blog Qwen. Les intégrations dès le jour 0, outre ComfyUI, incluent Diffusers via QwenImage21Pipeline, vLLM-Omni, SGLang et LightX2V.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.