ComfyUI v0.37.0 : prise en charge de Qwen-Image 2.1 et MoGe 3
ComfyUI v0.37.0 ajoute le support natif de Qwen-Image 2.1 avec trois modèles officiels, la géométrie MoGe 3, des encodeurs Qwen3.8 accélérés et le chargement rapide sur disque.
MoGe 3 raffine une carte de points grossière sur une coque voxel sparse, en conservant les structures fines que les décodeurs en espace image rendent floues (comparaison issue de Comfy-Org/ComfyUI#16381).
Qwen-Image 2.1 dans le cœur
Qwen-Image 2.1 a été intégré au cœur via Comfy-Org/ComfyUI#16400 (CORE-423) et est livré comme une implémentation native : le transformer de diffusion 7B à flux unique réside dans comfy/ldm/qwen_image21, avec l'encodeur de texte Qwen3-VL-8B lu depuis son dernier état caché et les emplacements d'images de référence insérés par le DiT lui-même.
Deux nouveaux nœuds portent le volet édition du modèle :
- Text Encode Qwen Image 2.1 (
TextEncodeQwenImage21, catégoriemodel/conditioning/qwen image) prend une liste dynamique d'images de référence au lieu d'une entrée fixe, les redimensionne avec le widgetresolution(1024 par défaut, multiples de 32,0conserve chaque référence à sa propre taille) et les insère dans la séquence sous forme de latents VAE. Il produit un conditionnement positif et négatif, plus un latent vide dimensionné sur la première image de référence, ce qui permet de garder une édition alignée. - Qwen Image 2.1 Cache (
QwenImage21Cache) définit où réside le cache KV de préfixe et comment il est stocké :devicevautauto,gpu,cpuouoff, etdtypevautdefault,int8ouint4.cpuprécharge le cache depuis la RAM en arrière-plan du calcul, tandis queoffrecalcule le préfixe à chaque étape, ce qui est plus lent mais permet d'écarter le cache lors du débogage.
Trois modèles officiels accompagnent cette version : texte vers image, édition d'image et suppression de l'arrière-plan. Les trois nécessitent la v0.37.0 ou une version ultérieure.
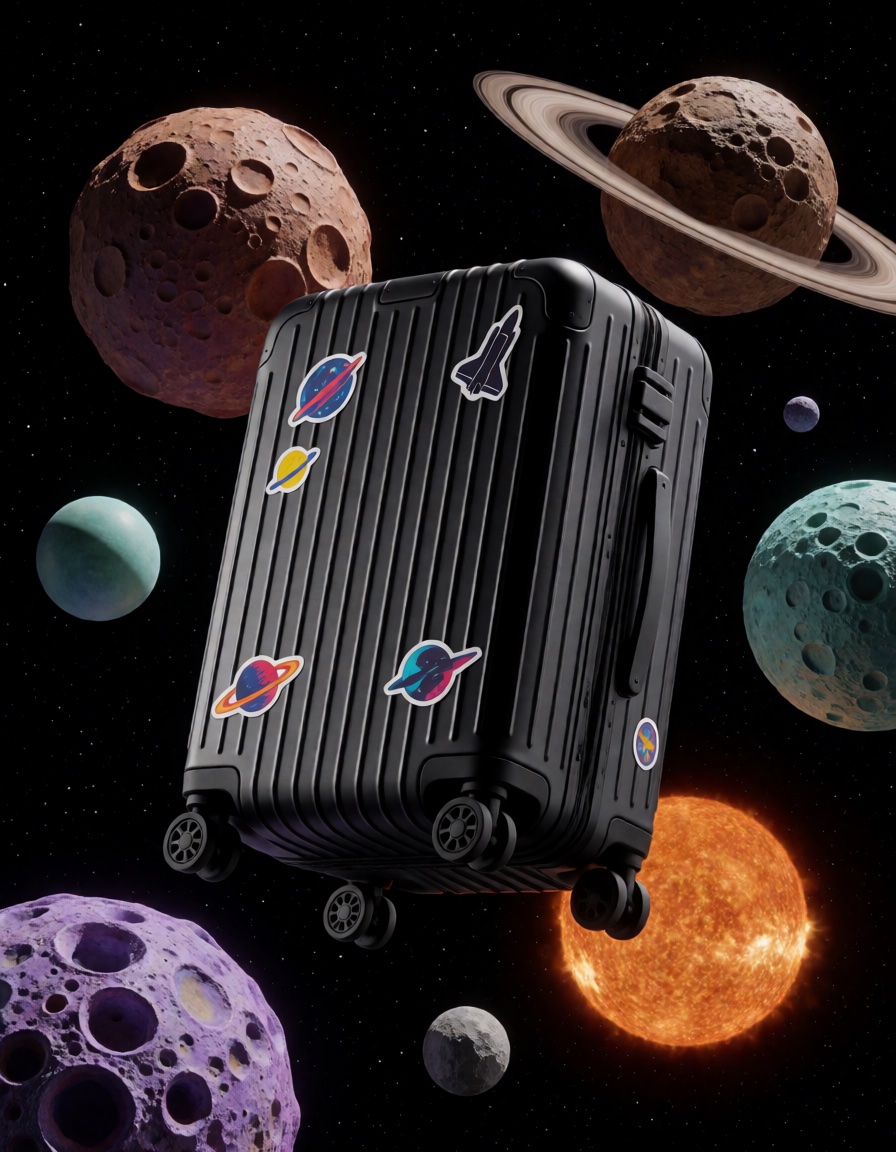
Sortie du modèle officiel d'édition d'image Qwen Image 2.1, issue du référentiel workflow_templates.
Les poids repackagés sont publiés sous Comfy-Org/Qwen-Image-2.1.
MoGe 3 : estimation de géométrie fine
MoGe 3 est la troisième génération du modèle de géométrie monoculaire de Microsoft Research, publié dans l'article MoGe-3: Fine-Detail Monocular Geometry Estimation with Self-Guided Sparse Volumetric Refinement. Au lieu de décoder directement une carte de points dans l'espace image, il élève la prédiction grossière sur une coque voxel sparse et exécute un UNet 3D sparse par-dessus, ce qui permet de conserver nets les structures fines et les discontinuités de profondeur.
La prise en charge dans le cœur est arrivée avec Comfy-Org/ComfyUI#16381 (CORE-443) pour les deux checkpoints, ViT-L et ViT-G. Le portage ComfyUI construit le raffineur sur les kernels sparse FlexGEMM que le projet livre déjà pour Trellis 2 (comfy/ldm/trellis2/flexgemm.py), donc rien de supplémentaire ne doit être installé sur une configuration CUDA classique.
Teaser de la page du projet MoGe 3.
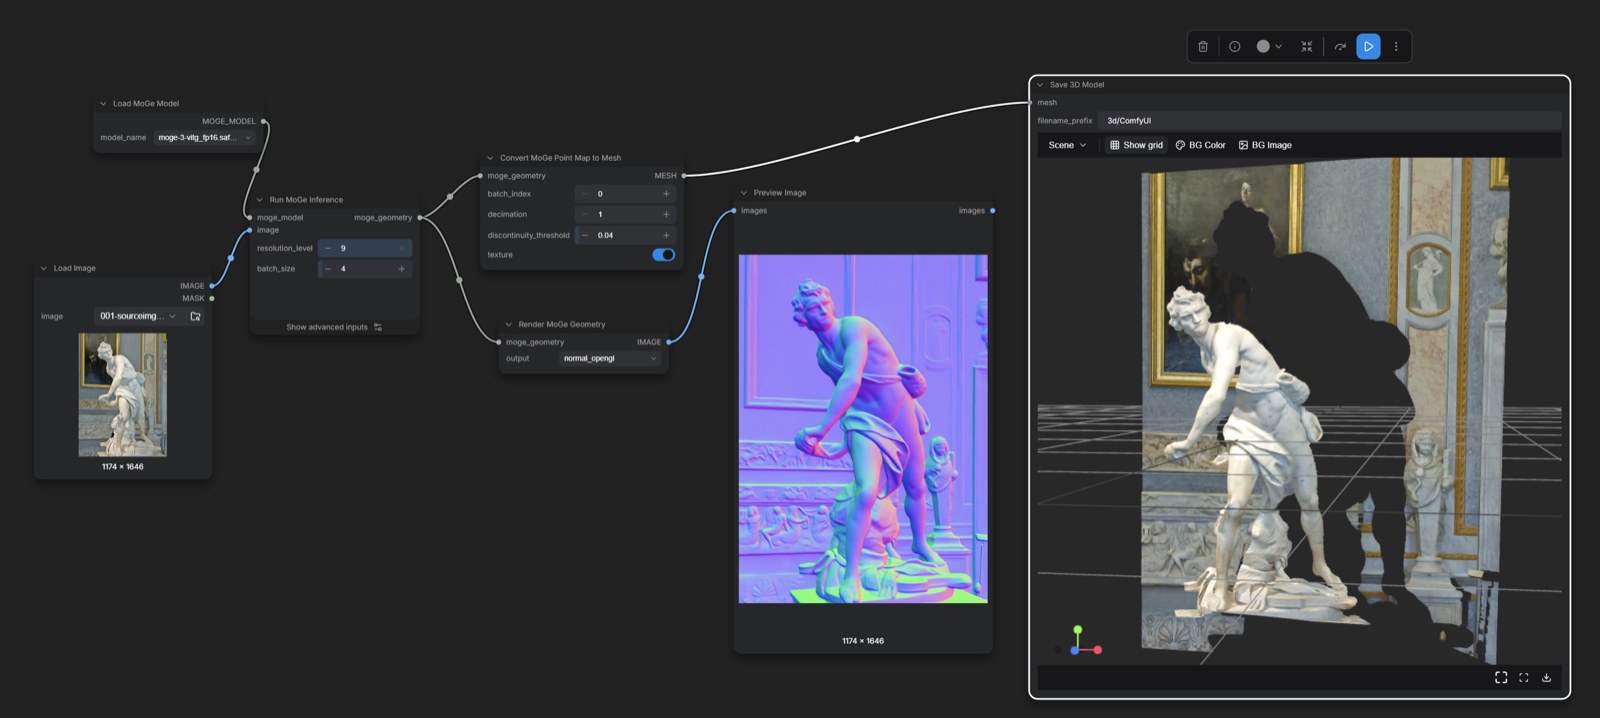
Le modèle officiel utility_moge3_geometry_estimation prend une image en entrée et produit une carte de profondeur et une carte de normales de surface. Il charge moge_3_vitg_fp16.safetensors par défaut, et le fichier ViT-L est sélectionnable dans le même menu déroulant. Le nouveau widget refine_steps des nœuds Inférence MoGe et Inférence panorama MoGe contrôle directement le raffineur MoGe-3 : 3 par défaut, jusqu'à 8, et 0 le désactive. Il n'a aucun effet sur les checkpoints MoGe 1 ou MoGe 2, que les nœuds chargent toujours.
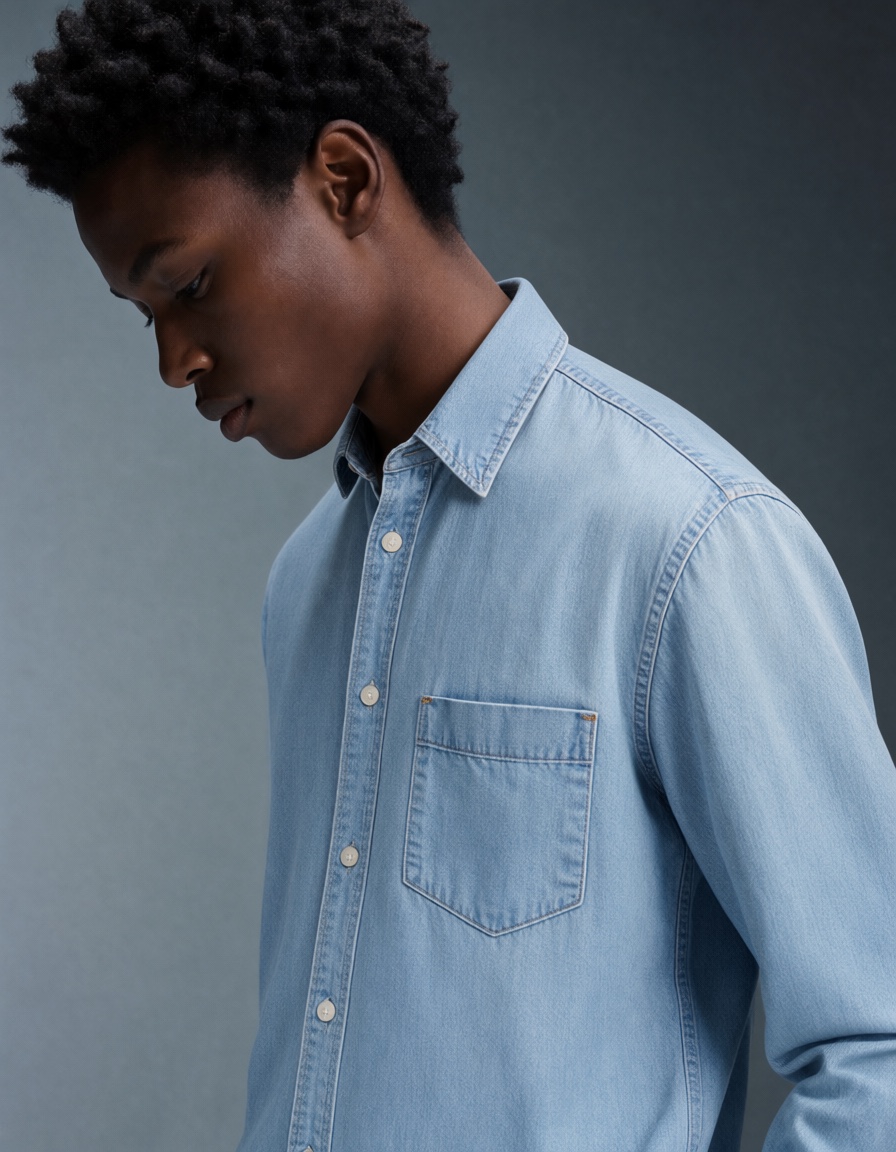
Le modèle fonctionne à partir d'une seule image (asset d'entrée issu du référentiel workflow_templates).
Le modèle attend les poids repackagés de Comfy-Org/MoGe :
📂 ComfyUI/
└── 📂 models/
    └── 📂 geometry_estimation/
        ├── moge_1_vitl_fp16.safetensors
        ├── moge_2_vitl_normal_fp16.safetensors
        ├── moge_3_vitg_fp16.safetensors
        └── moge_3_vitl_fp16.safetensors
La même famille de nœuds conserve les outils antérieurs : l'inférence panorama qui découpe une image équirectangulaire en douze vues en perspective et refusionne la profondeur, la conversion de carte de points en maillage, et une lecture du FoV pour l'alignement de caméra.
Encodeurs de texte Qwen plus rapides
Comfy-Org/ComfyUI#15623 (CORE-390) est une passe d'optimisation de la vitesse de décodage des encodeurs de texte Qwen3.5 et Qwen3.8, qui comptent pour la réécriture de prompt Qwen-Image et pour les nœuds de génération de texte :
- Décodage spéculatif : la tête de prédiction multi-token du checkpoint propose 2 à 5 tokens et une passe de vérification par lots les accepte. La tête de draft s'exécute comme un graphe CUDA capturé et la passe de vérification s'exécute sous le compilateur de mémoire.
- FixedKVBias : un cache d'attention à pleine capacité avec une position d'écriture côté appareil, afin que les étapes de décodage restent rejouables en graphe entre
llama.pyetqwen35.py. - Kernels de décodage DeltaNet fusionnés issus de comfy-kitchen, avec un repli en mode eager, plus des pénalités de répétition et de présence appliquées via un masque de vocabulaire de taille fixe au lieu d'une allocation à chaque étape.
Le nœud Text Generate expose cela via un nouveau widget mtp avec les options auto, off et 2 à 5. auto adapte la profondeur du draft, et les valeurs épinglées la fixent. Il n'a aucun effet sur les checkpoints dépourvus de poids MTP, et l'infobulle précise que la sortie échantillonnée reste correctement distribuée mais diffère de la sortie non-MTP pour la même graine. La même version ajoute la prise en charge W4A8 GEMV pour ces encodeurs, ce qui s'accompagne des repacks int8 et W4A8 publiés par Comfy-Org.
Disque rapide et mémoire
La v0.37.0 passe à comfy-aimdo 0.5.5, qui inclut une implémentation C native de la détection de disque rapide sous Windows. ComfyUI détecte désormais seul un disque rapide et active automatiquement le chargement dynamique adossé au disque et l'offload, par modèle, lorsque le lecteur est un NVMe PCIe 4 ou meilleur : les poids sautent le tampon RAM et l'étape d'amorçage d'enregistrement des pins. Les configurations mixtes obtiennent la priorité RAM pour les lecteurs plus lents, de sorte qu'une bibliothèque de modèles répartie entre un NVMe et un disque mécanique continue d'utiliser le cache là où c'est utile. --fast-disk force toujours le comportement et le nouveau --disable-fast-disk le désactive, en prenant le pas sur --fast-disk.
Deux autres changements de mémoire arrivent dans la même version. L'encodeur de texte est désormais conservé sur le GPU chaque fois que la VRAM dynamique est activée, au lieu d'être déplacé dans les deux sens, et le pic de VRAM des modèles Wan diminue lorsque l'attention comfy-kitchen est utilisée.
Autres changements
- Image Latente Vide est désormais en 1024 x 1024 par défaut au lieu de 512 x 512, afin qu'un nœud neuf corresponde aux résolutions d'entraînement des modèles modernes.
- MiniMax Music 3 ne produit plus de bruit lorsque les graphes du compilateur ComfyUI sont activés : l'encodeur de texte autoregressif utilise désormais des tampons de décodage épinglés, comme YuE2 et le chemin de génération générique.
- ACE-Step : le décodage VAE ne plante plus sur les GPU qui ne prennent pas en charge le bf16.
- Le nœud YuE2 Générer de la musique a gagné un contrôle CFG, et la précision de l'embedding de position de SheetSage2 a été alignée sur l'amont.
- Les noms et catégories des nœuds ont été nettoyés dans tout le graphe.
- Nœuds partenaires : Meshy 7.1, arrière-plans transparents pour GPT Image 2, une garde pour qu'une exécution Tripo P2 soit refusée lorsque sa sortie GLB ou FBX liée serait vide, et une clé d'idempotence sur les appels partner-proxy afin que les tentatives ne soient pas facturées deux fois.
- comfyui-frontend-package mis à jour vers 1.53.6, les modèles de flux de travail vers la v0.11.66, la documentation intégrée vers 0.5.12 et comfy-kitchen vers 0.2.35.
Obtenir la v0.37.0
Mettez à jour ComfyUI via le Gestionnaire ou votre lanceur préféré. Les nœuds Qwen-Image 2.1 et MoGe 3 ainsi que leurs modèles nécessitent la v0.37.0 ou une version ultérieure, tandis que les versions Desktop et Cloud suivent les versions stables.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.