SelfLift apporte l'échantillonnage à résolution progressive à ComfyUI
comfyui-SelfLift fait le débruitage initial en basse résolution puis termine en pleine résolution: accélération sans entraînement pour Z-Image, FLUX.2-Klein et MiniMax H3.
Comment SelfLift découpe le planning
Les modèles à peu d'étapes comme Z-Image-Turbo et FLUX.2-Klein compressent l'axe temporel, ce qui fait du coût spatial de chaque passe avant restante le terme dominant. L'échantillonnage à résolution progressive réduit ce coût en débruitant d'abord en basse résolution. Le problème identifié par l'article SelfLift (arXiv:2609.02036) est que se contenter d'élever un latent et de compter sur les quelques étapes restantes pour absorber le décalage laisse des artefacts visibles.
SelfLift tire au contraire le signal de réparation du modèle lui-même : après l'élévation, une fraction des emplacements à haut risque est corrigée vers un ancrage pixel-VAE, et la transition est conçue pour que le préfixe basse résolution reste une partie valide de la même trajectoire. Les points de départ rapportés dans l'article sont 6 étapes sur 8 en basse résolution pour Z-Image-Turbo et 3 sur 4 pour FLUX.2-Klein.
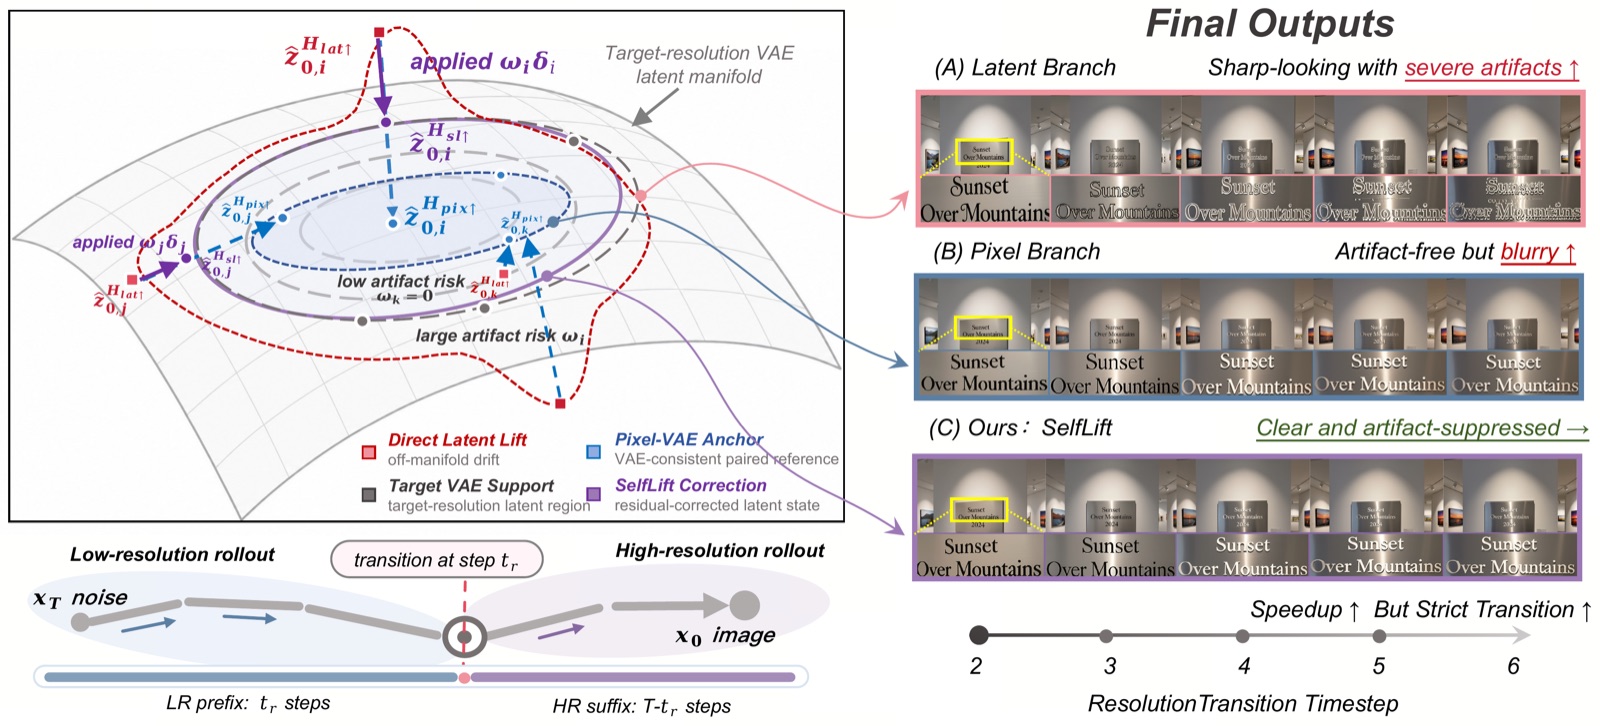
La figure teaser de SelfLift issue de la page du projet.
Trois nœuds dans un seul paquet
| Nœud | Classe | Ce qu'il fait |
|---|---|---|
| SelfLift Progressive Sampler (Image) | SelfLiftImageSampler | Échantillonnage à résolution progressive pour les modèles d'image à flux rectifié, en utilisant le VAE du modèle lui-même |
| SelfLift Progressive Sampler (MiniMax H3) | SelfLiftH3Sampler | Adaptation audio-vidéo expérimentale de la même idée pour H3 |
| H3 Temporal State Transport (TST) | SelfLiftH3TST | Un correctif MODEL vers MODEL qui corrige le déséquilibre temporel dans les vidéos H3 |
Les échantillonneurs se branchent sur le câblage standard des échantillonneurs ComfyUI : ils prennent une entrée sampler et une entrée sigmas comme SamplerCustom, vous connectez donc KSamplerSelect réglé sur euler et le scheduler du modèle. Les autres échantillonneurs sont rejetés volontairement.
Les principaux réglages sont transition_step (le nombre d'étapes maintenues en basse résolution), lowres_scale (0.5 par défaut), rho (la fraction d'emplacements à haut risque tirés vers l'ancrage VAE, 0 le désactive), w_min / w_max pour la force de correction, l'interpolation d'élévation (nearest ou bilinear), et un model_hires optionnel pour que l'étape haute résolution puisse utiliser un autre checkpoint ou un autre empilement LoRA. La transition n'ajoute aucune évaluation supplémentaire du débruiteur : un programme de N étapes reste exactement N, plus un aller-retour de décodage VAE, agrandissement et réencodage, sauf si rho vaut 0.
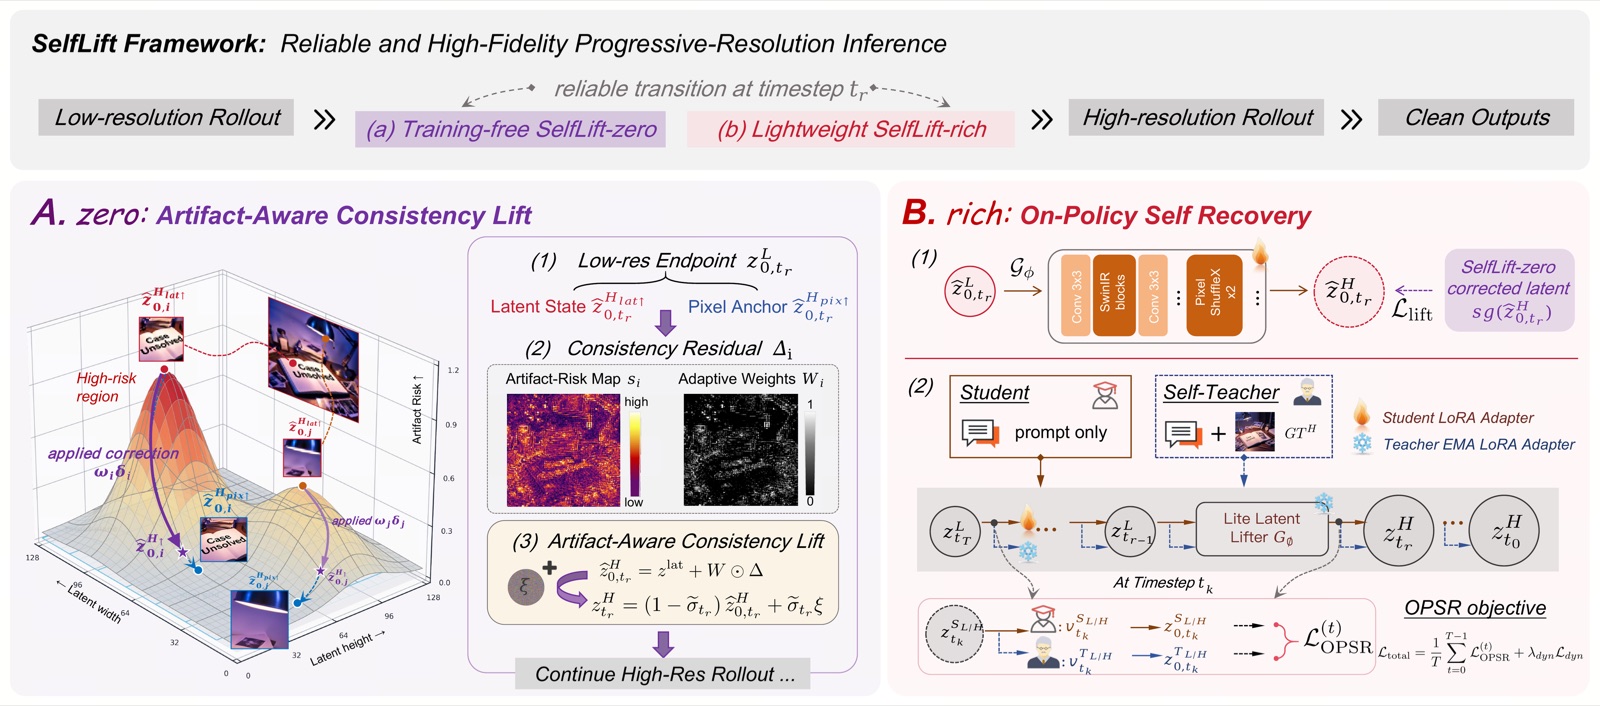
Vue d'ensemble de SelfLift : préfixe basse résolution, élévation du latent et étape haute résolution ancrée.
Le chemin MiniMax H3
L'échantillonneur H3 est explicitement marqué comme expérimental par l'auteur et n'est pas validé par l'article. Il propose deux voies d'élévation :
- Upscaler externe (par défaut) : un upscaler latent H3 installé avec
rhoà 0, une élévation latente apprise uniquement. Compatible avec les poids de l'upscaler latent H3, crédités dans le README ; le nœud récupère un fichierh3dansmodels/latent_upscale_models/. - SelfLift-zero :
upscaler_modeldéfini sur none avecrhosupérieur à 0. Le point de départ H3 testé par l'auteur estrho 0.6avecw_minetw_maxà 1, après qu'une exécution à graine unique a montré que le réglage image de l'article laissait des artefacts sur le chemin d'élévation directe de H3.
Une option expérimentale highres_tiling découpe la phase haute résolution en 1 à 8 tuiles spatiales. Elle ne conserve que l'audio de la première tuile, n'a pas d'attention inter-tuiles et ne prend pas en charge ControlNet : c'est donc un compromis de mémoire plutôt qu'un réglage de qualité.
Transport d'état temporel
TST est le deuxième article porté ici (arXiv:2609.08505). Il mesure une tension spectrale signée de l'opérateur d'attention au niveau des images et ne corrige que les têtes déséquilibrées : il accentue celles qui sont trop mélangées et adoucit celles qui sont fragmentées, avec une correction plus forte dans les couches profondes et les étapes antérieures. Il fonctionne avec n'importe quel échantillonneur standard, pas seulement l'échantillonneur SelfLift, et l'auteur rapporte une surcharge d'exécution d'environ 1 à 2 pour cent.
En pratique, il cible les défauts que les utilisateurs remarquent le plus dans les sorties H3 : détails qui scintillent ou se transforment, comme le texte et les logos à l'écran, dérive d'identité des personnes et des tenues, et mouvements physiquement invraisemblables. tau est le réglage de force et 0.2 est la valeur recommandée ; 0.5 est visiblement trop fort. Il ne peut pas inventer des détails que le modèle ne possède pas, il ne s'applique qu'aux modèles H3, et il est ignoré lorsque highres_tiling est activé. Une option de journalisation imprime une ligne de diagnostic par passe avant du modèle, y compris la part de têtes corrigées, que l'auteur a mesurée comme correspondant à l'opérateur d'attention exact pour 89 à 100 pour cent des têtes.
Disponibilité
Clonez facok/comfyui-SelfLift dans ComfyUI/custom_nodes et redémarrez ; tous les nœuds apparaissent dans la catégorie selflift. Le paquet dispose d'une documentation en anglais et en chinois, incluant un tableau de préréglages de diagnostic pour le réglage de la voie d'élévation H3.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.