Anima-Light-Lavender : post-entraînement pour prompts longs
Anima-Light-Lavender est un post-entraînement d'Anima-Base v1.0 qui lit des prompts naturels de 512 tokens et s'installe dans ComfyUI sans modification.
Anima-Base v1.0 prend les tags de style Danbooru comme entrée native. Anima-Light-Lavender va dans la direction opposée : il est entraîné sur des légendes structurées comportant un long champ image_description en langage naturel, et cette version se concentre sur la compréhension des descriptions à l'échelle de 512 tokens. Le jeu d'entraînement compte environ 1,7 M d'images Danbooru, annotées et filtrées par un pipeline de données dont les modèles d'annotation, de filtrage et de jugement de préférences ont tous été entraînés par l'auteur plutôt qu'empruntés sur étagère.
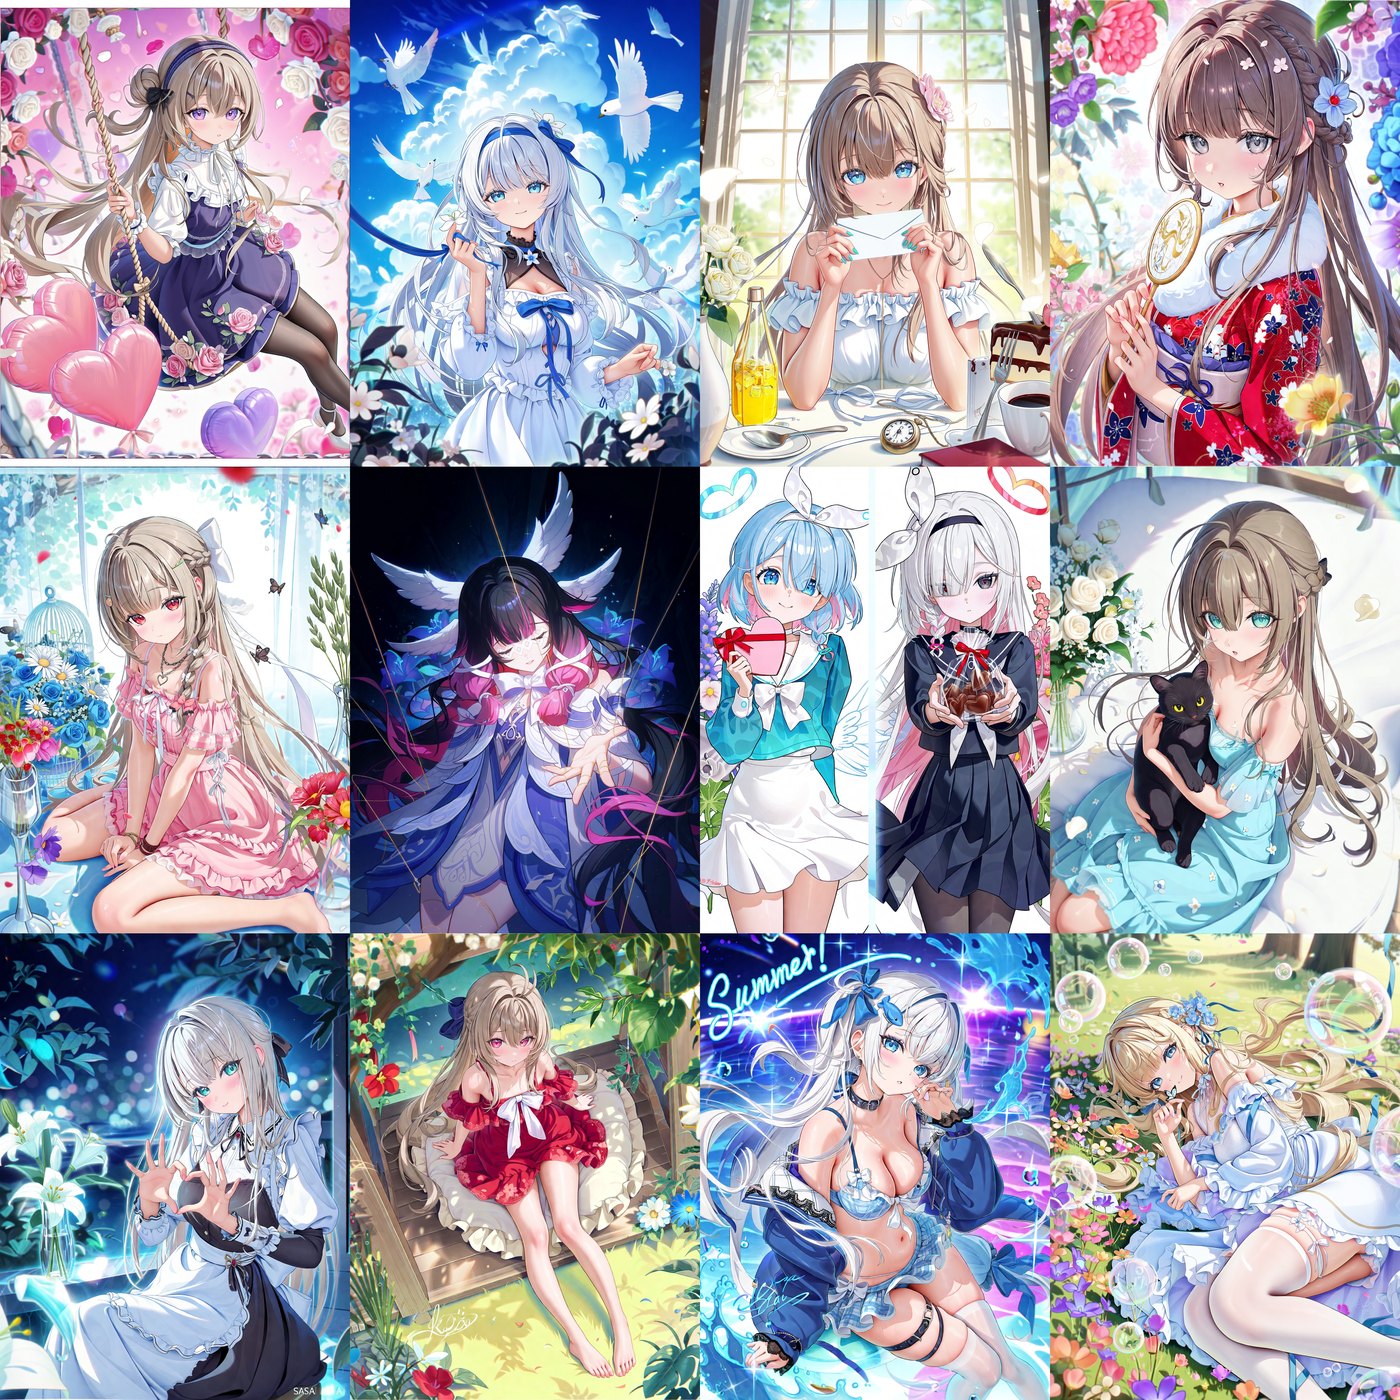
Le modèle cible les illustrations anime, les personnages et l'art stylisé, et se pilote par des passages descriptifs plutôt que par des piles de tags.
Ce qui a changé, et ce qui n'a pas changé
| Anima-Light-Lavender | |
|---|---|
| Modèle de base | Anima-Base v1.0 (anima-base-v1.0.safetensors) |
| Architecture | Inchangée : ~2B paramètres, DiT de 28 calques, aucun calque ajouté et aucune distillation |
| Encodeur de texte | Qwen3-0.6B (qwen_3_06b_base.safetensors) |
| VAE | VAE Qwen-Image (qwen_image_vae.safetensors) |
| Poids | anima-light-lavender.safetensors (BF16) et anima-light-lavender_mxfp8.safetensors (MXFP8, inférence plus rapide) |
| Axe d'entraînement | Descriptions en langage naturel à l'échelle de 512 tokens, plus des données de meilleure qualité |
Comme le nombre de calques, le nombre de paramètres et la disposition des fichiers correspondent au modèle de base, un flux de travail Anima existant n'a besoin que d'échanger son checkpoint.
Installation dans ComfyUI
- Placez un fichier de poids dans
ComfyUI/models/diffusion_models/. Choisissez soit la version BF16, soit la version MXFP8, pas les deux. - Réutilisez l'encodeur de texte et le VAE de votre installation Anima actuelle :
qwen_3_06b_base.safetensorsdansComfyUI/models/text_encoders/,qwen_image_vae.safetensorsdansComfyUI/models/vae/. - Installez les nœuds compagnons avec
git clone https://github.com/aa0525/comfyui-zako-pe.gitdansComfyUI/custom_nodes/, puis redémarrez ComfyUI.
Le pack comfyui-zako-pe ajoute deux nœuds : Danbooru Caption JSON, qui assemble la légende structurée, et Danbooru Prompt Extend (OpenAI), qui appelle un serveur compatible OpenAI pour développer un image_description de style tags en langage naturel. Le modèle compagnon zako-pe (ZAKO-V0.1) est conçu pour assurer ce développement localement.
Cette version fournit deux flux de travail, tous deux chargeables en glissant le JSON sur la toile ComfyUI :
Les deux utilisent par défaut les poids MXFP8. Si vous avez installé le fichier BF16 à la place, basculez le checkpoint dans le nœud Charger Modèle Diffusion.
Écrire un prompt avec une légende structurée
Le modèle est entraîné sur une légende à champs fixes, la description étant rédigée en prose :
{
  "year": 2025,
  "preference_level": "best",
  "artist": [...],
  "copyright": [...],
  "character": [...],
  "image_description": "...",
  "extra_tags": [...]
}| Champ | Rôle |
|---|---|
year | Année de référence, par défaut 2025 |
preference_level | normal, high, very_high ou best (par défaut best) |
artist | Tags d'artiste et de style |
copyright | Tags de série ou de franchise |
character | Tags de personnage |
image_description | Le contenu de l'image, rédigé sous forme de passage détaillé en langage naturel |
extra_tags | Tags de contenu supplémentaires |
Si rédiger un long passage n'est pas ce que vous voulez, le flux de travail de base accepte des tags et laisse le nœud de développement du prompt les réécrire. L'alternative proposée par l'auteur consiste à décrire l'image et à laisser le modèle faire le reste : les notes de version indiquent que les résultats restent propres même sans mots de qualité ni prompt négatif.
Paramètres recommandés
| Paramètre | Valeur |
|---|---|
| Échantillonneur | euler |
| Scheduler | simple |
| Étapes | 25 |
| CFG | 4.0 |
| Résolution | Environ 1280×1280 |
| Prompt négatif | Laisser vide |
Détails de l'entraînement
L'entraînement s'est déroulé en BF16 avec MXFP8 GEMM dans les multiplications matricielles du MLP et de l'attention, une taille de lot de 1024 et un taux d'apprentissage maximal de 4e-5. Les paramètres 2D du MLP et de l'attention ont été mis à jour par Muon (momentum 0.95, match_rms_adamw) tandis que les paramètres restants sont restés sur AdamW (β 0.9 / 0.95, ε 1e-8). Les niveaux de preference_level des légendes proviennent d'un modèle de préférence entraîné sur environ 3 M d'échantillons, et les données d'entraînement s'étendent jusqu'à fin novembre 2025.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.