ComfyUI v0.36.0 : Marigold V2 natif et nœud Concaténer des vidéos
ComfyUI v0.36.0 apporte l'estimation native de profondeur, normales et albédo avec Marigold V2, trois flux officiels, le nœud Concaténer des vidéos, plus FastH3 et YuE2.
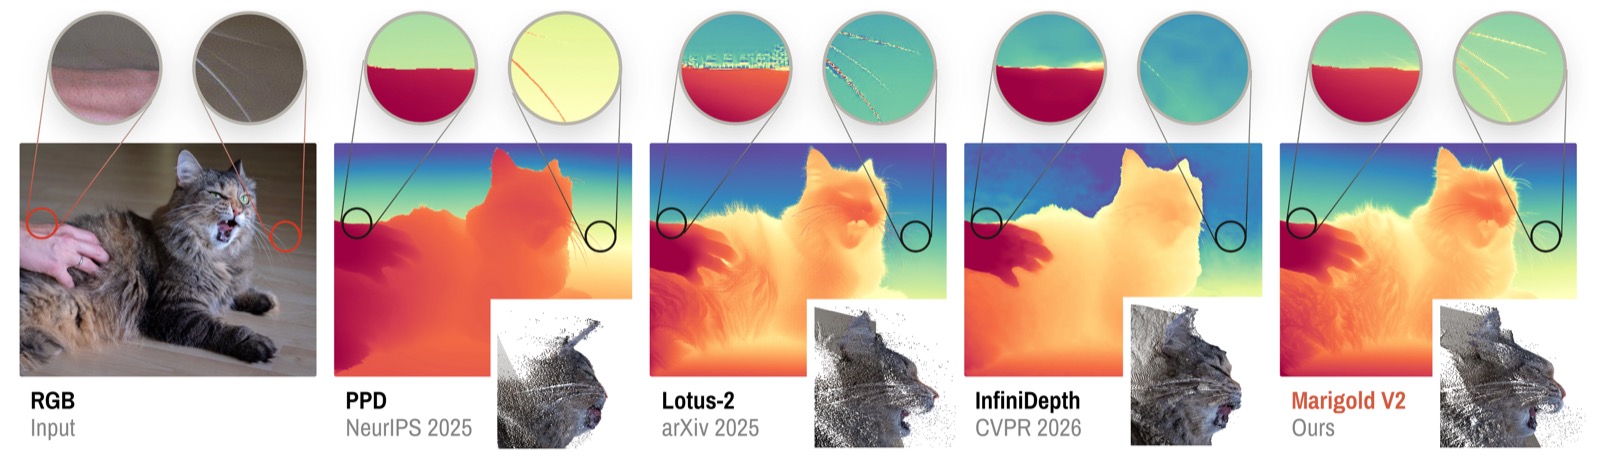
Marigold V2 lit la géométrie directement dans une seule image : profondeur, normales de surface et albédo issus de la même famille de checkpoints (aperçu issu du référentiel du projet).
Marigold V2 : profondeur, normales de surface et albédo
Marigold V2 vient du HUAWEI Bayer Lab, en collaboration avec l'EPFL et l'Université de Bologne, et est présenté à SIGGRAPH Asia 2026 (arXiv:2609.08084). Plutôt que d'entraîner un nouveau modèle de diffusion à partir de zéro, il effectue un fine-tuning de Qwen-Image-Edit-2509 avec des poids LoRA par tâche et des décodeurs VAE affinés, puis lit la prédiction à partir du latent en une seule étape d'échantillonnage.
La prise en charge principale est arrivée via Comfy-Org/ComfyUI#16232 (CORE-431), et les modèles officiels sont livrés avec les poids rempaquetés par Comfy-Org dans Comfy-Org/marigold-v2-0. Trois tâches sont couvertes :
- Profondeur : profondeur logarithmique affine-invariante issue du checkpoint
depth/Log-stage2par défaut de l'article, entraînée sur Hypersim et Virtual KITTI 2 (environ 74 k images). - Normales de surface : normales unitaires dans l'espace caméra.
- Albédo : albédo RGB linéaire dans [0, 1].
La version amont contient également des checkpoints de profondeur en transparence (par couches) qui prédisent la géométrie derrière une vitre, ainsi que des ablations de profondeur uniforme et de disparité. Le paquet ComfyUI livre les trois modalités principales.
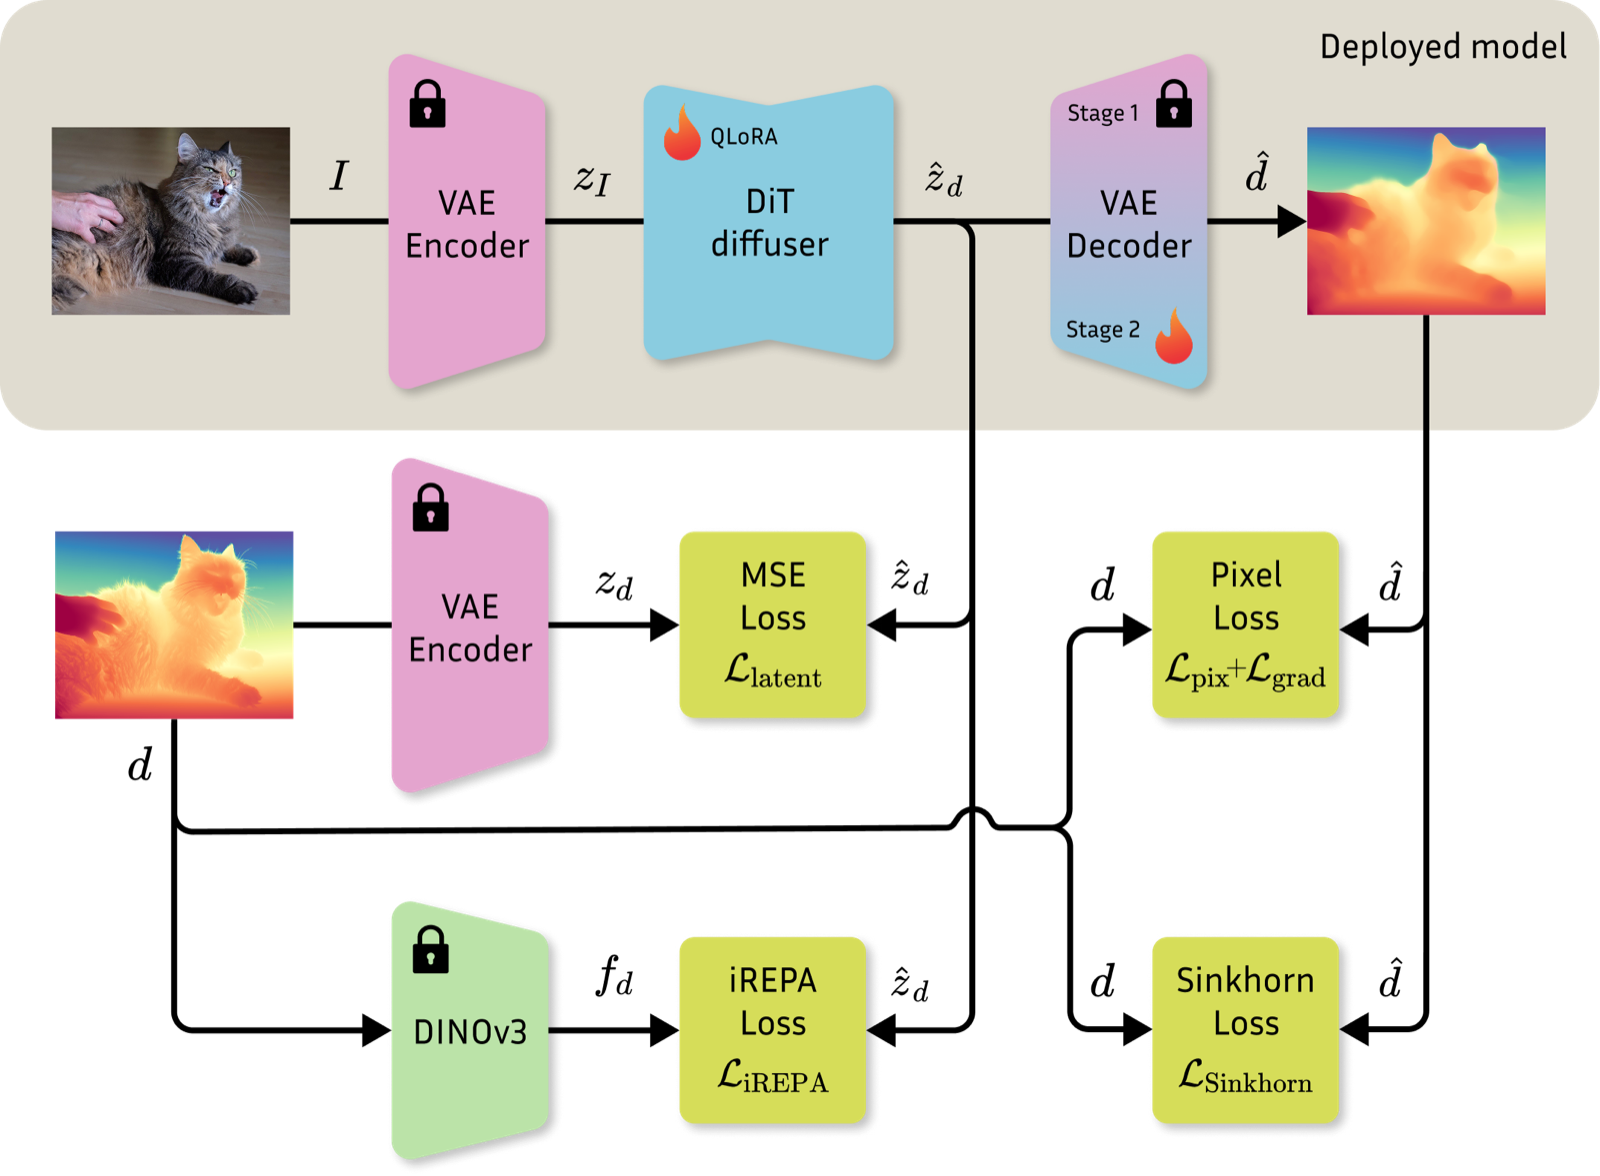
Vue d'ensemble de la méthode issue du référentiel du projet : un seul backbone Qwen-Image-Edit-2509 est adapté pour chaque tâche de prédiction dense.
À l'intérieur des flux de travail Marigold V2
Chaque modèle est construit sous forme de sous-graphe. Il charge la base int8 ConvRot Qwen-Image-Edit-2509 qwen_image_edit_2509_int8_convrot.safetensors, applique le LoRA de la tâche, charge un embedding de conditionnement précalculé et le VAE de la tâche, puis échantillonne avec euler sur les sigmas 0.5 -> 0, soit une seule étape. Aucun encodeur de texte n'est requis : les embeddings de prompt sont livrés sous forme de fichiers *_conditioning.safetensors, chargés via ConditioningLoader.
Un nouveau nœud Post-traitement Marigold V2 (MarigoldV2PostProcess, catégorie image/geometry estimation) convertit la prédiction décodée en une image visualisable, avec un commutateur prediction pour depth (normalisé, le proche en clair), normals (normales unitaires) ou albedo (sRGB).
Fichiers attendus par les modèles :
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   └── qwen_image_edit_2509_int8_convrot.safetensors
    ├── 📂 loras/
    │   ├── marigold_v2_depth_log_stage2.safetensors
    │   ├── marigold_v2_normals.safetensors
    │   └── marigold_v2_albedo.safetensors
    ├── 📂 embeddings/
    │   ├── marigold_v2_depth_conditioning.safetensors
    │   ├── marigold_v2_normals_conditioning.safetensors
    │   └── marigold_v2_albedo_conditioning.safetensors
    └── 📂 vae/
        ├── marigold_v2_depth_log_stage2_vae.safetensors
        ├── marigold_v2_normals_vae.safetensors
        └── marigold_v2_albedo_vae.safetensors
Chiffres zéro-shot publiés avec le modèle : profondeur AbsRel / δ1 de 3,6 / 98,0 sur NYUv2, 5,4 / 97,4 sur KITTI, 2,8 / 99,2 sur ETH3D, 3,7 / 97,9 sur ScanNet et 5,2 / 97,1 sur DIODE ; erreur angulaire moyenne des normales de surface de 16,6° sur NYUv2 ; albédo PSNR 20,78 et SSIM 0,811 sur le split de test Hypersim.
Nœud Concaténer des vidéos
La v0.36.0 ajoute un nœud Concaténer des vidéos (ConcatenateVideo, catégorie video) pour joindre des clips bout à bout dans le graphe :
- Les entrées s'étendent automatiquement sous la forme
video1,video2, etc., jusqu'à 100 segments, et sont ajoutées dans l'ordre des entrées. - Lorsque les segments sont déjà encodés avec un codec compatible, ils sont concaténés sans décodage.
codecvautauto(H.264) par défaut, et les vidéos déjà encodées sont laissées intactes.- Une entrée facultative
complete_audioremplace l'audio porté par les segments, ce qui est utile lorsque les clips proviennent de générations distinctes.
Prise en charge de FastVideo FastH3 et YuE2
Cette version promeut également au cœur deux modèles plus anciens :
- FastVideo FastH3, le MiniMax H3 distillé en 8 étapes pour le texte-vers-vidéo et l'image-vers-vidéo avec audio natif. Voir Les modèles ComfyUI natifs de FastH3 8-Step V2 pour les checkpoints et les paramètres d'attention VSA sur lesquels reposent les modèles.
- YuE2, la génération de musique à partir de prompts de style et de paroles, avec des correctifs de suivi pour les systèmes AMD, une durée maximale de morceau plus élevée et davantage de contrôles sur le nœud de génération. Couverture antérieure : YuE2.
Autres changements de nœuds et du cœur
- Boucles génériques :
Start LoopetEnd Loopsont arrivés dans la même version pour itérer sur des listes à l'intérieur d'un graphe, avecCreate ListetGet Item From List. - Convertir l'espace colorimétrique de l'image a gagné une destination
linear(Rec.709 linéaire), en plus des espaces sRGB, HDR et HDR PQ existants. - Nœud texte Gemini :
GeminiNodeV3a été ajouté et le nœud V2 est désormais obsolète. - MiniMax H3 : l'empreinte mémoire du VAE vidéo a encore été réduite, en complément des travaux sur le VAE int8 ConvRot.
- AMD sous Windows : le quota d'adresses virtuelles a été porté à 4TB (CORE-409), et une barrière d'architecture triton ROCm devenue inutile a été supprimée des opérations de quantification.
Mises à jour des nœuds partenaires
- Tripo P2 : nœuds de génération de modèle 3D à partir de texte, d'image et de multivues.
- Pruna P-Video-2 : texte-vers-vidéo et image-vers-vidéo en 720p/1080p avec un mode brouillon.
- BFL : un nœud Édition vidéo Flux qui modifie un clip source à partir d'une instruction textuelle.
- Bria : de nouveaux nœuds d'édition d'image ainsi qu'un nœud Video Eraser (Gomme vidéo).
- OpenRouter : les modèles Microsoft
mai-image-2.6et le ratio d'aspect automatique sur le nœud d'image. - Client : la progression des nœuds partenaires exploite désormais les en-têtes de durée estimée pour l'affichage de la progression.
Correctifs et autres changements
- Correction de H3 Fun ControlNet lorsque le compilateur de ComfyUI est activé.
- Le nœud Ajout de bruit à l'image n'ajoute plus de bruit au canal alpha.
- Les problèmes AMD de Yue2 ont été corrigés, et davantage de contrôles ont été ajoutés au nœud de génération ABC.
- RoPE est désormais appliqué avec des kernels rapides sur davantage de modèles basés sur llama, ce qui couvre les encodeurs de texte utilisés par les modèles de la classe Qwen-Image-Edit.
- comfy-kitchen mis à jour vers 0.2.34, comfyui-frontend-package vers 1.52.7 et les modèles de flux de travail vers la v0.11.62.
- Les enregistrements de ressources ont été séparés du contenu derrière le flag
--enable-assets.
Obtenir la v0.36.0
Mettez à jour ComfyUI via le Gestionnaire ou votre lanceur préféré. Les flux de travail Marigold V2 et le nœud Concaténer des vidéos nécessitent la v0.36.0 ou une version ultérieure, tandis que les versions Desktop et Cloud suivent les versions stables.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.