Rumik OSS 1 : modèle TTS ouvert 3B pour 22 langues indiennes
Rumik AI publie rumik-oss 1, un modèle de synthèse vocale 3B pour 22 langues indiennes plus l'anglais, avec alternance de langues, contrôle du ton et balises de rire.
<laugh>, <chuckle> et <sigh>. Un checkpoint de base pour le post-entraînement par la communauté est inclus, et une démo Hugging Face interactive est disponible.
Aperçu
rumik-oss 1 étend tiny aya fire avec des tokens de parole discrets issus du codec mimi. Le conditionnement textuel et la génération audio partagent une seule séquence autoregressive : le modèle prédit huit tokens de codebook par trame audio dans l'ordre des codebooks, puis le décodeur mimi gelé reconstruit la forme d'onde à 24 kHz.
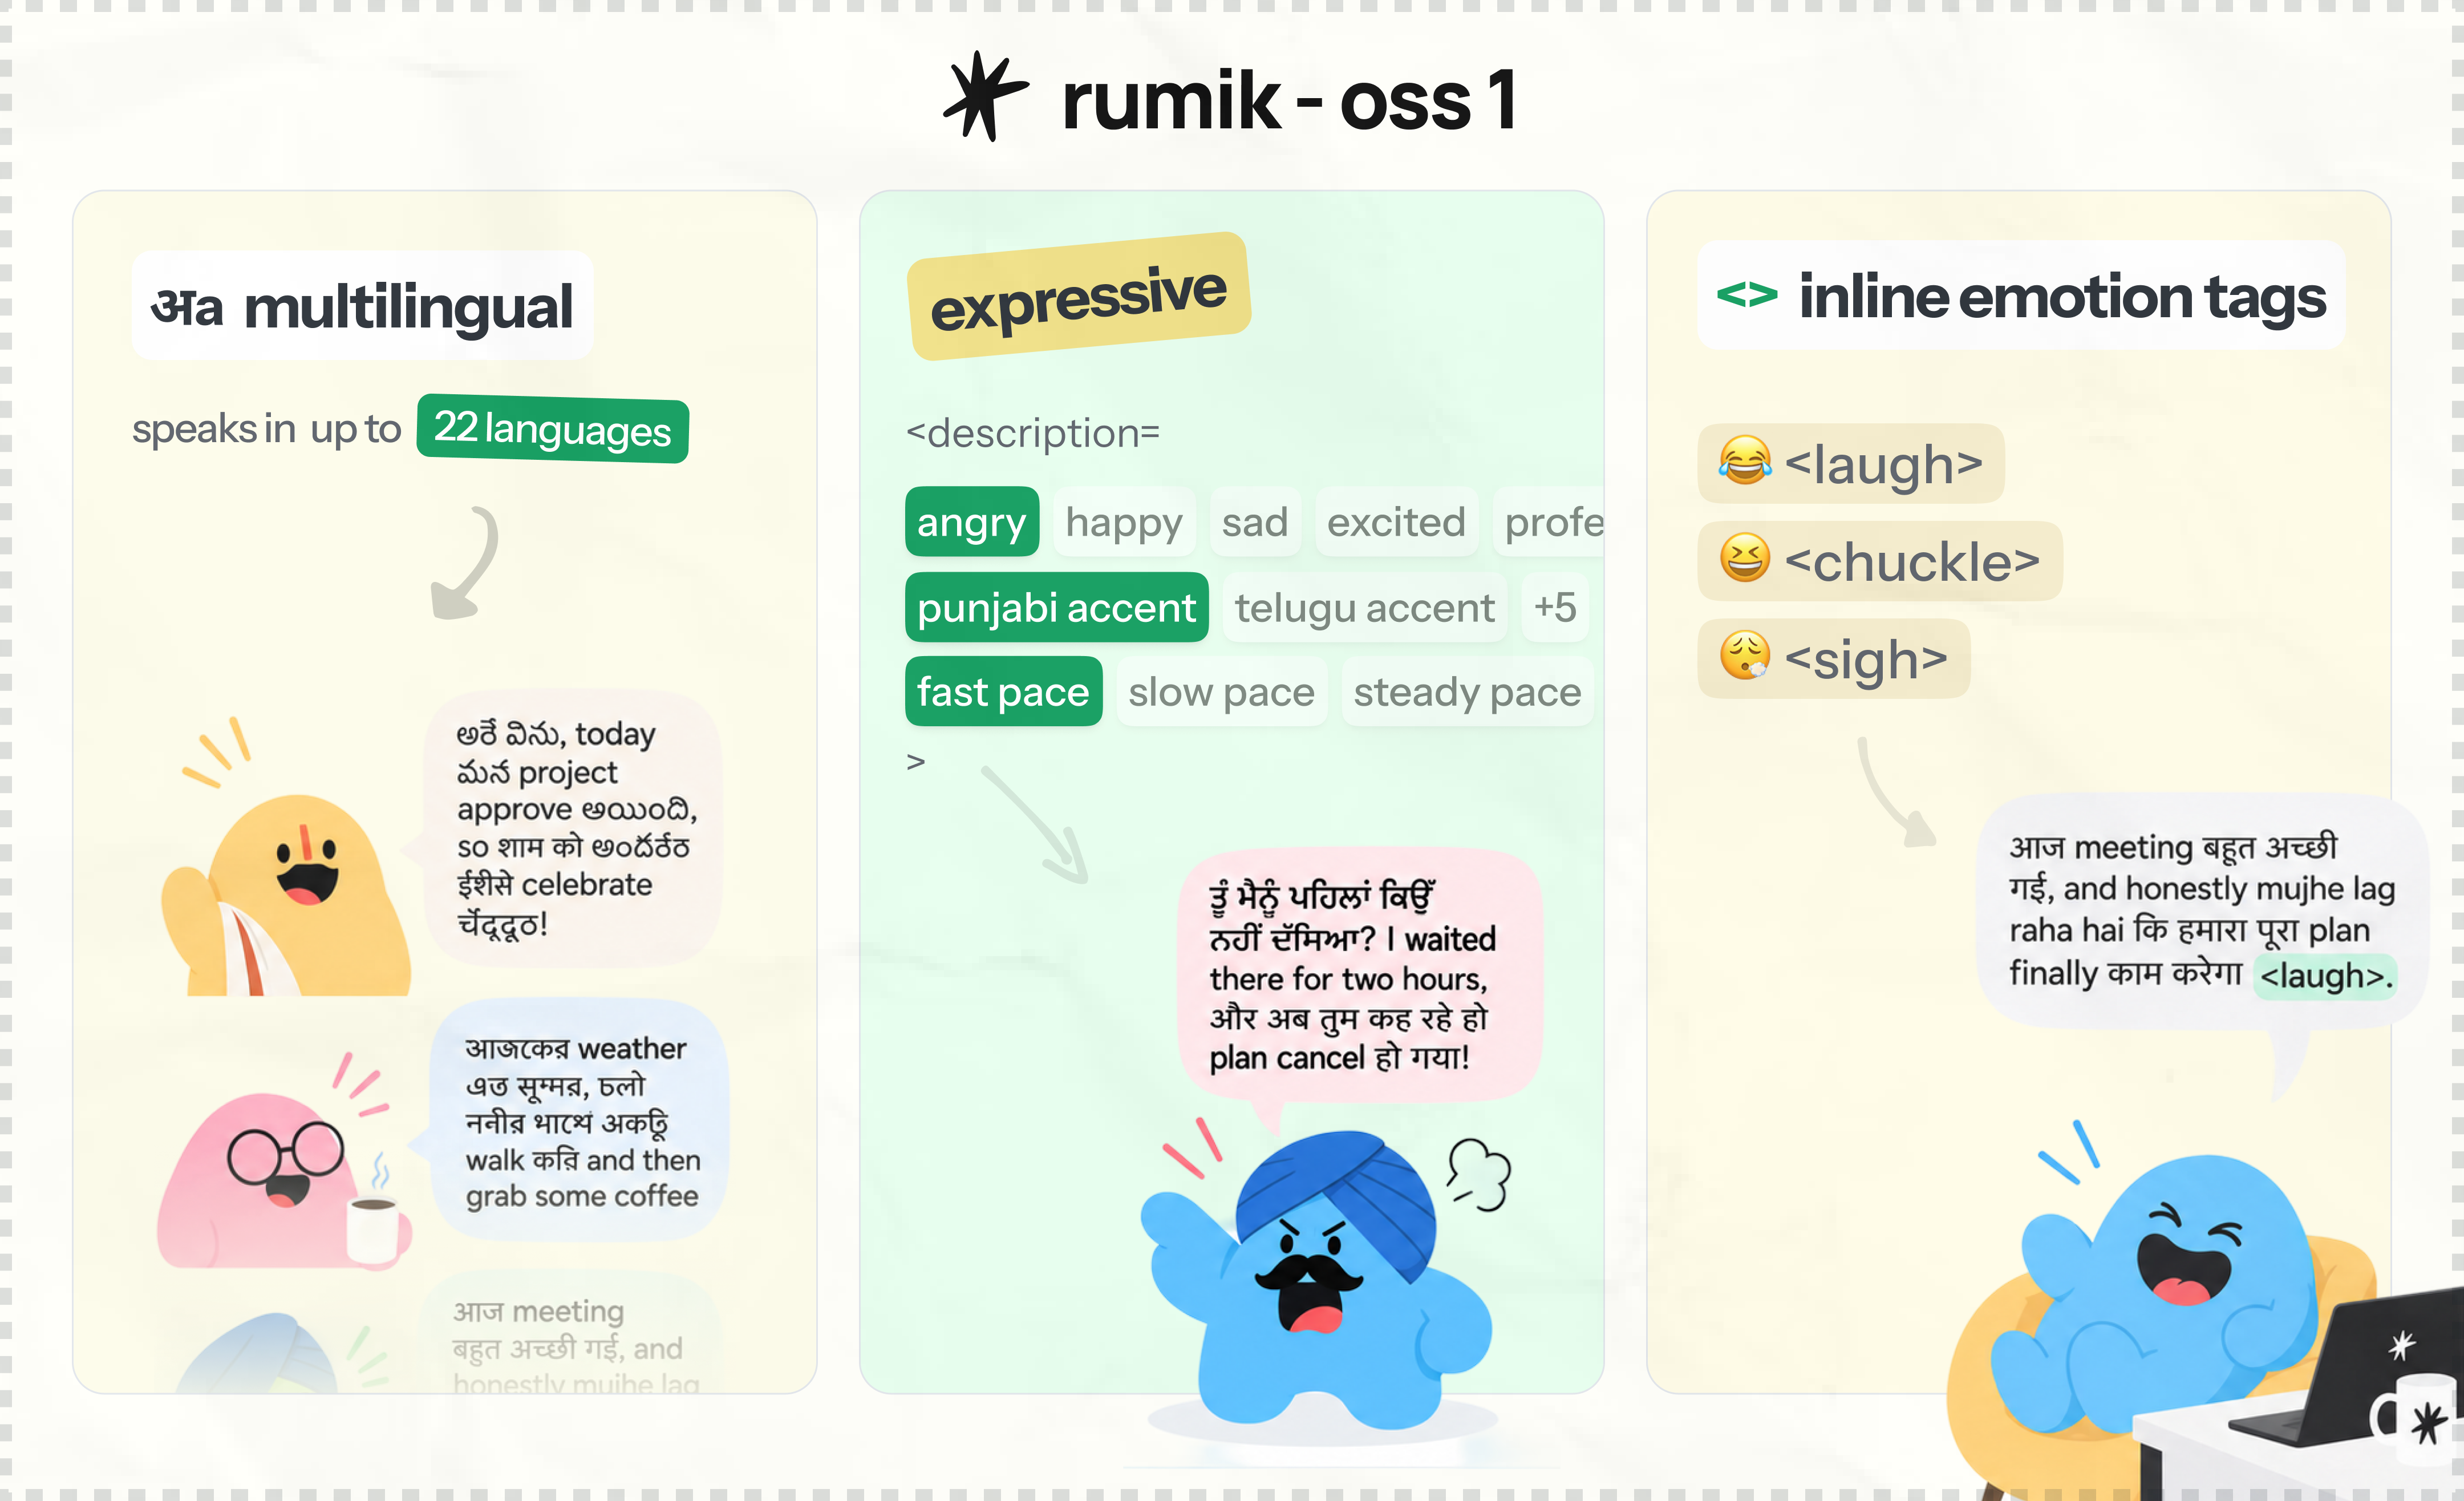
Les quatre voix livrées (Ira, Aisha, Siya, Zoya) s'expriment chacune dans les 22 langues, contrairement aux modèles TTS qui lient une voix à une seule langue. Un préfixe <description="..."> contrôle le ton (heureux, triste, en colère, excité, professionnel), l'accent et le débit, et des balises intégrées placent rires, gloussements et soupirs à des mots précis :
<description="excited, Hindi accent, fast pace"> जल्दी आओ, हमारा नाम लिस्ट में है! <laugh> आज घर में जश्न होगा।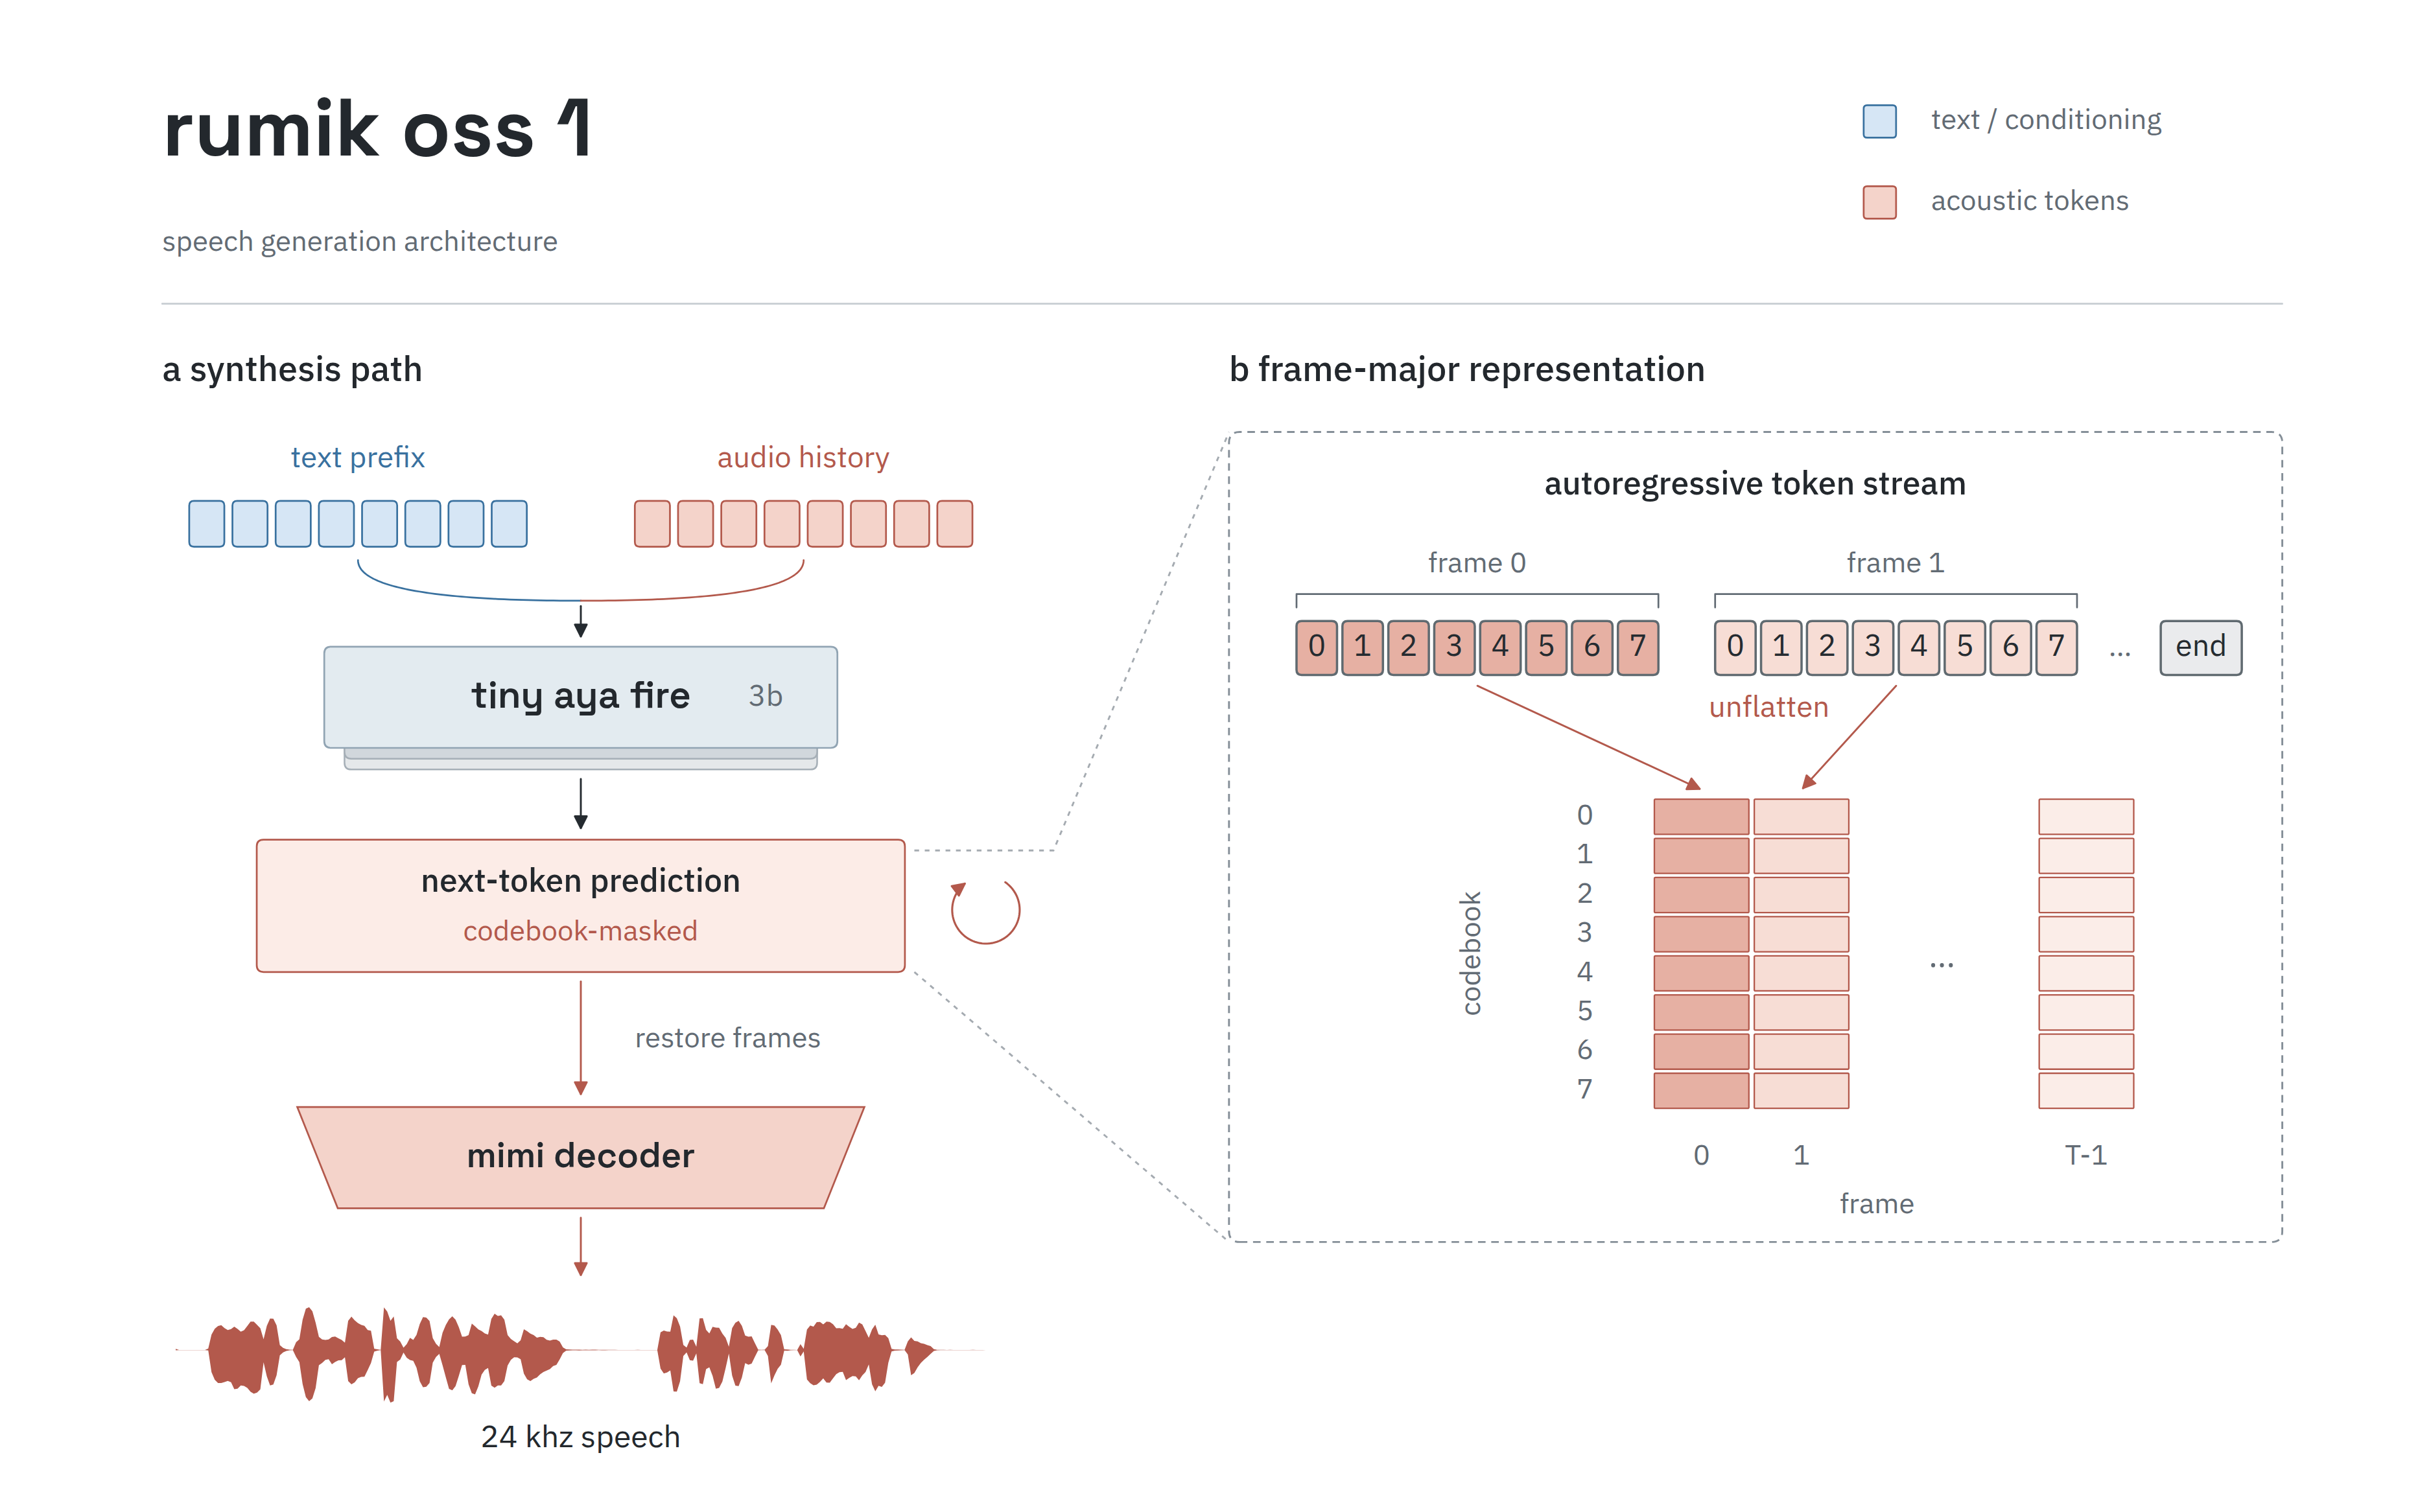
Architecture : prédiction de tokens de codec en frame-major, décodée par le décodeur mimi gelé.
Benchmarks
L'équipe a publié trois nouveaux benchmarks en même temps que le modèle, tous avec code public et résultats par échantillon :
| Benchmark | Ce qu'il mesure | rumik-oss 1 | Meilleur système |
|---|---|---|---|
| IndicEmo | Diction expressive dans la parole avec alternance de langues | 2,92 / 5 | Gemini 3.1 Flash TTS (4,58) |
| NoVA | Rendu correctement positionné des vocalisations intégrées | 0,884 | Grok TTS (0,972) |
| WER/CER | Fidélité de transcription sur 15 langues | rapporté par langue | voir le README |
Sur NoVA, rumik-oss 1 place les rires et soupirs demandés aux bonnes positions de mots de manière plus fiable qu'ElevenLabs v3 (0,705) et Gemini 3.1 Flash TTS (0,664), n'étant devancé que par Grok TTS et Inworld tts-2. Les exemples audio du README présentent les quatre voix en hindi, anglais, télougou, tamoul, bengali, kannada et pendjabi, y compris la génération avec alternance hindi-anglais et télougou-anglais.
Limites
Les énoncés d'entraînement ne dépassent pas 30 secondes ; l'équipe ne recommande donc pas de générer des énoncés de plus de 35 secondes, et des vocalisations non demandées apparaissent dans 2,9 à 5,4 % des sorties. Les tokens audio doivent être décodés par le codec mimi fourni ; le chemin standard transformers.pipeline("text-to-speech") n'est pas pris en charge.
Disponibilité
Les poids sont sur Hugging Face sous licence CC-BY-NC 4.0 (recherche et usage non commercial) avec le codec mimi sous licence séparée, plus une version quantifiée MLX pour Apple Silicon. Un Hugging Face Space propose des démos interactives. Il n'existe pas encore d'intégration ComfyUI native ; le modèle cible l'inférence Python via l'exemple de génération one-shot du référentiel.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.